3.4 文本生成与采样
3.4 文本生成与采样
本节摘要:训练完的模型能"写"了——但怎么写得自然、可控?本节讲清生成的机制(自回归逐词生成)、采样策略(贪心、温度、top-k、top-p)如何影响输出质量,以及"温度和 top-k 是创作自由度旋钮"的核心直觉。
你能学到什么
阅读完本节,你应当能够:
- 解释自回归生成的机制
- 区分贪心与随机采样
- 理解温度参数的作用
- 掌握 top-k 与 top-p
- 调出想要的生成风格
一、问题与直觉
模型训练时学的是"预测下一个词",生成时就用这个能力:给定开头,逐词预测、逐词接上。但"每次都选概率最高的词"会得到重复无聊的文本——所以需要"采样":按概率随机挑,让生成更自然、更有创意。温度与 top-k 就是控制"创意程度"的旋钮。
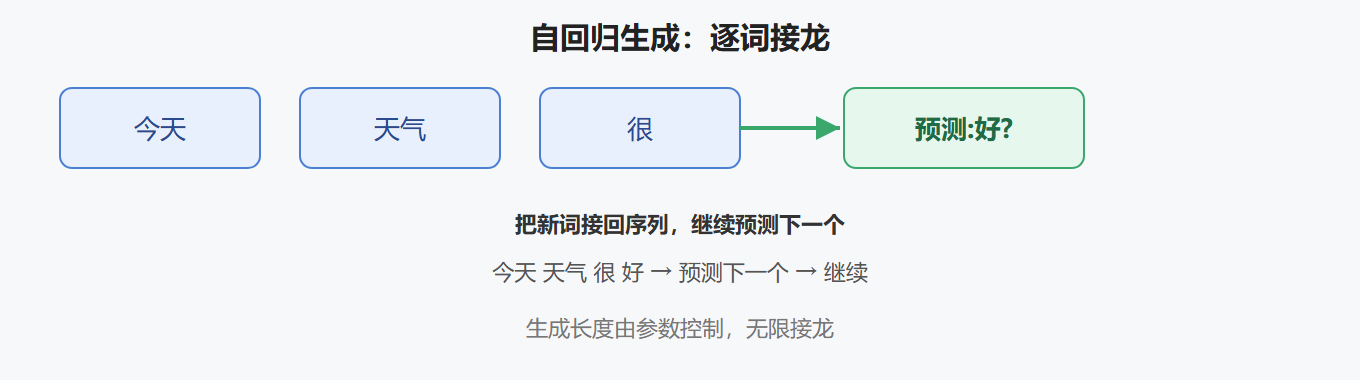
"自回归"这个词听起来高级,实际就是"自己回归自己":模型输出的下一部分,又作为输入喂回模型,循环往复。每一次只生成一个 token,生成 100 个 token 就要前向传播 100 次。
二、核心原理
采样策略决定生成风格:
2.1 自回归生成
2.2 采样策略对比
| 策略 | 做法 | 效果 |
|---|---|---|
| 贪心 | 每次都选概率最高 | 稳定但重复 |
| 温度采样 | 按概率随机挑 | 自然有变化 |
| top-k | 只在概率前 k 里挑 | 控制范围 |
| top-p | 只在累计概率 p 里挑 | 动态范围 |
2.3 生成的核心代码
# model.py 的 generate 方法(精简) @torch.no_grad() def generate(self, idx, max_new_tokens, temperature=1.0, top_k=None, top_p=None): for _ in range(max_new_tokens): # 只取最后 block_size 个 token,保持上下文长度 idx_cond = idx if idx.size(1) <= self.config.block_size \ else idx[:, -self.config.block_size:] logits, _ = self(idx_cond) # 前向传播 logits = logits[:, -1, :] # 只要最后一个位置 logits = logits / temperature # 温度缩放 # top-k:只保留概率最高的 k 个候选 if top_k is not None: v, _ = torch.topk(logits, min(top_k, logits.size(-1))) logits[logits < v[:, [-1]]] = float("-inf") # top-p:按累计概率过滤(nucleus sampling) if top_p is not None: probs = torch.softmax(logits, dim=-1) sorted_probs, idx_sorted = torch.sort(probs, descending=True) cumsum = torch.cumsum(sorted_probs, dim=-1) mask = cumsum - sorted_probs > top_p sorted_probs[mask] = 0.0 probs = probs.scatter(-1, idx_sorted, sorted_probs) logits = torch.log(probs + 1e-10) # 从调整后的分布中采样一个 token probs = torch.softmax(logits, dim=-1) idx_next = torch.multinomial(probs, num_samples=1) idx = torch.cat((idx, idx_next), dim=1) # 接回序列 return idx
这段代码是采样策略的"完全体":温度、top-k、top-p 都在里面。理解它,你就能精确控制生成行为。
三、工程实践要点
3.1 温度的作用
温度是"创意旋钮":
温度低(0.2-0.5):保守稳定,重复多 温度中(0.7-1.0):自然多样,推荐 温度高(1.5+):天马行空,容易乱
💡 关键直觉:温度调"敢不敢冒险"——低温度只选稳的,高温度乱试。写代码要稳用低温,写故事要活用中温。
3.2 top-k 与 top-p 配合
top-k=50:只从前 50 个候选里挑(去长尾) top-p=0.9:只从概率合计 90% 的候选里挑(自适应) 两者可叠加,先用 top-p 更常见
top-p(又称核采样)之所以"自适应",是因为候选数量会随上下文变化:某些位置概率很集中,保留的候选少;某些位置概率分散,保留的候选多。比固定 top-k 更灵活。
3.3 生成命令与效果示例
python sample.py --out_dir=out-shakespeare --start="ROMEO:"
用训练好的莎士比亚模型,输出大致是:
ROMEO: What light through yonder window breaks? It is the east, and Juliet is the sun! Arise, fair sun, and kill the envious moon, Who is already sick and pale with grief,
这不是背下来的台词,而是模型根据学到的语言规律现场"编"的——用词、韵律、标点都模仿了莎剧风格。用不同温度再跑几次,输出的差异能直观展示采样参数的作用。
python sample.py --out_dir=out-shakespeare --start="ROMEO:" --temperature=0.2 python sample.py --out_dir=out-shakespeare --start="ROMEO:" --temperature=1.2
温度 0.2 时输出保守重复,温度 1.2 时输出跳脱甚至乱来——同一个模型,风格完全不同的生成,这就是采样旋钮的威力。
⚠️ 常见坑:模型没训好就急着生成。刚开始训练时输出是乱码,别怀疑环境——这是正常的,等损失降下来再生成,效果自然好。
3.4 调出想要风格的流程
先默认参数(温度1.0)看效果 文本太平 → 降温度或升top-k 太乱 → 降温度或降top-p 重复多 → 升温度
3.5 长文本生成的注意点
生成几百 token 时,模型可能开始重复或跑题,这是自回归模型的常见问题。应对手段:适当调高温度打断重复;或者分段生成后人工拼接。理解"生成质量有上限",也是训练评估的一部分。
3.6 温度背后的数学直觉
温度不是玄学,它直接改写概率分布的形状:
logits 除以 temperature 后再做 softmax 温度 > 1:分布变平,低概率词也有机会 温度 < 1:分布变尖,高概率词更突出 温度 → 0:退化成贪心(只选最高)
这个视角解释了为什么"低温稳定、高温发散":温度改变了分布的"尖锐程度",进而改变了采样的冒险倾向。想精细控制输出时,可以先固定 top-p,再微调温度。
3.7 采样参数的推荐起点
| 场景 | 温度 | top-p | 说明 |
|---|---|---|---|
| 代码补全 | 0.2-0.4 | 0.5-0.8 | 保守,减少语法错误 |
| 一般对话 | 0.7-1.0 | 0.9 | 自然平衡 |
| 创意写作 | 1.0-1.2 | 0.9-0.95 | 更多变化 |
| 研究探索 | 1.2-1.5 | 0.95 | 激进但易乱 |
注意这些是起点不是终点:同一个模型、同一个任务,最优参数要自己跑几次对比才能确定。
3.8 生成与训练的互相验证
生成质量反过来能暴露训练问题:
输出全是高频词 → 训练不足或温度太低 输出语法崩坏 → 数据质量差或模型太小 输出句式单一 → 训练数据风格单一 输出突然跑题 → 上下文太长,模型记不住开头
用"生成当测试"的思路,训练和数据的问题往往一眼就能看出来——这是比损失数字更直观的反馈。
本章回顾
- 要点一:生成 = 自回归逐词预测接龙
- 要点二:贪心稳定但重复,采样自然有变化
- 要点三:温度是"创意旋钮",低稳高活
- 要点四:top-p 是主流的范围控制
- 要点五:写代码用低温,写故事用中温
- 要点六:模型没训好生成是乱码,正常
生成会了,下一节拧旋钮——配置文件与参数调整。