第4章 · 性能、复现与优化
第 4 章 · 性能、复现与优化
章节摘要:跑通只是第一步,本章解决"跑得好"。先看如何复现 GPT-2 124M(NanoGPT 的招牌成就),再算训练硬件与效率的账,然后学习优化策略(Modded-NanoGPT 的思路),最后了解性能基准怎么看。学完本章,你能规划并执行一次像样的训练实验。
本节导航
阅读完本章,你应当能够:
- 复现 GPT-2 124M 的训练
- 估算训练所需的硬件资源
- 应用常见的优化策略
- 读懂性能基准
- 规划自己的训练实验
核心概念速览
一句话记住本章:"复现"验证正确性,"优化"提升效率——先复现(确保没跑偏),再优化(跑得更快更省)。
性能优化全景
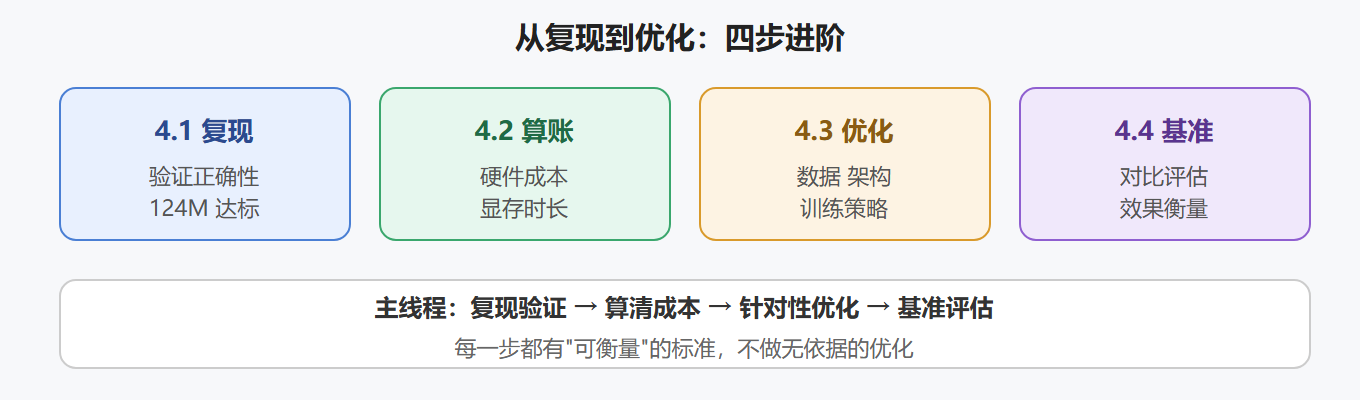
本章的逻辑链条
第 3 章跑通了流程,但"跑通"和"跑得好"之间还有很大距离。本章按"验证 → 算账 → 提速 → 评估"组织:
| 小节 | 回答的问题 | 关键工具 |
|---|---|---|
| 4.1 GPT-2 124M 复现 | 我的实现对不对? | 论文损失对照 |
| 4.2 训练硬件与效率 | 我该用多大资源? | 显存与时长估算 |
| 4.3 优化技术与策略 | 怎么跑得更快更好? | Modded 思路与训练技巧 |
| 4.4 性能记录与基准 | 怎么判断有没有变好? | 实验记录表与困惑度 |
这一章特别强调"数据意识":每个结论都要有数字支撑。比如"优化有效"不是感觉,而是损失从 3.2 降到 3.0 的记录。养成这个习惯,你的实验能力会上一个台阶。
子章节导航
4.1 GPT-2 124M 复现
复现的意义、资源需求与步骤——NanoGPT 的招牌成就。
4.2 训练硬件与效率
显存、算力、时长的账怎么算——训练成本核算。
4.3 优化技术与策略
Modded-NanoGPT 的思路:数据、架构、训练的优化点。
4.4 性能记录与基准
怎么看基准、怎么对比实验效果。
子章节之间的逻辑关系
复现(4.1) → 算账(4.2) → 优化(4.3) → 基准(4.4) 验证 成本 提速 评估
从"验证正确"到"评估效果",四节构成一次严谨训练实验的完整闭环。
前置知识与后续延伸
- 前置:第 3 章的完整实践能力
- 为后续延伸:性能思路与第 5 章生态演进(Modded-NanoGPT)衔接
本章检验清单
读完本章,你应该能完成一次"最小闭环":
- 用缩水配置(小模型 + 小数据)复现一条下降的损失曲线
- 估算出你的机器训练 124M 模型大约需要的显存与时长
- 做一次单变量优化实验(如只改学习率),并用记录表给出结论
做到这三点,你就掌握了独立设计训练实验的基本功。
评论区
(0)
U