4.1 GPT-2 124M 复现
4.1 GPT-2 (124M) 复现
本节摘要:复现 GPT-2 124M 是 NanoGPT 的招牌成就——用开源代码重现论文报告的效果。本节讲清复现的意义(验证实现正确)、资源需求(8×A100 或等效)、步骤流程(数据、配置、训练、对比),以及"损失达到论文值"的验收标准。
核心问题
阅读完本节,你应当能够:
- 说出复现的意义
- 列出 124M 复现的资源需求
- 复述复现的步骤
- 理解"损失达标"的验收标准
- 判断自己能否承担复现成本
一、问题与直觉
"凭什么相信 NanoGPT 实现是对的?"——复现就是证据:用它的代码,喂同样的数据,得到论文报告的损失。GPT-2 124M 是官方验证的里程碑,损失达到约 3.1(OpenWebText 上)就证明实现正确。复现不是炫技,是"验证"。
复现的价值还在于它"校准"了你的实验能力:数据、配置、训练、评估全链路走一遍,每个环节都会遇到真实问题,解决它们本身就是最大的收获。
二、核心原理
2.1 复现的意义
复现的验收标准是一条清晰的"达标线":
复现成功 = 实现正确 + 流程掌握 + 基线建立,三重收获。
2.2 资源需求
| 资源 | 需求 |
|---|---|
| 算力 | 8×A100(官方配置) |
| 数据 | OpenWebText |
| 时间 | 约 4 天(8×A100) |
| 替代 | 更少卡更久,或多卡小模型 |
⚠️ 常见坑:个人设备硬复现 124M。8×A100 不是个人配置——没那个算力就用"缩水复现":小模型 + 小数据,验证流程与思路,不追求论文数值。
2.3 复现用的真实配置
# config/train_gpt2.py 的关键参数 # 模型规模与 GPT-2 论文一致 n_layer = 12 n_head = 12 n_embd = 768 block_size = 1024 vocab_size = 50257 dropout = 0.0 # 训练规模 batch_size = 12 gradient_accumulation_steps = 40 # 等效总批次 12×40×8 = 3840 max_iters = 600000 learning_rate = 6e-4 min_lr = 6e-5 warmup_iters = 2000
注意梯度累积的用法:每张卡 batch_size 12,累积 40 步,8 张卡,等效总批次达到 3840 个样本——这个"大批次"是复现 GPT-2 训练曲线的重要一环。
三、工程实践要点
3.1 复现步骤
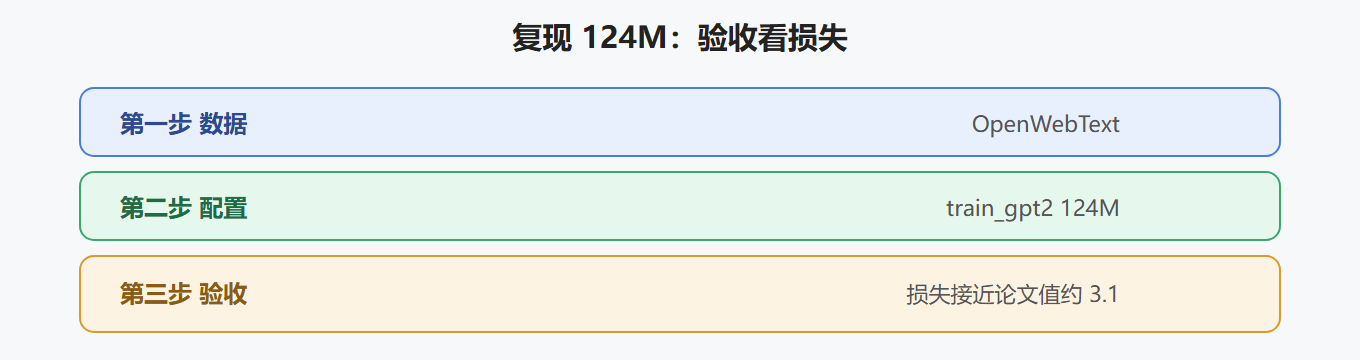
第一步 准备数据:OpenWebText(或替代数据集) 第二步 选配置:train_gpt2.py(124M 参数) 第三步 启动训练:多卡 + 记录损失 第四步 对比验收:损失是否接近论文值
3.2 数据准备的开销
OpenWebText 是 GPT-2 论文使用的 800 万网页数据集的复刻版,下载与预处理都比较耗时(数十 GB 量级,需要跑清洗与 BPE 分词)。个人复现时常见替代:
| 替代方案 | 优点 | 代价 |
|---|---|---|
| 直接用 OpenWebText | 与论文最接近 | 下载与预处理成本高 |
| 用 The Pile 子集 | 质量高、好下载 | 与论文数据不同 |
| 自己攒文本 | 灵活 | 效果不确定性大 |
想验证"实现正确",数据不同也能参考,只是验收数值会偏移——重点看损失曲线形状是否正常。
3.3 验收标准
论文值:GPT-2 124M 在 OpenWebText 上约 3.1 损失 达标:训练损失接近该值 = 复现成功 偏差大:检查数据、配置、实现
💡 关键直觉:损失是复现的"考卷"——数值对齐,说明每个细节都对;对不齐,回头查数据与配置,是排错的最好指引。
3.4 缩水复现方案
目标:验证流程而非复现数值 做法:小模型(如 10M 级)+ 小数据集 验证:损失持续下降 + 生成有样子 结论:流程正确,放大即可
具体操作示例:用莎士比亚数据 + 6 层 384 维配置,几百步训练就够验证"代码链路正确"。想要更接近论文的体验,可以把莎士比亚换成更大一点的文本语料,把模型加到 124M 规模的配置——但序列长度和批次按显存下调。
3.5 复现中的常见偏差
| 现象 | 可能原因 |
|---|---|
| 损失比论文高 0.3+ | 数据不同 / 批次不同 / 训练步数不够 |
| 损失突然 NaN | 学习率过大或数据有脏值 |
| 验证损失震荡 | 评估批次太小,噪声大 |
| 生成乱码 | 还没训够,继续训练 |
3.6 复现后的进阶
复现成功后的自然延伸:
- 换数据集训练(中文语料)
- 调参实验(学习率、模型规模)
- 对比优化(第 4.3 节策略)
3.7 复现成本的一个算例
以 8×A100 跑 4 天估算成本,帮你建立"复现有多贵"的直觉:
8 张 A100 × 4 天 = 约 800 卡时 按时租价格折算,约 2000 到 5000 美元 个人单卡 4090:约 20-30 天,且显存要吃紧 缩水复现:单卡 1-2 天即可
这个算例不是劝退,而是帮你做"预算决策":完整复现是团队级任务,个人学习者用缩水方案验证流程即可。预算有限时,把钱花在"一次结构完整的缩水复现"上,性价比远高于"半途而废的完整复现"。
3.8 训练曲线的预期形态
复现 124M 时,损失曲线的正常形态值得提前知道:
前 2000 步(warmup):损失快速下降 中期(几万步):稳步下降,偶有波动 后期(几十万步):下降趋缓,逼近论文值
如果曲线形态与这个预期差异很大,往往不是运气问题,而是配置或数据有偏差。用曲线形态做"健康检查",比只看终点数值更可靠。
要点速记
- 要点一:复现 = 用代码重现论文效果,验证实现
- 要点二:124M 资源需求——8×A100、OpenWebText、约 4 天
- 要点三:损失对齐论文值 = 复现成功
- 要点四:没算力就缩水复现,验证流程
- 要点五:损失是复现的考卷,偏差回头查数据配置
- 要点六:复现后自然延伸——换数据、调参、优化
复现验证了正确性,下一节算清成本——训练硬件与效率。