2.1 整体架构与数据模型
2.1 整体架构与数据模型
本节摘要:数据模型是 Qdrant 一切功能的起点。它把"一个业务实体"抽象成放进集合里的点,每个点带一串向量和一个载荷:向量负责语义相似,载荷负责结构化过滤。本节讲清集合、点、向量、载荷四个核心概念,以及距离度量(余弦、欧氏、点积)该如何选。理解这一层,后面的索引、查询、存储才有落脚的地方。
核心问题
阅读完本节,你应当能够:
- 说出集合、点、向量、载荷各自的职责,以及它们之间的包含关系。
- 判断一个业务场景该用余弦相似度、欧氏距离还是点积。
- 解释为什么集合内所有向量的维度必须一致,且创建后不可改。
- 描述载荷在过滤和结果展示中扮演的角色。
- 用段的概念理解 Qdrant 底层如何组织写入与更新。
一、问题与直觉:先把"东西"怎么摆说清楚
在使用 Qdrant 之前,我们得先回答一个看似无聊的问题:一条数据,到底长什么样?这个问题在关系型数据库里好回答——一张表,几列,每列有类型。可到了向量数据库,数据不再是一行行整齐的字段,而是"一串数字 + 一堆标签"的混合体。如果我们不把这个混合体定义清楚,后面建索引、写查询、做过滤,全都会变成猜谜。
我在接触向量数据库时踩过的一个坑,就是把向量和它的元数据混着放。比如把商品的价格直接拼进向量里,以为模型能"学"到价格。结果搜索"便宜的跑鞋"时,模型更关心"跑鞋"这个语义,价格那一维早就被淹没在几百维里了。教训很直接:语义交给向量,业务属性交给载荷,两者各管一摊,别互相越界。Qdrant 的数据模型,本质上就是把这条分界在结构层面固定下来。
所以这一节不急着讲 HNSW 或分布式,而是先把这个"摆放规则"讲透。它像仓库的货架设计:货架(集合)怎么分区、每件货(点)贴什么标签(载荷)、货物本身按什么编码(向量)存放。货架设计得不好,后面再怎么优化搬运路线都事倍功半。
二、核心原理:四个概念与一把尺子
Qdrant 的数据模型围绕五个词展开:实例、集合、点、向量、载荷。实例是最大的一层,一个实例可以装多个集合;真正要记的是下面四层。
整体架构:先看四层骨架
数据模型解决"数据长什么样",架构解决"数据怎么流转"。Qdrant 从外到内大致分四层。最外层是客户端层,Python、Go、Java 等 SDK 和 REST、gRPC 接口都归这里,它们只负责把请求送进来、把结果带出去,不碰底层索引。往里是服务端层,干三件事:解析请求、制定执行计划、合并排序结果。再往里是索引层,向量走 HNSW 图,载荷走关键字、数值、地理等结构,两边各查各的再协同。最底层是存储层,段、预写日志、快照、副本都在这儿,负责把数据稳稳落到磁盘。记住这四层,后面几节就是在往每一层里填细节。
集合:隔离的容器
集合是最高层的数据组织单元,类比关系型数据库里的表。每个集合有自己独立的配置:向量维度、距离度量、索引参数,以及分片副本策略。集合之间互不影响,这给了多租户和多应用一个天然的隔离边界。你可以让"用户画像"集合用 768 维余弦相似度,让"商品图片"集合用 512 维欧氏距离,两者井水不犯河水。
点:最小单元
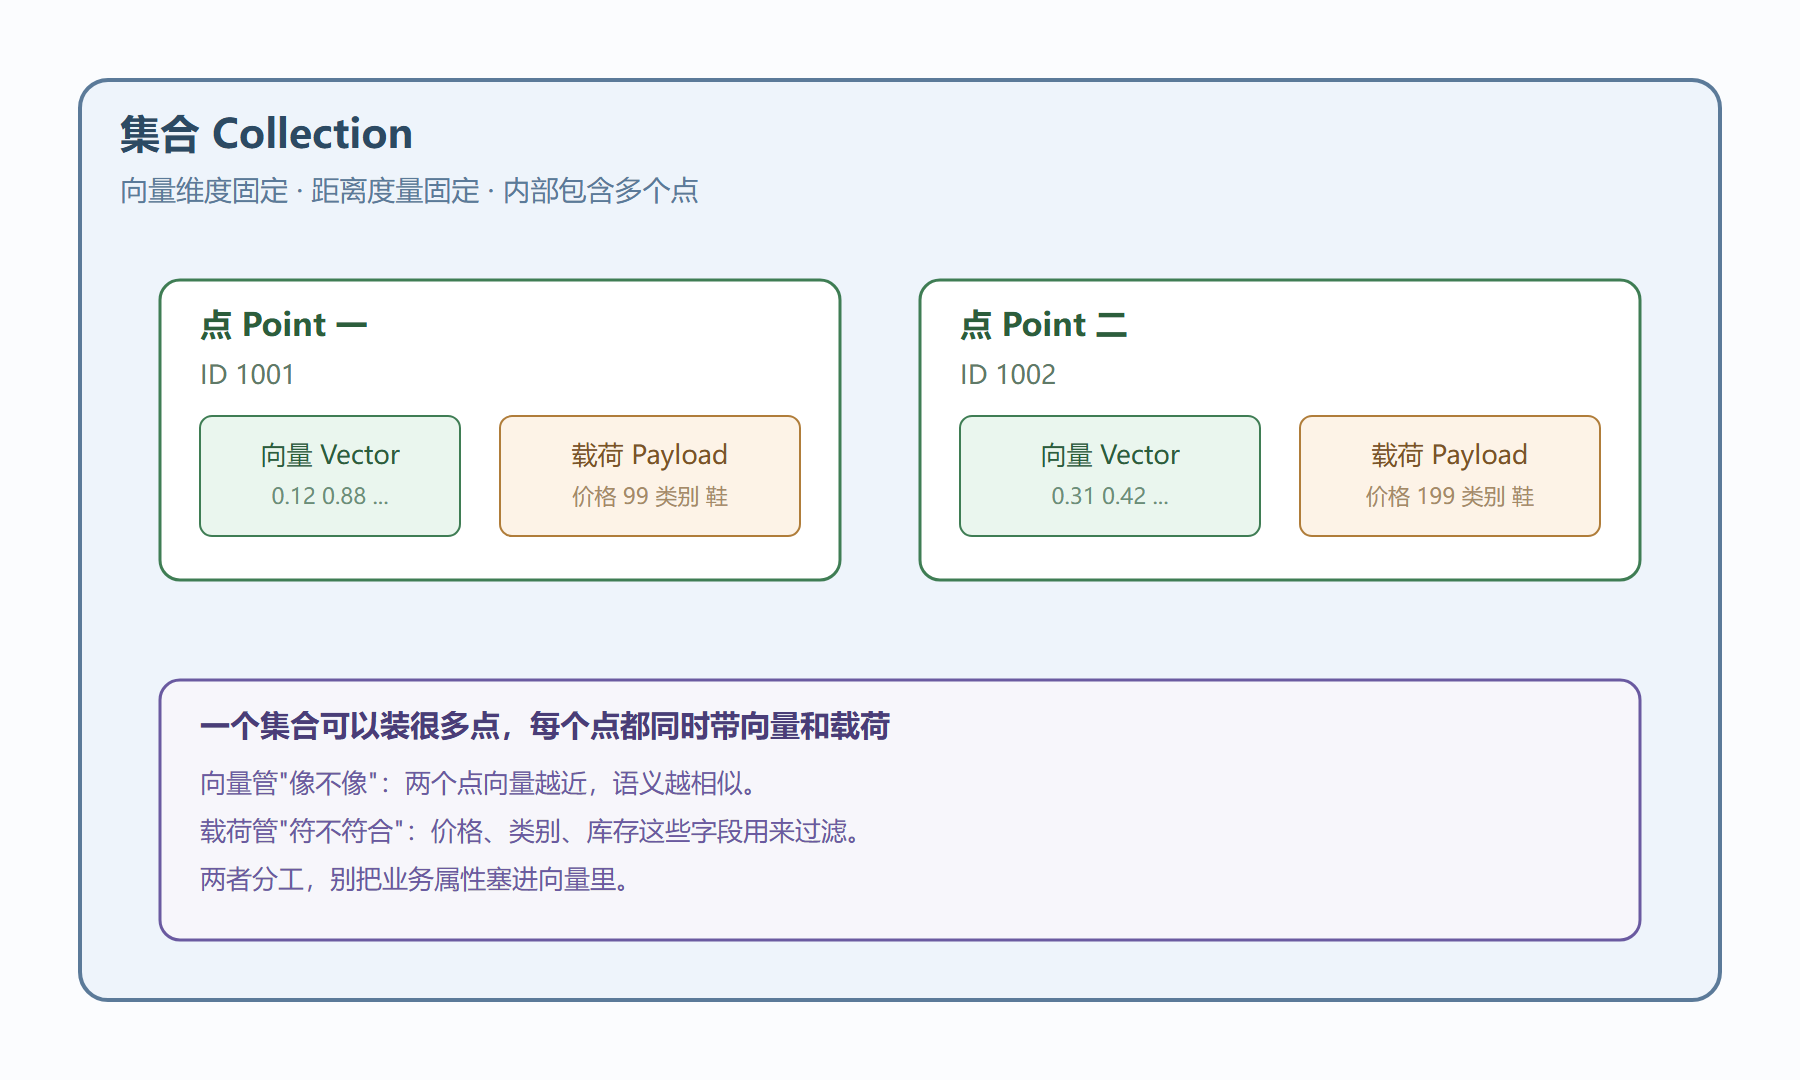
点是集合里最小、最基本的存储对象,也是搜索和过滤作用的对象。每个点由三部分组成:一个唯一 ID、一串向量、一个载荷。ID 可以是无符号整数或 UUID,它是精确定位某个点的钥匙;向量承载语义;载荷承载业务属性。
向量:语义的数字表达
向量是一串定长浮点数,代表某个实体(一句话、一张图、一段音频)经过嵌入模型压缩后的语义。两个向量在空间里的距离越近,它们代表的实体在语义上越相近。向量维度在集合创建时定死,之后不能改——这像仓库的货架每层高度是固定的,你中途换一种更高的货物就放不进去,只能新建一个集合。
载荷:贴在点上的标签
载荷是与向量关联的 JSON 格式元数据,可以存任意键值对。它有两个作用:一是在搜索结果里直接把业务字段带回来,省去二次查询传统数据库;二是作为过滤条件,让你在"语义相似"之外再加"价格低于一百"、"库存大于零"这类硬约束。载荷的字段可以按需建索引,关键字、数值范围、地理、全文这几种是常见的。
距离度量:那把"相似"的尺子
向量靠"距离"来比相似,但"距离"有好几种算法,选错了会直接改变搜索结果。下面这张表是三种主流度量的取舍。
| 度量方式 | 关注点 | 取值范围 | 典型场景 | 一句话判断 |
|---|---|---|---|---|
| 余弦相似度 | 方向,不看长度 | 负一到正一 | 文本语义、推荐 | 只看"方向像不像" |
| 欧氏距离 | 空间直线距离 | 零到正无穷 | 图像特征、几何 | 对数值大小敏感 |
| 点积 | 方向兼长度 | 负无穷到正无穷 | 归一化向量的推荐 | 向量已归一化时约等于余弦 |
💡 关键直觉:如果你的嵌入模型输出的向量已经归一化(模长为 1),余弦相似度和点积在数学上等价,选哪个差别不大;如果模型没归一化、而且向量的"长度"本身有意义(比如某种强度),才该认真区分。多数文本嵌入模型默认归一化,所以"余弦相似度"是文本场景里最省心的默认项。
选度量还有一个实用判断:文本、推荐这类"只在乎方向"的场景用余弦;图像特征、聚类这类"数值大小本身有意义"的场景用欧氏;向量已归一化时点积和余弦等价,选哪个看模型习惯。拿不准就先拿余弦跑一版,再用一批真实查询做召回对比——度量选错,索引调得再好也救不回相关性,这是第一步就该敲定的事。
下面这张图把集合、点、向量、载荷的关系画在了一起,是我希望你在脑子里留下的一帧画面。
Collection 与 Point、Vector、Payload 的关系
段:底层看不见的组织方式
数据模型讲的是"逻辑上怎么摆",段讲的是"物理上怎么存"。Qdrant 底层并不把整个集合塞进一个巨大文件,而是拆成一个个不可变的小段。新写入先进内存里的可变段,攒到一定大小或时间就冻结成不可变段落盘。更新和删除不在原段上改动,而是在新段里记一笔,旧点标记为逻辑删除,再由后台合并把这些"墓碑"物理清掉。
这样做的收益很明显:读操作面向不可变段,写操作只碰可变段,读写互不阻塞;崩溃时结合预写日志能快速恢复;合并还能回收空间、减少扫描的段数。
三、工程实践要点:怎么把模型用对
距离度量要跟着模型走
选距离度量的第一原则不是"哪个更好",而是"你的嵌入模型是用什么训练出来的"。用余弦相似度训练出来的模型,你换成欧氏距离去检索,等于拿错误的尺子量长短。拿不准时,优先查模型文档里推荐的度量,其次是看向量是否归一化。
维度是创建时的一次性决定
维度写进集合配置后就锁死了。这意味着你不能今天用 768 维的模型、明天顺手换成 1024 维的模型还往同一个集合里塞——要么新建集合,要么重新嵌入。做模型升级时,这个约束会逼着你想清楚迁移方案。
载荷设计决定过滤效率
不是所有字段都该建索引。给每个字段都建索引,写入会变慢、内存会膨胀。真正高频出现在过滤条件里的字段才值得建索引,其余字段照样能存、能返回,只是过滤时走全扫描。先想清楚查询长什么样,再反推该给哪些字段建索引。字段的类型还决定了它能支持哪类过滤:字符串字段适合精确匹配和集合包含,数值字段适合范围,经纬度字段适合地理圈选。设计载荷时,别为了省事把数字存成字符串,那样范围查询和排序就用不起来了。
⚠️ 常见坑:把载荷里的大文本原样塞进去,还顺手建了全文索引,结果写入吞吐骤降。载荷适合放轻量、结构化的过滤字段;大段正文应该留在别处(或存摘要),向量和轻量字段才进 Qdrant。载荷不是文档存储的替代品。
什么时候新建集合
集合绑定维度、距离度量和索引配置,这意味着它是"模型加用途"的产物。同一批数据,如果换了嵌入模型、维度变了,就该新建集合,而不是往旧集合里硬塞;如果只是元数据字段增加、过滤条件变多,改载荷就行,不必动集合。把集合理解为"向量空间的边界"最直观:边界一变(维度变、度量变、向量数量变多),就开个新集合,宁可用多个小集合,也别让一个集合里混着几套不相容的向量。
下面这段概念代码展示了建集合时如何把"维度、距离度量、载荷索引"一次性定下来。
from qdrant_client import QdrantClient, models client = QdrantClient(":memory:") # 创建一个用余弦相似度的集合,维度 768 client.create_collection( collection_name="products", vectors_config=models.VectorParams( size=768, distance=models.Distance.COSINE, ), )
# 插入一个点:向量 + 载荷一起写 client.upsert( collection_name="products", points=[ models.PointStruct( id=1001, vector=[0.12, 0.88, 0.34], # 概念性演示,真实场景是完整 768 维 payload={"price": 99, "category": "shoes", "in_stock": True}, ) ], )
本章回顾
- 集合是隔离容器:一个集合绑定一套维度、距离度量和索引配置,集合之间互不干扰。
- 点是基本单元:由唯一 ID、向量、载荷三部分组成,是搜索和过滤作用的对象。
- 向量管语义:定长浮点数组,维度在创建时固定不可改,承载的是"像不像"。
- 载荷管业务:JSON 元数据,既用于过滤,也用于把业务字段直接带进结果。
- 距离度量要匹配模型:文本默认余弦,图像常配欧氏,归一化向量用点积近似等价于余弦。
- 维度是锁死项:换模型维度就得重建集合,升级前先想迁移。
- 载荷别当文档库用:放轻量过滤字段,按查询需求决定建不建索引。
- 段是底层组织:不可变小段 + 后台合并,换来读写分离和高效恢复。
下一节我们将看 Qdrant 的"心脏"——向量索引与相似度搜索,弄清 HNSW 这套多层小世界图是怎么让海量向量也能毫秒级返回最近邻的。