2.2 向量索引与相似度搜索
2.2 向量索引与相似度搜索
本节摘要:向量索引解决的是"海量向量里怎么快速找最近邻"。逐一比较的暴力搜索在百万级数据下就撑不住了,Qdrant 靠的是近似最近邻算法,其中 HNSW 是主力。它用一张多层小世界图,从稀疏的高层快速跳到目标区域,再下沉到密集的底层精细搜索,在"快"和"准"之间走钢丝。本节讲清 HNSW 的分层原理、距离度量的选择,以及 m、ef 这些参数到底在权衡什么。
本节地图
阅读完本节,你应当能够:
- 说清为什么暴力搜索在大规模向量上不可行,"维度灾难"卡在哪。
- 用"高层跳、底层搜"描述 HNSW 的分层搜索过程。
- 解释 m、ef_construction、ef_search 三个参数各自的代价。
- 区分标量量化、乘积量化、二进制量化在压缩率和精度损失上的差异。
- 理解近似最近邻"召回率与速度"这对永恒矛盾。
一、问题与直觉:为什么不能一个一个比
要找最近邻,最朴素的办法是拿查询向量和库里每一个向量都算一遍距离,再排个序。这个办法百分之百精确,但代价是每个查询都要扫全库。一百万条数据、每条 768 维,一次查询就是七亿多次乘加;数据涨到一亿,再快的 CPU 也要趴下。
更糟的是"维度灾难":维度越高,数据点在空间里越稀疏,任意两点的距离越来越"拉不开差距"——大家都差不多远,最近邻和随便一个点的区分度越来越低。这意味着你在高维空间里既算不动,又算不准。两个难题叠在一起,结论只有一个:必须放弃"绝对精确",换一种"足够好"的策略。这就是近似最近邻(Approximate Nearest Neighbor,简称 ANN)的由来。
可以把暴力搜索想象成在陌生城市里找一家店,你一家一家门牌对过去;ANN 则是先看地图跳到那个街区,再在街区里小范围找。前者保证找到,但慢到没法用;后者快,代价是偶尔漏掉一条藏在角落里的近路。对需要实时响应的系统,后者显然是更现实的选择。
ANN 的哲学很实在:我不保证找到的一定是全局最近的那个点,但我保证在极短时间里找到一个"足够近"的点。用一点点召回率的损失,换几个数量级的速度提升,这笔买卖在绝大多数实时应用里都划算。Qdrant 选的主力索引是 HNSW,它把这种"近似"做得很漂亮。
二、核心原理:HNSW 这张多层小世界图
HNSW 全称"分层可导航小世界图"。名字长,拆开就三件事:分层、可导航、小世界。它像一座立体的立交桥——高层是稀稀疏疏的快速路,能让你从城市一头瞬间跳到另一头;底层是密密麻麻的小巷,能让你精确走到某一户门口。
分层:从快速路到小巷
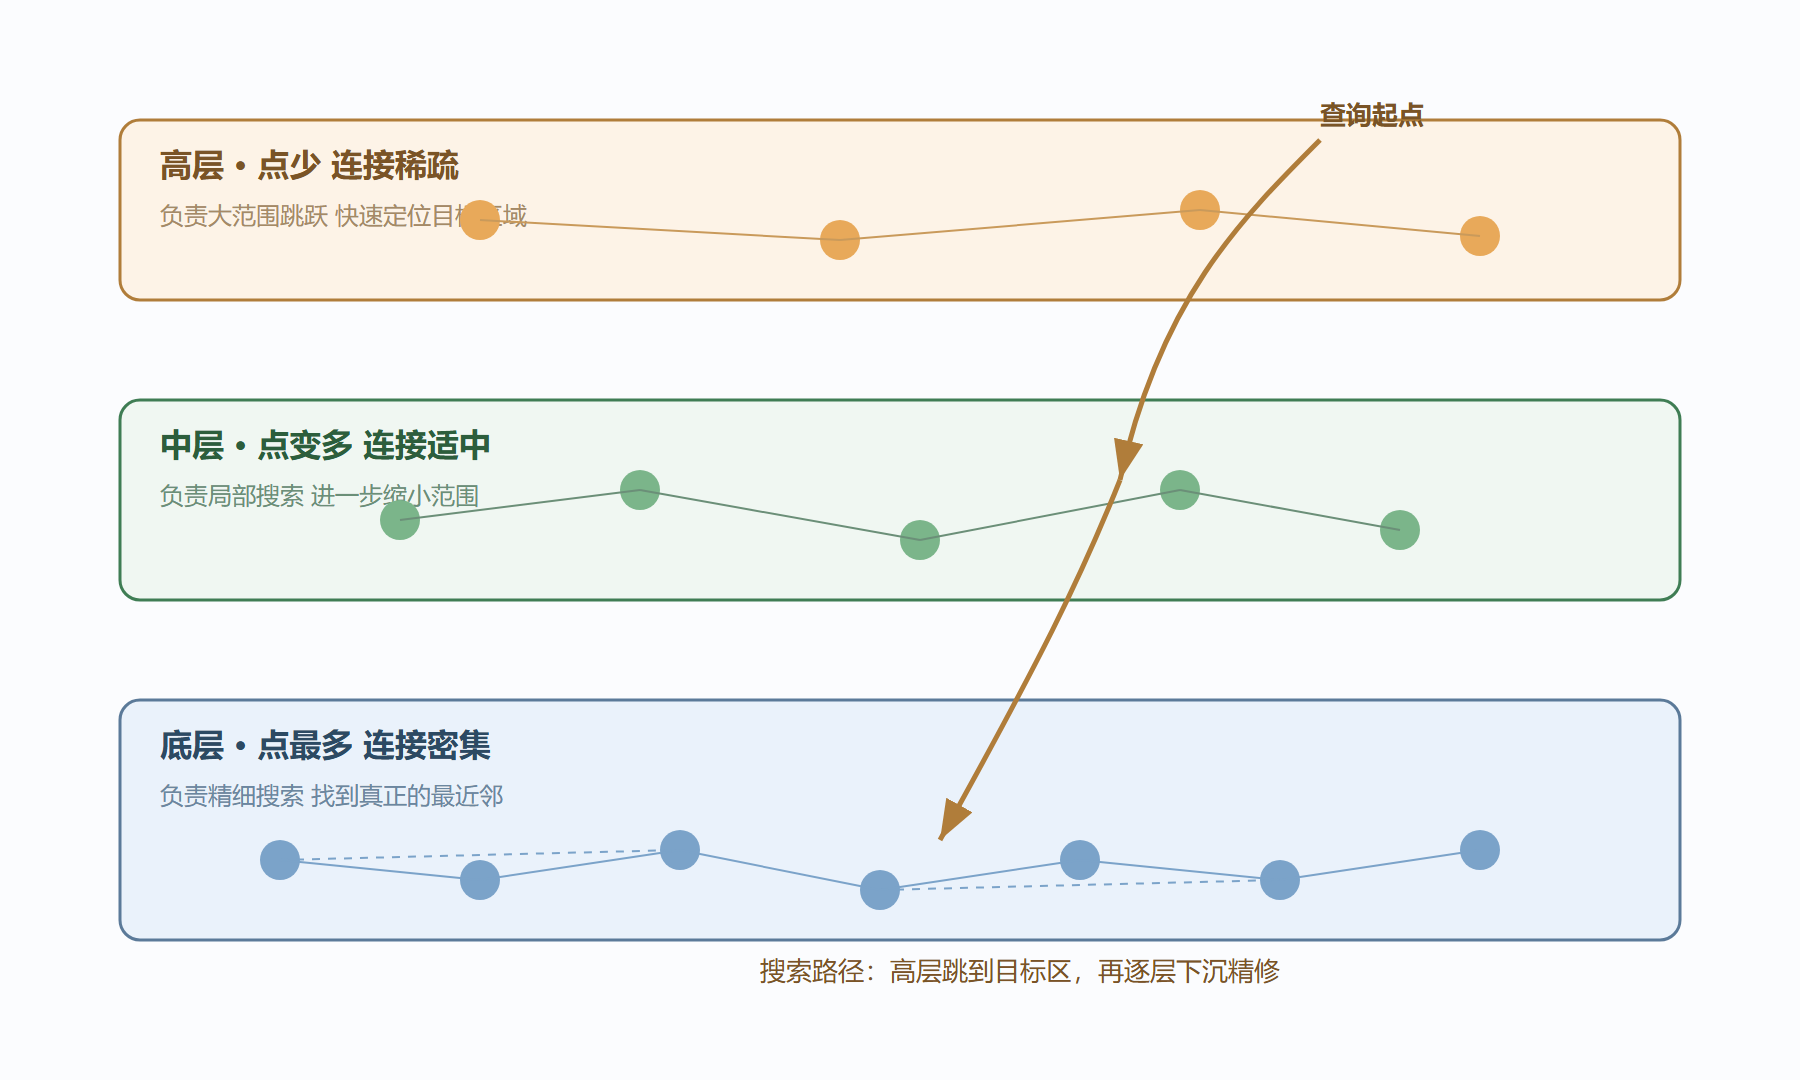
HNSW 建图时,每个新点会被随机分配一个层数,层数服从指数分布——绝大多数点只住在底层,极少数点能爬到高层。于是顶层只有寥寥几个"地标"点,连接稀疏,负责大范围跳跃;越往下点越多、连接越密,负责局部精修。搜索时从顶层某个入口点出发,贪心地往"离查询向量更近的邻居"走,走到本层走不动了,就带着当前的候选点下沉一层继续,直到最底层,最后返回 K 个最近邻。
下面这张图把"分层"画成了可视的横切面,注意层与层之间点的密度差异,以及搜索路径如何逐层下探。
HNSW 分层搜索示意
为什么它快,又为什么"近似"
HNSW 的快来自分层跳跃:查询不必扫全库,只要在高层迈几步、每层都只探访一小撮邻居,就能逼近目标。它的"近似"则来自贪心策略——每步都选当前看着最近的方向,偶尔会走进局部最优而错过全局最近。所以 HNSW 拿不到百分之百召回率,但参数调好时能逼近九成九以上,同时保持毫秒级延迟。
建图:层数与邻居怎么定
新点进图时,先按指数分布随机抽一个层数——抽到高层的概率很低,所以顶层点少、底层点密,这正是"高层快速路、底层小巷"的来源。然后从顶层开始逐层往下插入,每层都用贪心搜索找最近的几个邻居连边。连边不是单纯连最近的,而是用启发式在"近"和"分散"之间平衡,避免节点只抱团在局部,保证整张图连通、搜索时不走进死胡同。这里就是 m 参数管的地方——每个节点最多连多少邻居。
另一种思路:IVF 倒排文件
HNSW 不是唯一的近似最近邻方案。IVF 先用聚类把全库分成若干簇,每个簇有个中心向量;搜索时先算查询向量离哪些簇中心近,只钻进这几个簇里精搜。它省内存、可扩展,适合把向量放磁盘的场合,但召回依赖聚类质量——真正的近邻若落在没被选中的簇里,就直接漏掉了。Qdrant 主力是 HNSW,把 IVF 当对照理解它的"先选簇再精搜"逻辑,能帮你看懂不同索引在精度和内存上的不同取舍。
量化怎么省内存
量化不动图结构,而是压缩向量本体。标量量化把每个浮点分量映射成整数,精度损失小;乘积量化把高维向量切成若干段,每段各自量化,省得更多一点;二进制量化把分量二值化成零或一,最省但丢得最多。它们和 HNSW 可以叠加使用:图管"找得快",量化管"装得多"。内存吃紧时优先开标量量化,还不够再上乘积量化,二进制量化只留给对精度要求极低的场景。
怎么评估召回率
调参数不是拍脑袋,要有基准。挑一批真实查询,先用暴力搜索算出"标准答案",再让 HNSW 在同一批查询上跑,比较两者结果的重合比例,这就是召回率。用不同 ef_search 跑一遍,画出"召回率对延迟"的曲线,找那条曲线的拐点——过了拐点,再往上加 ef_search,召回提升很小、延迟却明显涨。拿数据说话,比背任何经验值都靠谱。测试用的查询要和线上真实查询同分布,用人工挑的"典型样本"测出来的召回率往往会虚高。
增量更新与索引生命周期
生产数据是活的,会不断插入、更新、删除。HNSW 支持增量插入新点,不必每次重建全量索引;但频繁更新和删除会留下"逻辑删除"的节点,图结构也会慢慢变脏,Qdrant 在后台做段合并时顺带清理。对大量一次性导入的场景,先导入再建索引通常比边导边建更快,具体取决于数据规模和更新频率。
小结:快与准的账怎么算
把 HNSW 的核心串起来看:它用一张分层图,把"全库逐一比较"变成"高层跳几步、底层精修几步",用可接受的召回损失换回数量级的提速。m 和 ef 系列参数,本质都是在调节这张图的密度和搜索的贪心程度——密度越高越准但越重,贪心越狠越快但越容易漏。理解这层账,比记住任何默认值都重要;参数会变,权衡的思路不会变。
三、工程实践要点:三个旋钮与一条压缩路线
HNSW 的性能由三个参数控制,理解它们的代价方向,比背默认值有用得多。
| 参数 | 含义 | 调大换来的 | 调大付出的 |
|---|---|---|---|
| m | 每个节点的最大邻居数 | 图更密 召回率更高 | 内存与构建时间上升 |
| ef_construction | 构建时每层搜索的候选数 | 索引质量更高 | 构建明显变慢 |
| ef_search | 查询时每层维护的候选数 | 召回率更高 | 查询延迟上升 |
💡 关键直觉:m 和 ef_construction 是"一次性"的成本,只在建索引时付;ef_search 是"每次查询"都付的成本。所以想提召回率,优先在构建端加大 m 和 ef_construction,把索引质量做足;查询端的 ef_search 留到线上再按延迟预算微调。别一上来就无脑加大 ef_search 让每次查询都变慢。
什么时候用 HNSW,什么时候考虑别的
如果数据量不大(几十万以内),暴力搜索配合精确结果反而简单可靠,HNSW 的优势不明显;数据上到百万、千万级,HNSW 的优势才真正拉开。若内存极度受限、数据又超大,可以把向量放磁盘、配合 IVF 或量化。选型先看数据规模和内存预算,再看召回要求,别一上来就默认 HNSW 一条路走到黑。
动手前先问自己三件事:数据多大、内存多少、召回要求多高。数据小就别折腾索引,直接用暴力搜索更省心;内存紧就上量化;召回要求高就先把构建端参数做足。把这三个数写下来,再决定用不用 HNSW、参数往哪调,比直接套网上现成的"最佳参数"可靠得多。很多看似玄学的调参,本质上都是这三件事在互相拉扯。
内存不够时,走量化
HNSW 图本身要占内存,向量本体也要占。数据量大到内存吃紧时,量化是另一条路线——牺牲一点精度,把每个浮点分量压成更少的比特。
| 量化方式 | 压缩思路 | 精度损失 | 适用场景 |
|---|---|---|---|
| 标量量化 | 浮点映射成整数 | 小 | 通用场景 首选 |
| 乘积量化 | 向量切段 每段各自量化 | 中 | 内存极省 大规模 |
| 二进制量化 | 分量二值化为零或一 | 大 | 空间优先 精度可让步 |
量化和 HNSW 不冲突,可以叠加使用:图结构负责"找得快",量化负责"装得多"。
⚠️ 常见坑:盲目加大 m 想提升召回率,结果内存先爆了。m 每加一点,图里的边数接近线性增长,内存和构建时间一起涨。正确做法是先用默认值跑通,再拿一小撮真实查询做召回率基准测试,按需微调,而不是凭感觉往大里调。
下面这段概念代码展示了一次带参数控制的搜索。
from qdrant_client import QdrantClient, models client = QdrantClient(":memory:") query_vector = [0.10, 0.55, 0.27] # 概念性演示 results = client.search( collection_name="products", query_vector=query_vector, limit=10, # 查询端放大搜索范围,换更高召回率 search_params=models.SearchParams(hnsw_ef=128), )
要点串联
- 暴力搜索不划算:全库逐一比距离,数据一大就扛不住,维度越高越难算、也越难分辨。
- ANN 用精度换速度:放弃绝对精确,换一个"足够近"的答案,换回几个数量级的提速。
- HNSW 是分层小世界图:高层点少、跳得快,底层点密、搜得准。
- 搜索走"高层跳、底层搜":从入口点贪心逼近,逐层下沉,最后在底层返回 K 个近邻。
- 三个参数各管一段:m 管图密度,ef_construction 管构建质量,ef_search 管查询精度。
- 召回率优先在构建端付:m 和 ef_construction 是一次性成本,ef_search 是每次查询都付。
- 内存吃紧用量化:标量、乘积、二进制三种量化按精度损失递增、省空间递增排列。
下一节我们把"找得快"再往前推一步,看看过滤条件怎么和向量搜索结合——这是 Qdrant 从"相似度引擎"变成"业务查询引擎"的关键一跃。