1.4 Supabase 的发展历程与社区生态
1.4 Supabase 的发展历程与社区生态
一段历史:2020 年,Paul Copplestone 和 Ant Wilson 在澳大利亚创立 Supabase,最初就是想做一个"开源的 Firebase"。他们没有从零造数据库,而是把 PostgREST、GoTrue(认证)、Realtime、Storage 这几个开源项目用 Kong 网关和 PgBouncer 连接池拼起来,外面包一层好看的 Dashboard。这个"集成而非发明"的起步,决定了它后来的全部性格。这一节我们顺着时间线看它怎么长大,以及社区怎么反哺它。
先给一张全景图:演进三阶段
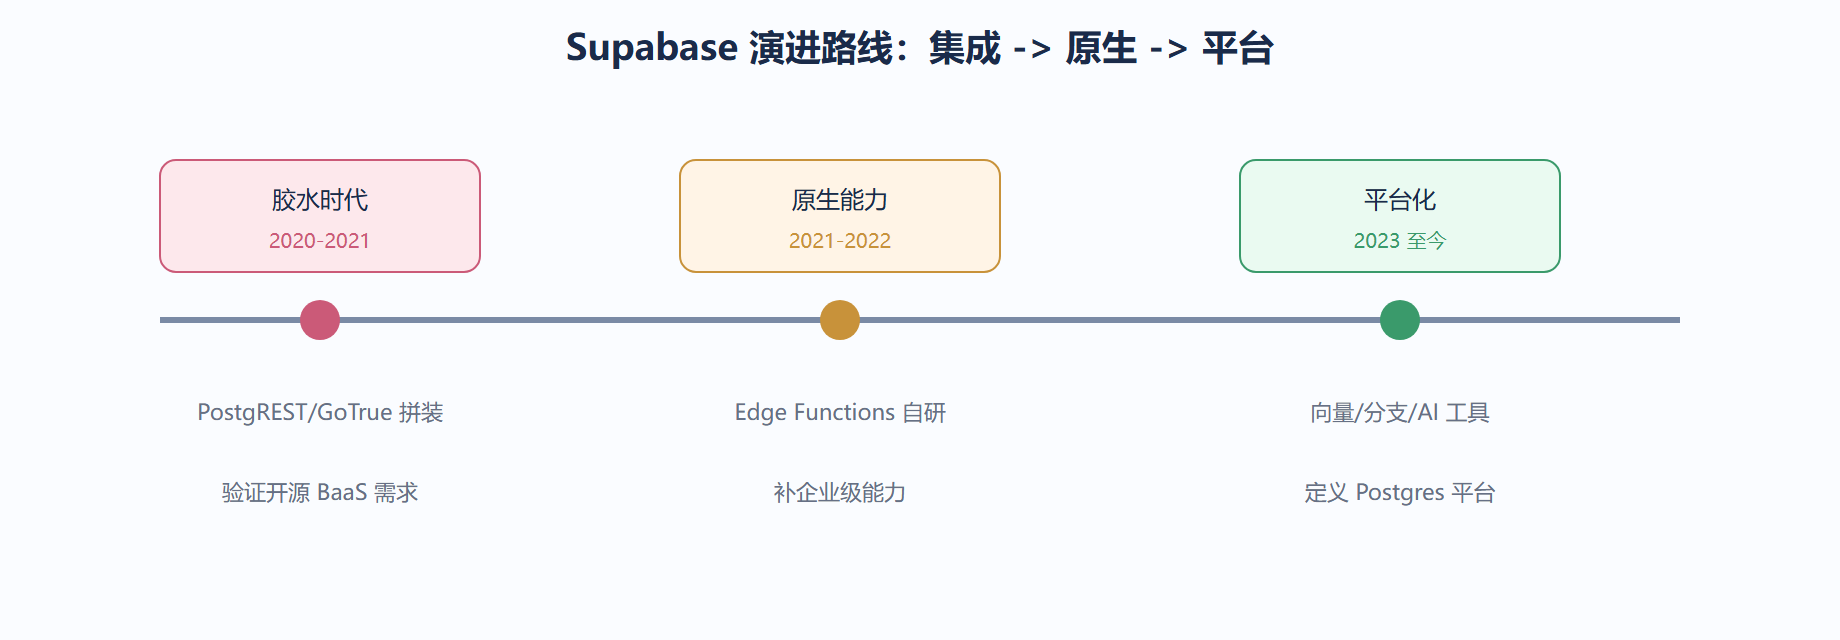
与其先堆年份,不如先把结论摆清楚:Supabase 的成长可以压缩成三个阶段——胶水时代(集成别人)→ 原生能力(自研定义)→ 平台化(定义赛道)。后面所有细节都挂在这根主线上。
早期(2020—2021)是"胶水时代"。平台能力几乎都来自外部开源项目,Supabase 团队的工作是写配置、做体验、修集成 bug。这个阶段它验证了一个假设:开发者愿意为"开源 Firebase"付费。
中期(2021—2022)开始补原生能力。Edge Functions(基于 Deno 的边缘运行时)是第一个明显"自研定义"的组件;Storage 也从早期简单封装变得更完整。同时拿到多轮融资,团队扩张,开始认真做企业功能。
近期(2023 至今)走向平台化:向量(pgvector 集成)、AI 工具包、本地开发 CLI 成熟、branching(数据库分支,类似代码分支)等。它不再只是"Firebase 替代品",而是在定义自己的赛道——"Postgres 开发平台"。
下面用 SVG 把这条演进画成一条有明确阶段的路,每阶段标注主导能力来源:
社区生态是怎么转起来的
Supabase 的社区不是"用户群",而是"共同开发层"。几种角色在生态里互相喂:
- 核心团队:维护组件、定路线图、做商业云。
- 开源贡献者:给 PostgREST、GoTrue 等提 PR,修 bug、加特性。
- 客户端库维护者:除官方 JS/Flutter 外,社区维护了 Python、C#、Swift、Kotlin 等封装。
- 模板与教程作者:大量 starter template(Next.js、SvelteKit、Nuxt 等)由社区产出。
我们用一段真实操作展示社区如何降低门槛——用社区 starter 模板几秒钟起一个带登录的项目:
# 用社区维护的 Next.js + Supabase starter(非官方,但社区广泛采用) npx create-next-app@latest myapp --example with-supabase cd myapp # 把环境变量填进 .env.local:NEXT_PUBLIC_SUPABASE_URL / ANON_KEY npm run dev # 浏览器打开 localhost:3000 即出现带注册登录的页面
结果:你没写一行认证代码,却拿到了可登录的 Next.js 应用。这是社区把"Supabase + 框架"的组合封装成了模板,新 project 成本趋近于零。
除了"拉模板",你还能用 CLI 直接看社区里谁是活跃贡献者、最近合入了哪些能力。下面这条命令通过 GitHub API 拉取 Realtime 仓库近一个月的合并 PR,按作者归类——它能让你直观看到"生态是哪些人在喂":
# 用 gh CLI 拉取 Supabase Realtime 仓库最近合入的 PR 与作者 gh pr list --repo supabase/realtime \ --state merged --limit 30 \ --search "merged:>=2024-01-01" \ --json number,title,author \ --jq '.[] | "\(.number) \(.author.login) \(.title)"' # 说明:作者列里既有 core-team 也有社区账号,印证"共同开发层"
这段输出的价值不在命令本身,而在它把抽象的"社区生态"变成了可数的人和时间线——你看到的每个 PR 号,背后都是一次真实的痛点驱动。
底座开源项目的来龙去脉
理解生态要先知道底座来自哪。下面列几个关键开源项目及其在平台中的角色:
| 开源项目 | 许可 | 在 Supabase 里的角色 |
|---|---|---|
| PostgREST | MIT | 把 Postgres 表暴露成 REST API |
| GoTrue | MIT | 认证与 JWT 签发(后并入 auth 服务) |
| Realtime | Apache 2.0 | 监听 WAL 推 WebSocket 变更 |
| Kong | Apache 2.0 | API 网关,统一路由各服务 |
| PgBouncer | MIT | 连接池,缓解长连接压力 |
| pgvector | MIT | 向量类型与相似检索 |
这张表的重点:这些项目都比 Supabase 早诞生多年,Supabase 做的是把它们"接好线"。所以你用的很多能力其实是整个开源社区几十年的积累,而不只是一家公司的产出。
如果你想量化"底座到底有多老、被多少人用",可以在任意 Postgres 里跑下面这段 SQL——它把 Supabase 依赖的几个开源项目当作一张表,按诞生年份排序,并标注它们进入平台的时间差。这是一个教学用的自包含查询,结果能让你对"集成而非发明"有体感:
-- 教学示例:把核心开源底座按诞生年份排序,看 Supabase 站在多厚的积累上 with upstream as ( select 'PostgREST' as project, 2014 as born, 'MIT' as license union all select 'GoTrue', 2016, 'MIT' union all select 'Realtime', 2017, 'Apache 2.0' union all select 'Kong', 2015, 'Apache 2.0' union all select 'PgBouncer', 2007, 'MIT' union all select 'pgvector', 2021, 'MIT' ) select project, license, born, 2020 - born as years_before_supabase -- Supabase 创立于 2020 from upstream order by born asc; -- 输出示例: -- project | license | born | years_before_supabase -- PgBouncer | MIT | 2007 | 13 -- PostgREST | MIT | 2014 | 6 -- Kong | Apache 2.0 | 2015 | 5 -- GoTrue | MIT | 2016 | 4 -- Realtime | Apache 2.0 | 2017 | 3 -- pgvector | MIT | 2021 | -1 -- 说明:pgvector 比 Supabase 晚一年,是平台反过来反哺上游的典型
展开案例:一个社区驱动的特性是怎么进主干的
背景:早期 Supabase 的 Realtime 只支持按表监听,社区有人需要"只听某一行变更",在 GitHub issue 里提了需求并附了实现思路。
操作与过程:
- 社区成员 fork Realtime 仓库,基于 WAL 的
REPLICA IDENTITY实现了行级过滤,开了 PR。 - 核心团队 review,发现和 RLS 策略需要打通(不能让用户听到无权限的行),要求补权限校验。
- 贡献者补上"先过 RLS 再推送"的逻辑,并加了测试。
- PR 合并,下个版本所有用户都能用
filter: 'id=eq.42'这类行级监听。
结果:这个能力不是公司路线图排期的,是社区痛点驱动的,且因为过了 RLS 校验,安全性和其它能力一致。
解读:社区生态的价值不只是"人多好办事",更在于它让平台能力贴近真实场景。但也意味着节奏不完全可控——你想要的特性可能排不上,得自己动手或等别人提。
变式:如果你公司有能力,完全可以内部维护一个 fork 分支,把私有需求先实现,再视情况回哺上游;开源许可允许你这么做。
三句话带走本节
- Supabase 起步于"集成开源组件",逐步长出原生与平台能力,三个阶段撑起整条演进主线。
- 生态由核心团队、贡献者、客户端维护者、模板作者共同支撑,不是单向的"官方发、用户用"。
- 底座多是成熟开源项目,平台价值在"接好线 + 一致体验",社区模板能让你零成本起项目。
提醒一句:依赖社区模板有风险,第三方 starter 可能落后于官方 API 变更。生产前核对它用的 supabase-js 版本,别盲目 npx 完就上线。顺手把 Supabase 的 GitHub 仓库和 release notes 加进你的信息源——它的演进很快,社区讨论里常能提前看到坑和 workaround。
读完第一章,你已经知道 Supabase 是什么、为什么开源、和 Firebase 差在哪、怎么长起来的。第二章我们钻进内部,看这些组件到底怎么连成一套架构。