4.1 性能优化与扩展性
4.1 性能优化与扩展性
反问一句:你的 Supabase 查询为什么在本地毫秒返回,上线后却要几秒?答案往往不在机器大小,而在索引、RLS 写法、和连接数这三处。这一节我们讲清最常见的性能坑,以及扩展实例、只读副本、连接池怎么配合。
索引:最容易被忘的加速开关
没有索引的查询,表一大就全表扫描。下面给 orders 的 user_id 加索引,让"查某用户订单"从扫全表变成走索引:
-- 给高频过滤列建 B-tree 索引 create index if not exists idx_orders_user on public.orders (user_id); -- 复合索引:常按 user_id + created_at 范围查 create index if not exists idx_orders_user_time on public.orders (user_id, created_at desc);
建完用 explain analyze 看是否真的走了索引:
explain analyze select * from public.orders where user_id = 'xxxx' order by created_at desc limit 20; -- 输出里出现 Index Scan using idx_orders_user_time 即生效
一个反例:有人给 boolean 列 published 单独建索引,结果 90% 行都是 true,规划器仍选全表扫——低区分度列单建索引几乎无用,应放进复合索引或配合部分索引。
RLS 的性能代价与写法
RLS 策略会在每条查询上附加条件,若策略里有易变函数或子查询,可能拖慢。下面这条策略每次都嵌套查询,用户多时很慢:
-- 不推荐:策略里嵌子查询,每行都查一次 create policy "慢策略" on public.docs for select using ( exists (select 1 from public.shares where shares.doc_id = docs.id and shares.user_id = auth.uid()) );
优化思路:把"共享关系"冗余成一列或用物化,或限制策略复杂度。更稳妥的是给 shares(doc_id, user_id) 建联合索引,让 exists 走索引而非全扫。
create index idx_shares_doc_user on public.shares (doc_id, user_id);
连接池:PgBouncer 与突发流量
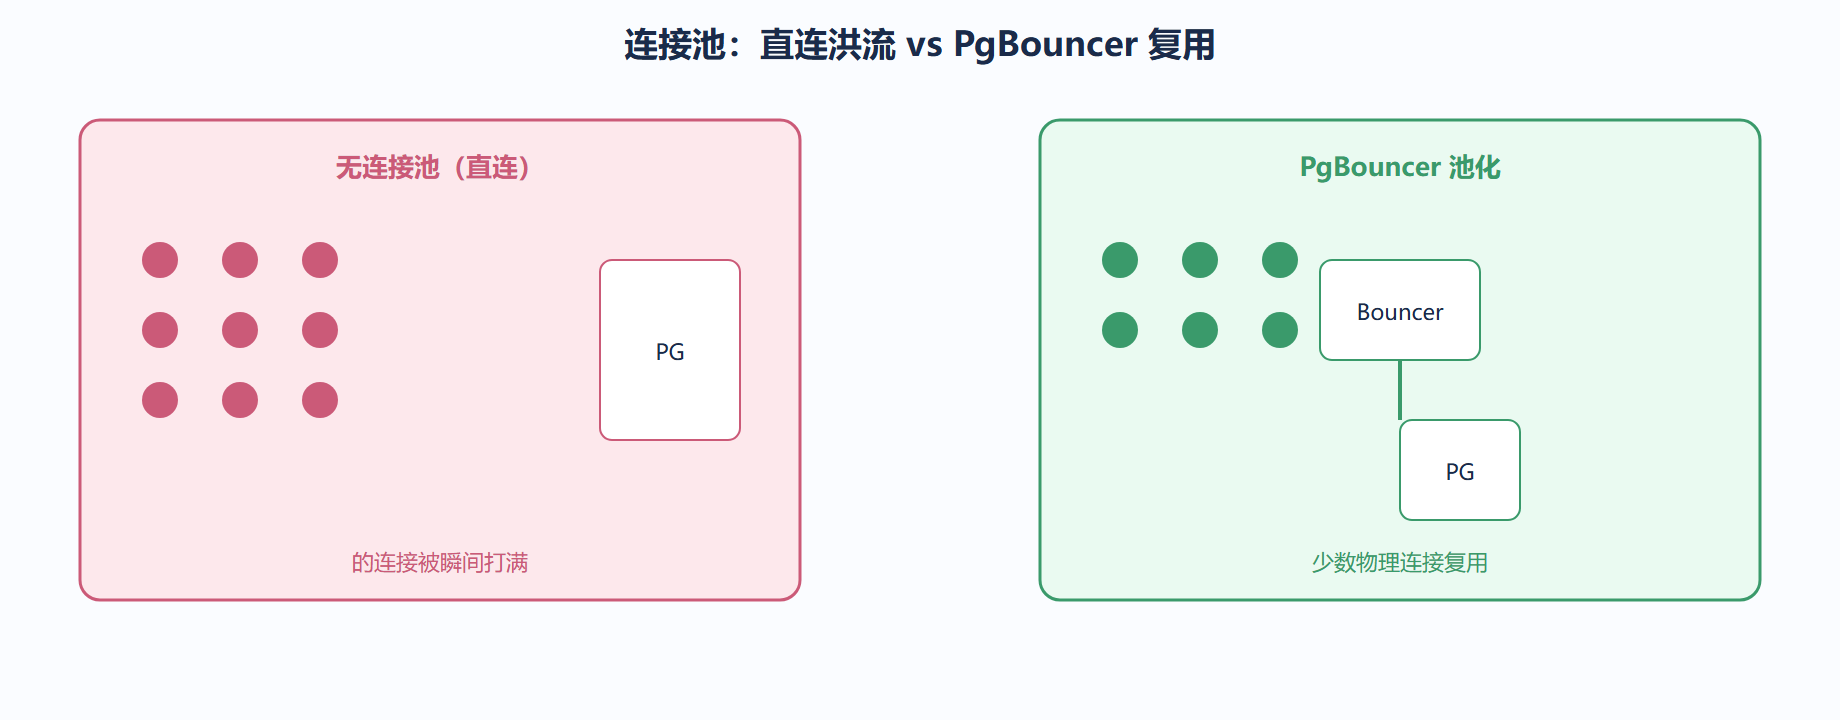
Postgres 每个连接占内存,前端直连会产生大量短连接。Supabase 在前面放了 PgBouncer 做连接池。事务模式下池把请求复用同一物理连接。注意:事务模式不支持某些需要跨语句保持状态的功能(如 advisory lock、prepare 跨语句),需要时在连接串里用带 :6543 的直接连接端口。
下面 SVG 画了"无池 vs 有池"的连接形态差异,直观看到为什么高并发要池化:
扩展:实例规格、只读副本、分支
Supabase 云的扩展旋钮:
- 实例规格:CPU/内存更大,单机吞吐更高。
- 只读副本:把读流量分流到副本,主库专注写。客户端用单独的只读连接串。
- 数据库分支:类似 Git 分支,复制一份库用于测试,不影响生产。
# 通过 CLI 查看当前项目信息(规格、区域) supabase projects list # abc123 myapp ap-southeast 2024-01-01
展开案例:列表页从 3 秒到 80 毫秒
背景:一个订单列表页,用户量上来后查询要 3 秒,前端超时。
操作过程:
- 在 SQL Editor 跑
explain analyze,发现Seq Scan on orders(全表扫)。 - 确认前端按
user_id + created_at过滤排序,补复合索引:
create index idx_orders_user_time on public.orders (user_id, created_at desc);
- 重跑 explain,变为
Index Scan,耗时降到 200ms。 - 进一步发现 RLS 策略里
auth.uid()调用开销可忽略,但某条策略嵌了exists子查询,给 shares 表补索引后整体到 80ms。 - 上线后观察连接数,发现峰值直连数高,把前端连接指向池化端口(6543)。
结果:列表从 3 秒降到 80 毫秒,连接数稳定。
解读:性能问题九成是索引缺失 + 策略子查询,先把这两处查了再考虑升配。盲目升实例只是用钱掩盖慢查询。
变式:若读远多于写,可加只读副本,把列表查询走副本连接串,主库只承接写入,进一步降载。
本节要点回顾
- 索引是首要加速手段,低区分度列单建无效。
- RLS 策略里的子查询要用索引兜底,否则每行重查。
- 连接池化应对高并发,只读副本分流读流量。
⚠️ 事务模式的 PgBouncer 不支持跨语句保持的状态(如预备语句、会话级 advisory lock)。若你的驱动报错"prepared statement 不存在",改用 6543 直连端口或关掉驱动预编译。
💡 我们建议把 explain analyze 当成上线前的例行检查,而不是出事才用。任何新增的高频查询,先在本地用足够大的假数据跑一遍计划。
索引选型的几个实战判断
不是"建了索引就快"。下面把常见列类型和该用的索引形态对照清楚,免得建错方向白费空间:
| 查询形态 | 推荐索引 | 反例 |
|---|---|---|
| 按单个等值过滤(user_id = ?) | B-tree 单列 | 无 |
| 按两列范围+排序 | B-tree 复合 (a, b desc) | 只建单列 a |
| 模糊搜索 content like '%词%' | trigram (pg_trgm) | 普通 B-tree 无效 |
| 地理位置半径查询 | GiST (PostGIS) | B-tree 无效 |
| 数组包含(tags @> ?) | GIN | B-tree 无效 |
| 布尔 published = true(90% 都相同) | 部分索引 where published |
单列 B-tree 几乎无用 |
💡 关键直觉:索引是为"查询的形状"服务的。你的 where / order by 长什么样,索引就该照着建。低区分度的列(如性别、是否删除)单建索引基本是浪费——规划器知道选它不如扫全表,结果索引占着空间却用不上。
再展开一个案例:模糊搜索从超时到毫秒
背景:一个商品名搜索框,输入关键词后接口要 5 秒,用户以为卡死。
操作过程:
- 原查询用
ilike('%关键词%'),但name上只有主键索引,规划器只能全表扫。 - 开启 trigram 扩展并建 GiST 索引:
create extension if not exists pg_trgm; create index if not exists idx_products_name_trgm on public.products using gin (name gin_trgm_ops);
- 重跑
explain analyze,原来的Seq Scan变成Bitmap Index Scan using idx_products_name_trgm。 - 搜索耗时从 5 秒降到 40 毫秒。
结果:模糊搜索体验从"不可用"变"秒出"。
解读:B-tree 对付前缀匹配(like '词%')还行,但"任意位置包含"(%词%)它无能为力,必须 trigram。选错索引类型,建了也白建。
⚠️ 常见坑:索引能加速读,但会拖慢写(每写一行要顺带更新索引)。一张高频写入又建了五六个索引的表,写入会明显变慢。原则是"只为真正高频的查询建索引",别给每张表无脑堆索引。
下一节我们专门讲安全与合规:RLS 之外的纵深防御、密钥管理、合规要点。