6.3 数据驱动型产品与分析平台
6.3 数据驱动型产品与分析平台
一句行话:数据驱动产品的命门不是"能不能出数",而是"数据从哪来、权限怎么控、量大了怎么不崩"。Supabase 在这类产品里最适合当"业务交易 + 用户权限"的中枢,而重分析交给专用系统。这一节我们讲它怎么嵌入分析平台,以及边界在哪。
先说清楚边界:Supabase 不是数据仓库
典型分析产品有三层数据:
- 业务交易数据:用户、订单、事件触发——适合放 Supabase(关系 + 事务 + RLS)。
- 行为埋点数据:高频、半结构化——量大时更适合时序/日志系统,或先落 Supabase 再异步流转。
- 聚合结果:看板、报表——读多写少,可由分析库物化。
Supabase 守住第一层,并通过逻辑复制或 outbox 把数据流转给下游,而不是自己硬扛全部。
用视图封装分析查询
把常用分析逻辑写成数据库视图,前端和分析工具直接查视图,不用每次拼复杂 SQL:
-- 每日新增用户视图 create view public.daily_new_users as select date_trunc('day', created_at) as day, count(*) as cnt from auth.users group by 1; -- 给分析师看(仅管理员) alter view public.daily_new_users set (security_barrier = true); create policy "管理员看报表" on public.daily_new_users for select using (auth.jwt() ->> 'app_role' = 'admin');
注意:视图上的 RLS 依赖于底层表权限与视图属主,配置要谨慎;简单场景直接对视图查、在前端用管理员客户端(服务端)拉即可。
二之一、用 outbox 模式安全地把数据送出去
光靠逻辑复制有个前提:被复制的表变动必须"业务上确实发生"。但有些场景你要保证"写交易"和"发分析事件"要么都成、要么都败,不能交易提交了、事件却丢了。经典做法是 outbox(发件箱)模式:在同一事务里既写业务表、又写一张 outbox 事件表,由下游消费 outbox 再删,复制只在事务提交后才有数据。
-- 发件箱:和业务写入同一事务提交 create table public.outbox ( id bigint generated always as identity primary key, topic text not null, payload jsonb not null, created_at timestamptz default now() ); -- 下单时,在同一事务里插订单 + 插事件 insert into public.orders (user_id, amount) values (v_user, v_amount); insert into public.outbox (topic, payload) values ('order.created', jsonb_build_object('user_id', v_user, 'amount', v_amount));
下游(Edge Function 或分析管道的消费者)定期扫 outbox,处理完就删。即使消费者短暂挂掉,事件也留在表里不丢,起来接着处理即可——这就是"至少一次"投递的廉价实现。
物化视图缓解重聚合
报表若每次实时聚合亿级数据,主库受不了。用物化视图预计算,定时刷新:
create materialized view public.sales_summary as select product_id, sum(amount) as revenue, count(*) as orders from public.orders group by product_id; -- 定期刷新(可由 cron / Edge Function 触发) refresh materialized view public.sales_summary;
前端查 sales_summary 是瞬时返回,代价是数据有几分钟延迟——对看板通常可接受。
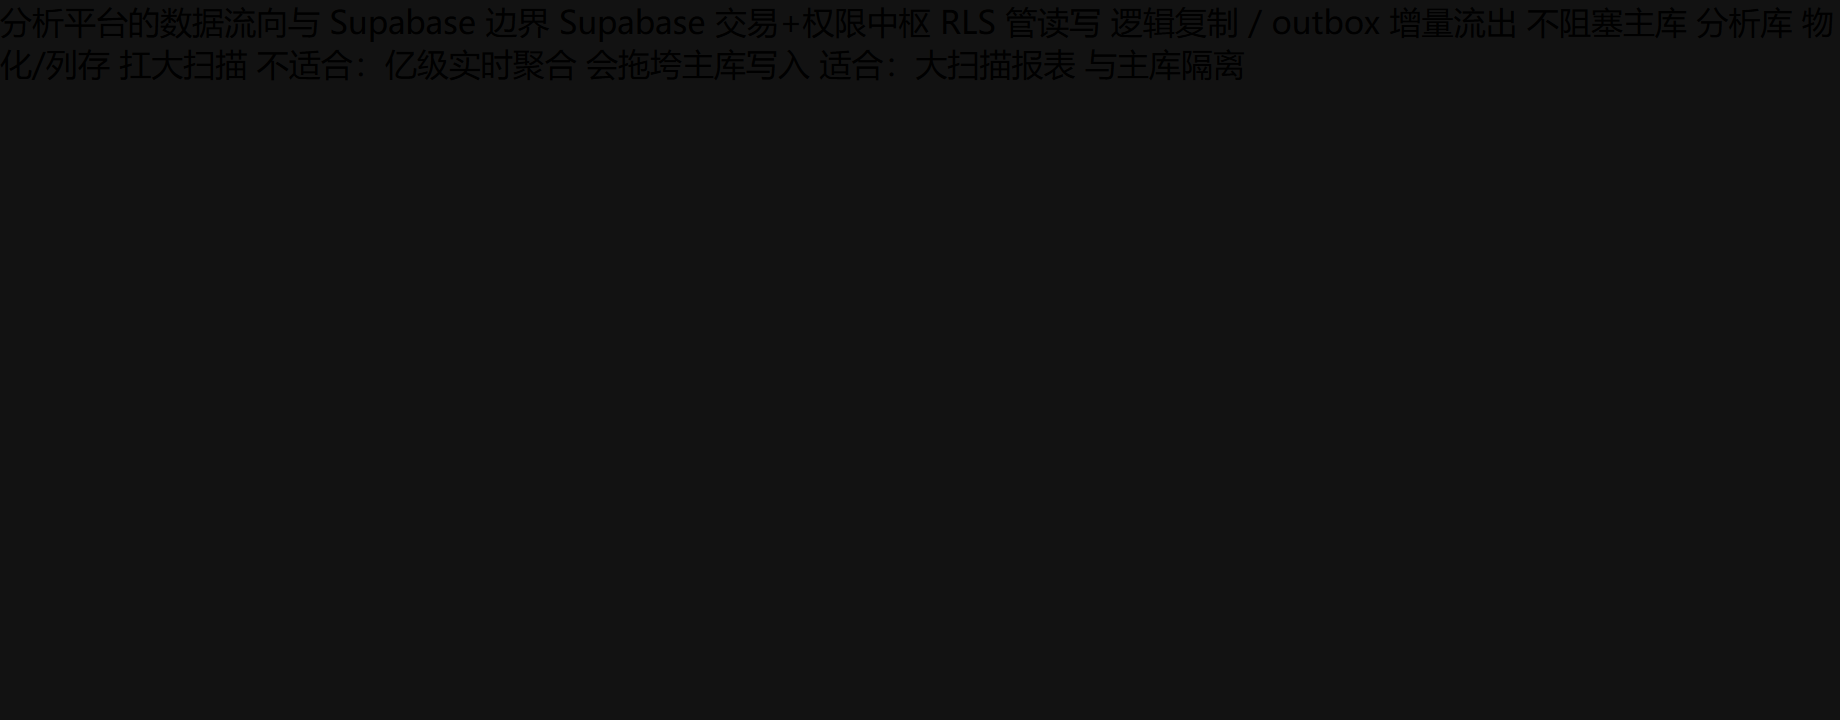
下面 SVG 画了"交易库 → 复制 → 分析库"的流向,标明 Supabase 守在哪段:
展开案例:SaaS 看板扛住增长
背景:某 SaaS 的老板看板直接查 Supabase 主库聚合订单,日单量过百万后,报表查询把主库 CPU 打满,线上下单变慢。
操作过程:
- 确认瓶颈:报表的
group by product_id全表扫,和写入抢资源。 - 用逻辑复制把 orders 同步到独立分析库(列式存储),报表查询改走分析库。
- 主库只保留交易写入 + 实时类轻查询,CPU 恢复正常。
- 若暂不能上分析库,先用物化视图
sales_summary在主库内解耦,定时 refresh 过渡。
结果:线上下单恢复流畅,老板看板照常出数,二者互不拖累。
解读:这是"该迁"的典型(详见 4.5 演进)。分析负载和交易负载对数据库要求相反,硬放一起必冲突。Supabase 的逻辑复制让迁出成本可控。
变式:若分析需求还没到大到独立仓库,物化视图 + 定时刷新是性价比最高的折中,先把"实时聚合"变成"分钟级刷新",主库压力立减。
下面用一张表对比三种"让报表出数"的方案,按数据量增长逐级升级:
| 方案 | 数据新鲜度 | 主库压力 | 适用规模 | 迁移成本 |
|---|---|---|---|---|
| 直查主库聚合 | 实时 | 高(和写入抢 CPU) | 日单 < 10 万 | 无 |
| 物化视图 + 定时 refresh | 分钟级 | 低(刷新时短暂) | 日单 10 万~百万 | 低 |
| 逻辑复制 → 独立分析库 | 秒~分钟级 | 几乎为 0 | 日单 > 百万 | 中 |
选择标准很简单:先量日单量。10 万以内直查主库完全够,别提前优化;过百万再上物化视图过渡;真正压垮主库了,逻辑复制切开是唯一正解。
⚠️ 视图上的 RLS 容易被误当"安全"。视图本身不自动继承底层表的 RLS,能否看到行取决于视图属主权限和 security_barrier 设置。给分析师用的视图,要么显式在视图上建 policy(如上面 app_role='admin'),要么只在服务端用管理员客户端查,别让前端直连视图以为"有 RLS 护着"。
💡 关键直觉:分析负载和交易负载对数据库的要求是反着的——交易要写快、行级锁、强一致;分析要扫全表、聚合、读多写少。把它们塞进同一个实例,等于让两个抢同一块 CPU 的活互相拖累。架构上从第一天就"分着想",后期用逻辑复制切开只是水到渠成。
你现在已经能分清交易与分析
- Supabase 守业务交易与权限,重分析交给专用系统。
- 视图封装常用分析,物化视图缓解重聚合。
- 逻辑复制把分析流量隔离,保护主库写入。
提醒:别在 Supabase 主库跑亿级 group by 给老板看实时报表。它会和线上写入抢 CPU,轻则慢、重则宕。分析负载该隔离就隔离,物化视图是过渡、独立分析库是归宿。
建议:我们建议分析类产品从第一天就把"交易库"和"分析库"在架构上分开想,哪怕前期共用一个实例用物化视图顶着。等数据量上来,用逻辑复制切开比后期重构全表查询省力得多。
下一节讲移动应用后端:Supabase 怎么给 iOS/Android 当后端,离线、推送这些移动特有问题怎么处理。