6.6 典型成功案例剖析
6.6 典型成功案例剖析
一张图先给总览:前面五章的知识点,落到真实产品里不是平均用力,而是按业务形态挑组合。这一节我们剖三个有代表性的案例——协作白板、内容社区、内部工具,看它们各自"用了哪几块、放弃了哪几块、踩了什么坑"。读完你应该能把这册书的内容组装成自己的架构。
案例 A:实时协作白板
业务形态:多人同时画图形、看彼此光标,数据要持久化。
用的组件:Database(图形表 + RLS)、Realtime 的 postgres_changes(图形变更落库后推送)、broadcast(光标瞬态)、presence(在线名单)。Storage 存导出图片。
放弃的:Edge Functions 几乎没用——逻辑都在客户端和数据库,无需服务端中转。
架构草图(SVG):
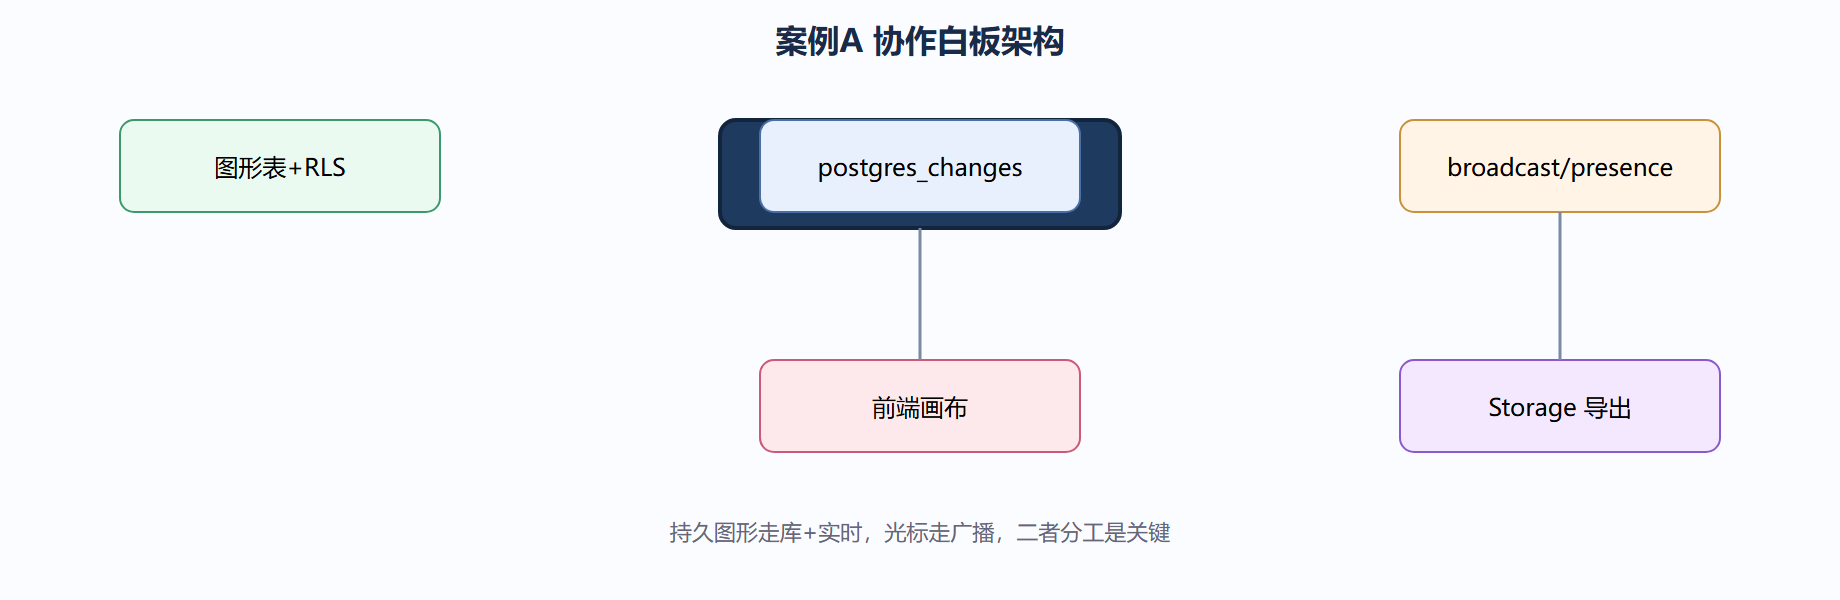
踩的坑:起初把光标也落库,白板一卡就写爆。后来按 3.4 讲的分流,光标改 broadcast,库只存图形。这是"瞬态 vs 持久"判断错了的典型教训。
下面这段 TypeScript 是白板前端初始化 Supabase 客户端的真实骨架——它同时订阅图形变更(持久,走 postgres_changes)和光标广播(瞬态,走 broadcast)。注意 schema: 'public' 与 table: 'shapes' 的过滤写法,这正是前面踩坑后沉淀下来的稳定形态:
// 白板前端:同时订阅持久图形与瞬态光标 import { createClient } from '@supabase/supabase-js' const supabase = createClient( process.env.NEXT_PUBLIC_SUPABASE_URL!, // 项目 URL process.env.NEXT_PUBLIC_SUPABASE_ANON_KEY! // 匿名 key(受 RLS 约束) ) // 1) 持久层:图形写入 shapes 表后,所有房间成员实时收到 const shapeChannel = supabase .channel('shapes-room') .on( 'postgres_changes', { event: '*', schema: 'public', table: 'shapes', filter: 'room_id=eq.42' }, (payload) => renderShape(payload.new) // 落库即重绘 ) .subscribe() // 2) 瞬态层:光标只广播不落库,用 broadcast 降低写压力 const cursorChannel = supabase .channel('cursors-room') .on('broadcast', { event: 'move' }, (msg) => drawCursor(msg.payload)) .subscribe() // 发送光标:仅推送坐标,不进数据库 await cursorChannel.send({ type: 'broadcast', event: 'move', payload: { userId, x: 120, y: 88 } }) // 输出/行为:room 内其他人屏幕上实时出现对方光标移动, // 刷新后图形仍在(因为图形在 shapes 表),光标位置不留存(瞬态)。
案例 B:内容社区
业务形态:用户发帖、评论、点赞,要登录、要审核后公开、要防刷。
用的组件:Auth、Database(posts/comments/likes + RLS 读宽写窄)、Realtime(评论刷新)、Storage(头像/配图)、Edge Functions(敏感词过滤 + 通知)。
关键设计:帖子 published 标志区分草稿与公开;评论匿名可读、登录可写;点赞用唯一约束防重复。
-- 点赞去重 create table public.likes ( user_id uuid references auth.users(id), post_id bigint references public.posts(id), primary key (user_id, post_id) );
踩的坑:早期帖子表没开 RLS,匿名能改他人帖。按 4.2 的"默认收紧"原则修复,拆成读开放、写限定作者。
案例 C:企业内部工具
业务形态:公司内部 CRUD 后台,数据敏感,要审计、要按部门隔离。
用的组件:Auth(配 SSO)、Database + 严格 RLS(按部门)、审计触发器(见 1.3)、只读副本分流报表。
关键设计:auditors 表标记审核员辖区,RLS 用 exists 限制只看本区;所有写操作经触发器留 updated_by。
踩的坑:报表直接查主库拖慢业务,按 6.3 用逻辑复制切开分析流量。
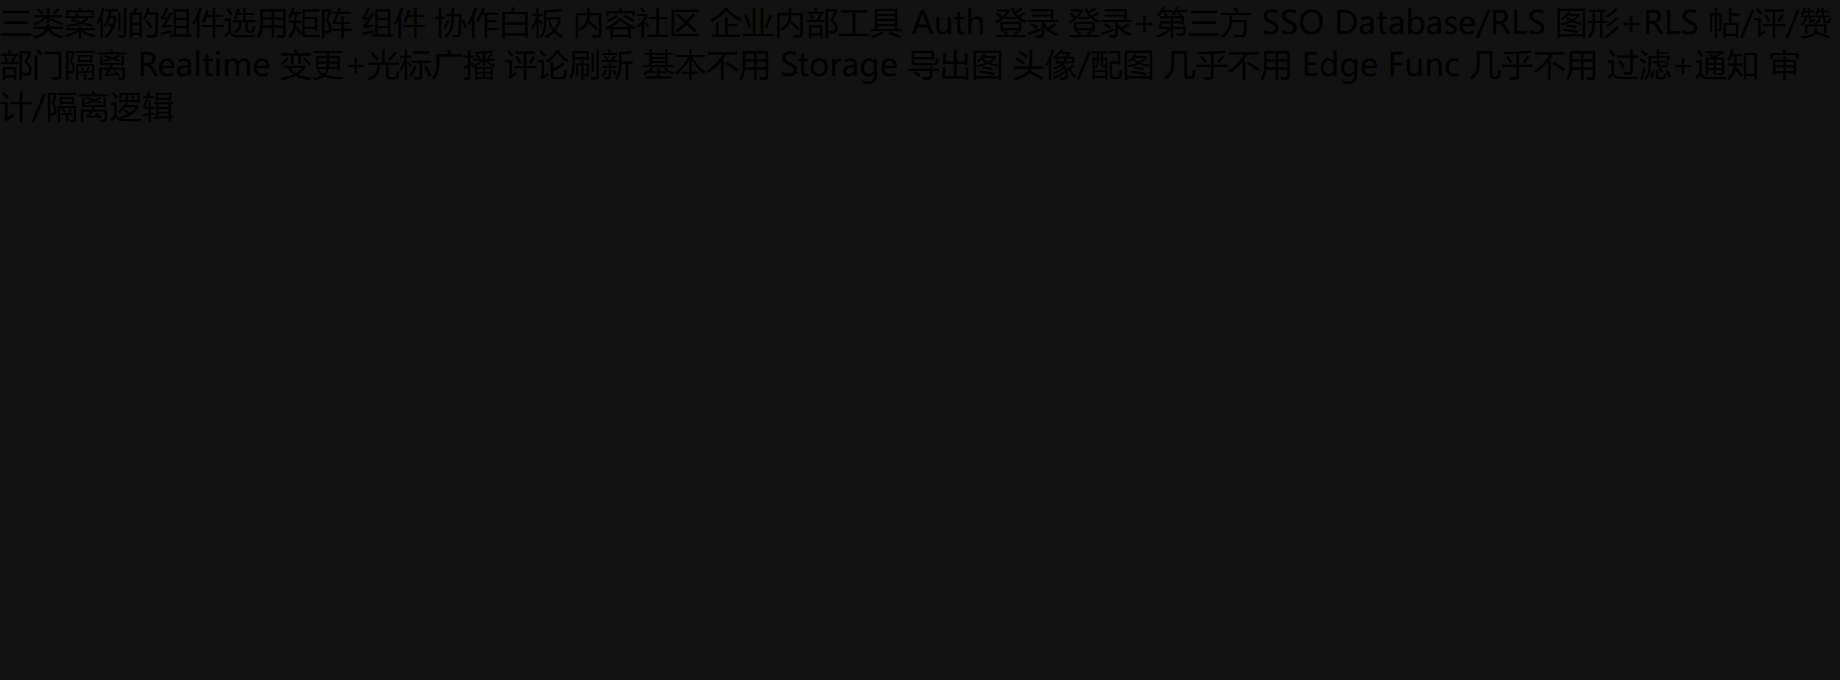
下面 SVG 把三个案例的"组件选用"做成对比矩阵,方便你照自己的业务对号入座:
展开案例:白板从原型到十万用户
背景:案例 A 的团队产品跑火,用户从几百涨到十万,出现性能与成本压力。
操作过程:
- 图形表按
room_id建复合索引,热门房间查询变快。 - 开启只读副本,报表类统计走副本,主库专注写。
- 光标广播在高峰期占用 WebSocket 带宽,加节流到 50ms 并限制房间人数上限。
- 用 PgBouncer 池化应对突发连接。
- 评估是否要迁出:图形数据强关系、要事务,留在 Supabase;仅把图片导出转码交给外部服务。
结果:十万用户下仍流畅,核心库没换,只在 Supabase 内做扩展旋钮调节。
解读:这个案例印证了 4.5 的演进判断——只要数据仍是关系+事务为主,Supabase 能随业务长到很大,靠的是索引、副本、池化这些标准手段,而非推倒重来。
变式:若白板要支持"无限画布 + 矢量协作"的高级形态,图形元数据可能膨胀到需要分表/分区,那时在 Supabase 内做表分区即可,仍不脱离平台。
你现在已经能做什么
- 协作白板:库+实时管持久,broadcast 管瞬态,函数可省。
- 内容社区:读宽写窄 RLS + 唯一约束防刷 + 函数做过滤。
- 企业内部:SSO + 部门 RLS + 审计 + 分析流量隔离。
- 成长阶段靠索引/副本/池化在平台内扩展,不必早迁。
三个案例共同踩过的坑都指向同一句:RLS 默认关、结构要版本化、瞬态别落库。这三条如果当初偷懒,后面每个案例都要回过头补课,成本远高于一开始就做对。选组件时先用"数据形态"反推:关系强+要事务+要权限 → Supabase 主力;瞬态信号 → broadcast;重分析 → 隔离;帧级实时 → 专用服务。照这个表对号入座,架构基本不会偏。
至此六章全部讲完。从"为什么需要开源 BaaS"到"真实产品怎么组装",你应该已经能把 Supabase 当成一套可拆解、可扩展、可控的后端全家桶来用了。下一步就是选一个自己的项目,照第三章动手,遇到问题回对应章节查。