3.5 性能优化与资源管理
3.5 性能优化与资源管理
在体系中的位置:3.4 让系统跑起来了,这一节让它跑得动、跑得起。多智能体最容易被忽视的代价是"消息序列化 + 模型调用 × 智能体数"的乘积膨胀——不优化,三个智能体就可能比一个慢三倍还不止。
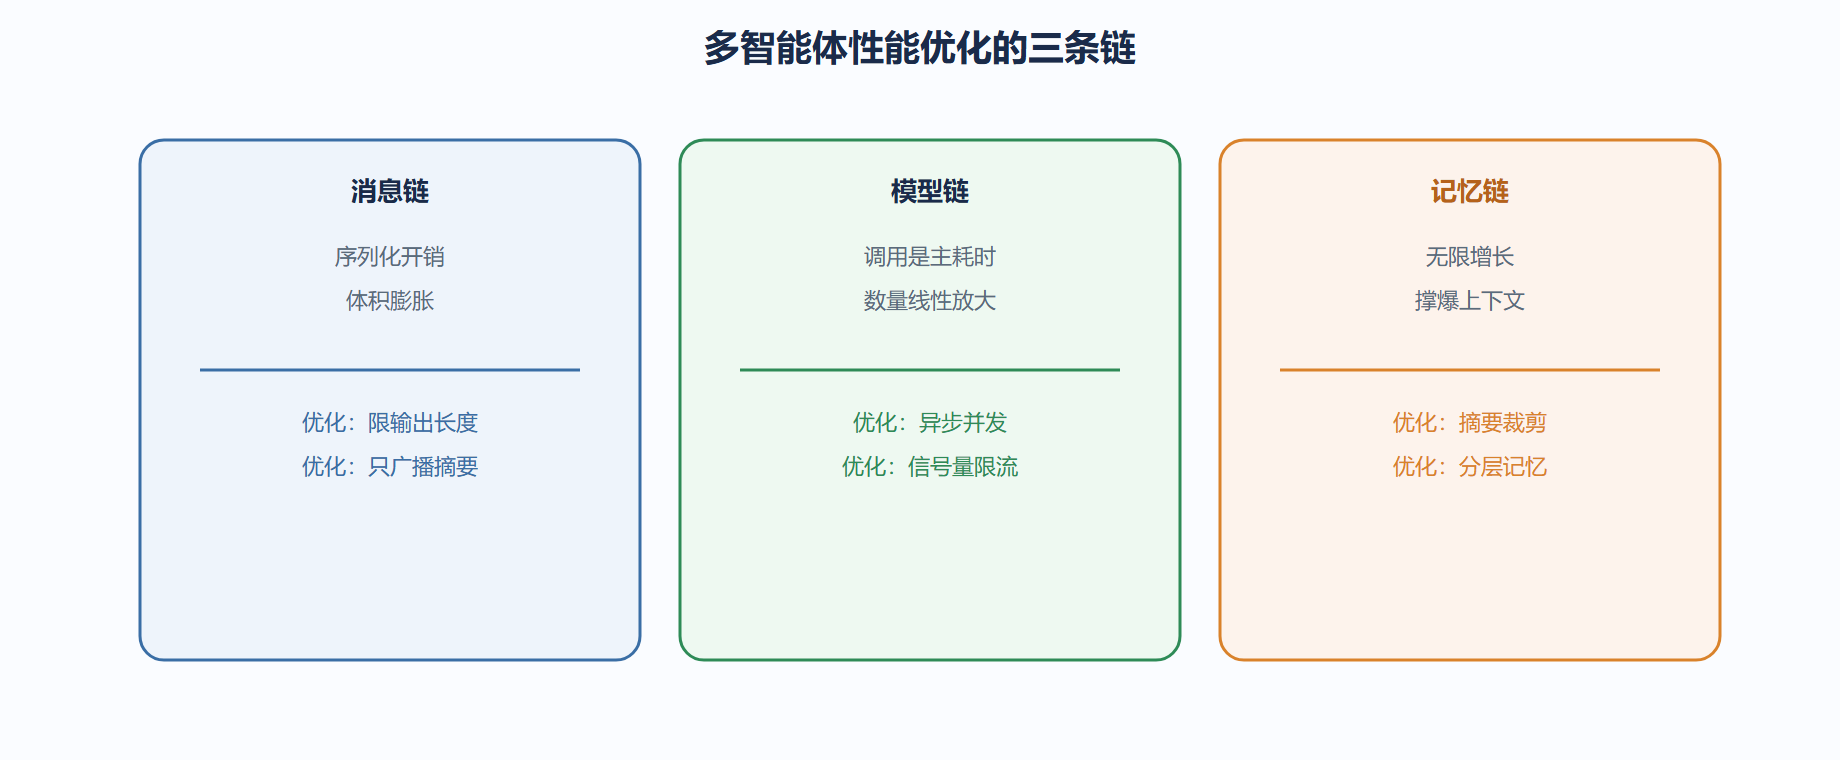
先讲因果:为什么多智能体会变慢?两个主因。一是消息每次都要序列化/反序列化,智能体越多、消息越长,开销越大;二是每个智能体独立调模型,模型调用是主要耗时,智能体数线性放大总耗时。优化就是在这两条链上做减法。
控制消息体积:别把整段历史广播
MsgHub 里每个人自动收到他人发言。若某智能体吐出超长文本,所有人记忆被撑大,下一轮推理成本飙升。对策:在 sys_prompt 里要求"用简洁语言回答",或只广播摘要。
# 反例:不约束长度,长文本在 MsgHub 内指数扩散 verbose_agent = DialogAgent(name="话痨", sys_prompt="详细回答每个问题。", model=model) # 正例:约束输出,降低消息体积 concise_agent = DialogAgent( name="高效者", sys_prompt="用不超过三句话回答,只给结论和关键依据。", model=model, ) # 多智能体(>5)场景尤其要限制每轮响应长度,避免对话冗长拖慢整体
运行说明:"话痨"在 MsgHub 里每轮产出长文本,其他智能体记忆同步膨胀,后续每轮推理都更贵。加一句长度约束,整体延迟和 token 成本同步下降。这是性价比最高的优化。
记忆压缩:别让上下文无限增长
2.5 提过记忆无限增长会撑爆上下文。长任务要做摘要/裁剪。AgentScope 的记忆后端可配摘要策略(如超过 N 条就压成一条摘要)。
# 记忆裁剪示意:超过阈值时只保留最近 K 条 + 一条摘要 from agentscope.memory import InMemoryMemory mem = InMemoryMemory() # 核心是:旧消息被摘要替代,而非全量保留,推理成本可控
运行说明:不裁剪,跑两小时后单次推理要吞下全部历史,慢且贵还可能超模型上下文上限。裁剪后,近期细节 + 历史摘要,成本稳定。代价是早期细节可能丢失——所以裁剪阈值要按任务调,不能无脑压。
并发与限流:别把模型打爆
多智能体并发调模型,容易触模型方限流(429)。对策:用异步 + 限速,或给不同智能体配不同模型档位(贵的干重活、便宜的干轻活)。
import asyncio # 用信号量限制同时发往模型的请求数,避免 429 sem = asyncio.Semaphore(3) # 最多 3 个并发模型调用 async def safe_reply(agent, msg): async with sem: return await agent.async_reply(msg) # 异步回复,受信号量节流 # 多个智能体并发,但模型调用被限到 3 路,避免触发限流
运行说明:Semaphore(3) 把并发模型调用压到 3 路。代价是吞吐量受限于此数,但换来"不被限流、不丢请求"。限流值按模型方配额调,不是越小越好。
优化方向对比图
把上面三类优化摆进一张图,你能看到它们分别在哪条链上做减法。
案例:十智能体流水线优化前后
背景:某流水线 10 个智能体串行,每个都吐长文本,跑一次 8 分钟、token 贵。
操作:①每个 sys_prompt 加"三句内回答";②记忆超 20 条自动摘要;③模型调用并发限到 5 路。
结果:单次降到 2 分钟,token 成本约降 60%,质量未降(因冗长文本本就含水分)。
解读:三项优化分别在消息链、记忆链、模型链上做减法,乘积效应明显。注意质量没降——说明原长文本多是冗余,约束反而聚焦。
变式:若任务本就需长输出(如写小说),不能硬限长度,改用"分章节、每章独立智能体、章间只传大纲",把长文本拆短但保完整。优化要因任务而异,没有万能开关。
五之一、模型档位分层:让便宜的干轻活
并发限流解决"别打爆",但没解决"贵的模型被浪费在简单活上"。按任务复杂度给智能体配不同档位模型:路由、格式化这类轻活用便宜小模型,推理、总结用贵大模型。总成本和延迟都能降。
from agentscope.models import OpenAIChatModel # 轻活档:便宜小模型,处理格式化、简单路由 cheap = OpenAIChatModel(model_name="gpt-4o-mini", api_key="...") # 重活档:贵大模型,处理推理、长文总结 strong = OpenAIChatModel(model_name="gpt-4o", api_key="...") router = ReActAgent(name="路由", sys_prompt="只做分类路由,输出标签。", model=cheap) writer = ReActAgent(name="写手", sys_prompt="基于资料写详细报告。", model=strong) # 真正烧脑的写报告才用大模型,整体花费比"全员大模型"省一截。
运行说明:把"路由/格式化"这类确定性强的轻活从小模型摘出来,只有真正需要语言能力的环节才上大模型。代价是系统里要维护多档模型配置,但 token 账单会明显变薄——尤其路由这类高频低难环节,小模型准确率并不输。
五之二、结果缓存:别为相同问题重复烧模型
多智能体里常有"多个智能体问同一个事实"(比如都查同一份政策条文)。加一层结果缓存,相同输入直接命中,跳过模型调用。
from functools import lru_cache _cache = {} def cached_reply(agent, key: str, prompt: str) -> str: """相同 key 直接返回缓存,避免重复模型调用。""" if key in _cache: return _cache[key] # 命中,零模型开销 reply = agent.reply(prompt) # 未命中才调模型 _cache[key] = reply return reply # '(直接命中缓存)...要点摘要...' # 第二次零开销
运行说明:缓存 key 用"智能体 + 输入"组合,相同问题第二次起完全不碰模型。代价是占用内存且内容可能过期——所以缓存宜用于"事实类、变化慢"的查询,对"实时行情"这类就不能缓存。配合 TTL 或显式失效可兼顾新鲜度。
五之三、三条链优化的取舍对照
| 优化手段 | 作用在 | 收益 | 副作用 |
|---|---|---|---|
| 限输出长度 | 消息链 | 后续推理变便宜 | 丢失细节,长输出任务不能用 |
| 记忆摘要裁剪 | 记忆链 | 防上下文膨胀 | 早期细节可能丢失 |
| 信号量限流 | 模型链 | 避 429 丢请求 | 吞吐受限于并发数 |
| 模型档位分层 | 模型链 | 总花费下降 | 需维护多档配置 |
| 结果缓存 | 模型链 | 重复查询零开销 | 占内存、内容可能过期 |
优化没有免费午餐,每项都拿某种代价换收益。落地时按"先测慢在哪条链,再对症选手段,最后压阈值到刚好"的顺序做,避免一刀切。
本节要点回顾
- 多智能体变慢两主因:消息序列化开销、模型调用随智能体数线性放大。
- 消息链优化:限输出长度、只广播摘要,降体积即降后续推理成本。
- 记忆链优化:超阈值摘要裁剪,防上下文膨胀;阈值按任务调。
- 模型链优化:异步并发 + 信号量限流,避 429 丢请求。
⚠️ 长输出任务(写小说等)不能无脑限长度。硬压会丢内容,应改"分章节、章间只传大纲"的结构性拆法,而非压单轮长度。
💡 优化前先测"慢在哪条链":消息大看消息链、调用慢看模型链、越跑越慢看记忆链。三条链对症下药的收益远大于盲调参数。