3.6 鲁棒性与错误处理
3.6 鲁棒性与错误处理
在体系中的位置:第三章最后一节,也是"敢上生产"的临门一脚。3.4 让系统能跑,3.5 让它跑得快,这一节让它跑不垮——单点故障、工具超时、模型抽风,这些在 demo 里无所谓,在生产里要命。
一个事实:多智能体系统里"某个智能体失败"不是小概率,而是必然会发生。你没法保证外部 API 永远在线、模型永远理智。鲁棒性设计的目标不是"不出错",而是"出错后系统还能协商着往前走,而不是整体崩盘"。
把故障表达成消息:核心心法
1.2 和 1.3 都埋过这个伏笔:AgentScope 容错的正确姿势,是把故障转成一条消息,让相邻智能体继续协商,而不是让进程崩溃。下面给一个带重试的工具封装。
import time from agentscope.tools import tool def _call_external() -> str: # 模拟可能超时的外部接口 raise TimeoutError("接口无响应") @tool def safe_query(retry: int = 3) -> str: """带重试的查询工具,失败返回结构化错误而非抛异常。""" for i in range(retry): try: return _call_external() except TimeoutError: if i == retry - 1: # 最终失败:返回错误消息,由智能体决定如何协商 return "ERROR: 查询失败,已达重试上限" time.sleep(1) return "ERROR: 未知失败"
运行说明:工具不把异常抛给框架导致链路断裂,而是返回 ERROR: ... 文本。上游智能体收到后能改用缓存答案、转人工或广播"失败"消息——故障被表达成消息,系统继续协商(呼应 1.2 案例)。
消息层容错:超时与重试
2.4 提过异步通信可能丢消息。应用层要给关键消息加重试与超时,避免"等一个永远不回的智能体"。
import asyncio from agentscope.message import Msg async def send_with_timeout(agent, msg, timeout: float = 10.0): """带超时的发送,避免无限等待。""" try: return await asyncio.wait_for(agent.async_reply(msg), timeout=timeout) except asyncio.TimeoutError: # 超时不当场崩溃,返回降级回复 return Msg(name=agent.name, content="(该智能体超时,已跳过)", role="assistant")
运行说明:wait_for 设 10 秒上限,超时返回降级消息而非抛异常。编排层拿到降级消息可决定跳过该步或换备用智能体。代价是多等最多 10 秒,但换来"不卡死"。
故障隔离:一个挂了不全挂
AgentScope 的容错底座(2.1 运行时层)会在智能体异常时隔离它,不让异常污染全局。应用层配合做法是:关键路径放备用智能体,主智能体失败时由 MsgHub 广播"失败",备用接管。
# await backup() # 备用接管,系统不中断
运行说明:这里体现 2.1 说的"故障局部化"——主智能体失败被局限,备用接管,监督者可见但不崩溃。没有这层,主智能体一抛异常整条链静默断。
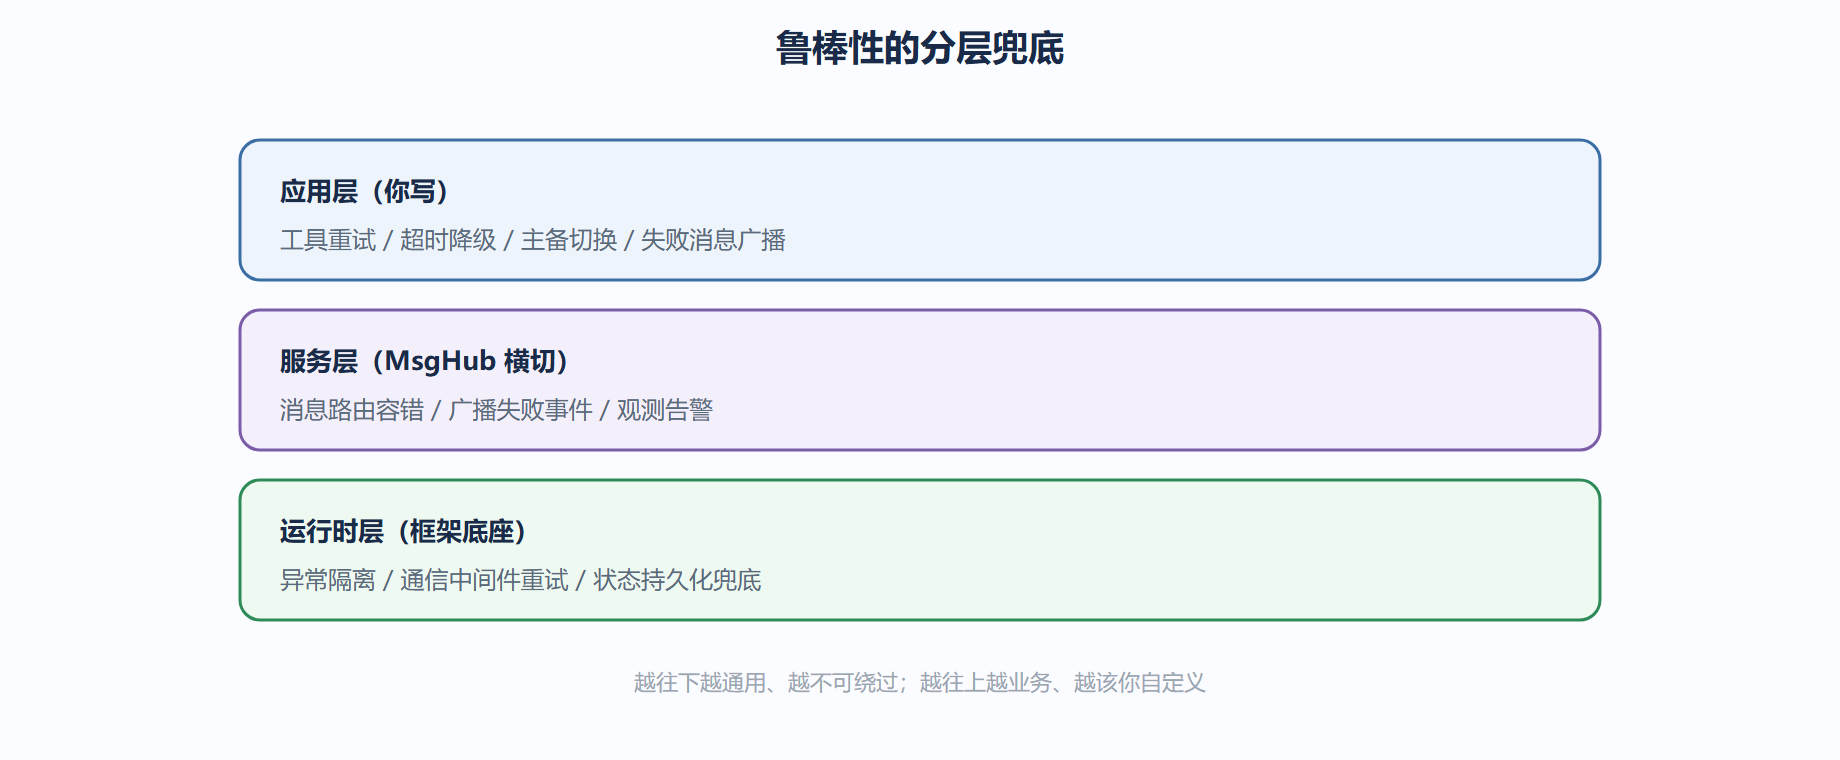
鲁棒性分层图
把容错机制按层摆开,你能看清"哪层该兜底什么"。
案例:客服系统接口超时
背景:客服用三个智能体(接待、查单、退款),某天查单接口超时(1.2 案例原型)。
操作:查单工具的 safe_query 重试 3 次仍失败,返回 ERROR 文本;接待智能体收到后发"正在重试"安抚用户,并 hub.broadcast 失败事件;退款智能体订阅到失败事件,暂不触发退款,避免基于空数据操作。
结果:用户看到的是"稍等",不是崩溃;退款没在脏数据上跑;人工可在 Studio 看到失败事件介入。
解读:这一连串容错,靠的是"故障=消息"的心法贯穿应用层与服务层。若查单直接抛异常,链路断、退款可能误触发——灾难。
变式:若查单接口是核心且常挂,正确做法不是加大重试(白烧调用),而是把查单拆成"查单 + 兜底话术"两智能体,兜底订阅失败事件直接接管。重试治标,拆分治本。
五之一、断路器与降级:别让抖动雪崩
重试和超时解决"单次偶发",但遇到下游持续不可用,无限重试只会把上游也拖垮。这里用断路器(Circuit Breaker)思想:连续失败到阈值就"熔断",直接走降级,过一段冷却期再半开试探。
class CircuitBreaker: """极简断路器:连续失败超阈值则熔断,冷却后半开试探。""" def __init__(self, fail_threshold: int = 5, cooldown: float = 30.0): self.fails = 0 self.threshold = fail_threshold self.cooldown = cooldown self.opened_at = 0.0 self.state = "CLOSED" # CLOSED / OPEN / HALF_OPEN def allow(self) -> bool: if self.state == "OPEN": import time if time.time() - self.opened_at >= self.cooldown: self.state = "HALF_OPEN" return True # 放一个请求探活 return False # 仍熔断,直接降级 return True def on_success(self): self.fails = 0 self.state = "CLOSED" def on_fail(self): self.fails += 1 if self.fails >= self.threshold: self.state = "OPEN" import time self.opened_at = time.time() # cb.on_fail(); return "DEGRADED: 下游熔断中,返回缓存答案"
运行说明:当 _call_external 连续失败 5 次,断路器切到 OPEN,后续请求不再打下游,直接回 DEGRADED 降级文本。30 秒冷却后放一个半开请求探活,成功则恢复 CLOSED。这把"重试治标"升级成"熔断治本",避免下游雪崩波及整条链。
五之二、兜底策略对照:重试 / 超时 / 熔断 / 主备
四种兜底不是互斥,而是按故障形态组合。下面一张对照表说清各自该用在哪:
| 策略 | 适用故障 | 代价 | 误用后果 |
|---|---|---|---|
| 重试 | 偶发抖动(网络闪断) | 多烧几次调用 | 对常挂接口白烧,放大下游压力 |
| 超时 | 单点无限等待 | 最多多等 timeout 秒 | 阈值过短会误杀慢但正常的请求 |
| 熔断 | 下游持续不可用 | 短暂降级、损失实时性 | 阈值过低会"假死"拒绝正常流量 |
| 主备 | 关键智能体崩溃 | 多占一个智能体资源 | 备用无差异化时只是重复犯错 |
工程上常见组合是:超时防卡死 + 重试治抖动 + 熔断防雪崩 + 主备保关键路径。它们都遵循同一前提——故障必须能被表达成消息(ERROR/DEGRADED/失败事件),否则断路器再聪明也没法让系统继续协商。
本节要点回顾
- 鲁棒性目标不是"不出错",是"出错后系统还能协商着走,不整体崩"。
- 核心心法:把故障表达成消息(ERROR 文本/失败事件),让相邻智能体协商,而非进程崩溃。
- 应用层兜底:工具重试、超时降级、主备切换、失败消息广播。
- 分层兜底:应用层(业务)你写,服务层(MsgHub 路由/告警)横切,运行时层(隔离/持久化)框架兜。
⚠️ 别用"无限加重试"治核心接口常挂。重试只治偶发抖动,治不了常挂——常挂要拆分出兜底智能体订阅失败事件接管,重试是标不是本。
💡 设计容错先问"故障能不能被表达成消息"。能,MsgHub 接得上、系统能协商;不能(如智能体内部死循环),再加重试也没用,得改代码逻辑。