2.1 系统架构概览
2.1 系统架构概览
先不急着看代码,我们先用一张分层图把框架的"楼层"认全。你写的应用在最上面,框架能力在中间,模型和工具在最底下。清楚谁在哪一层,后面排错时才知道该去哪层找问题。
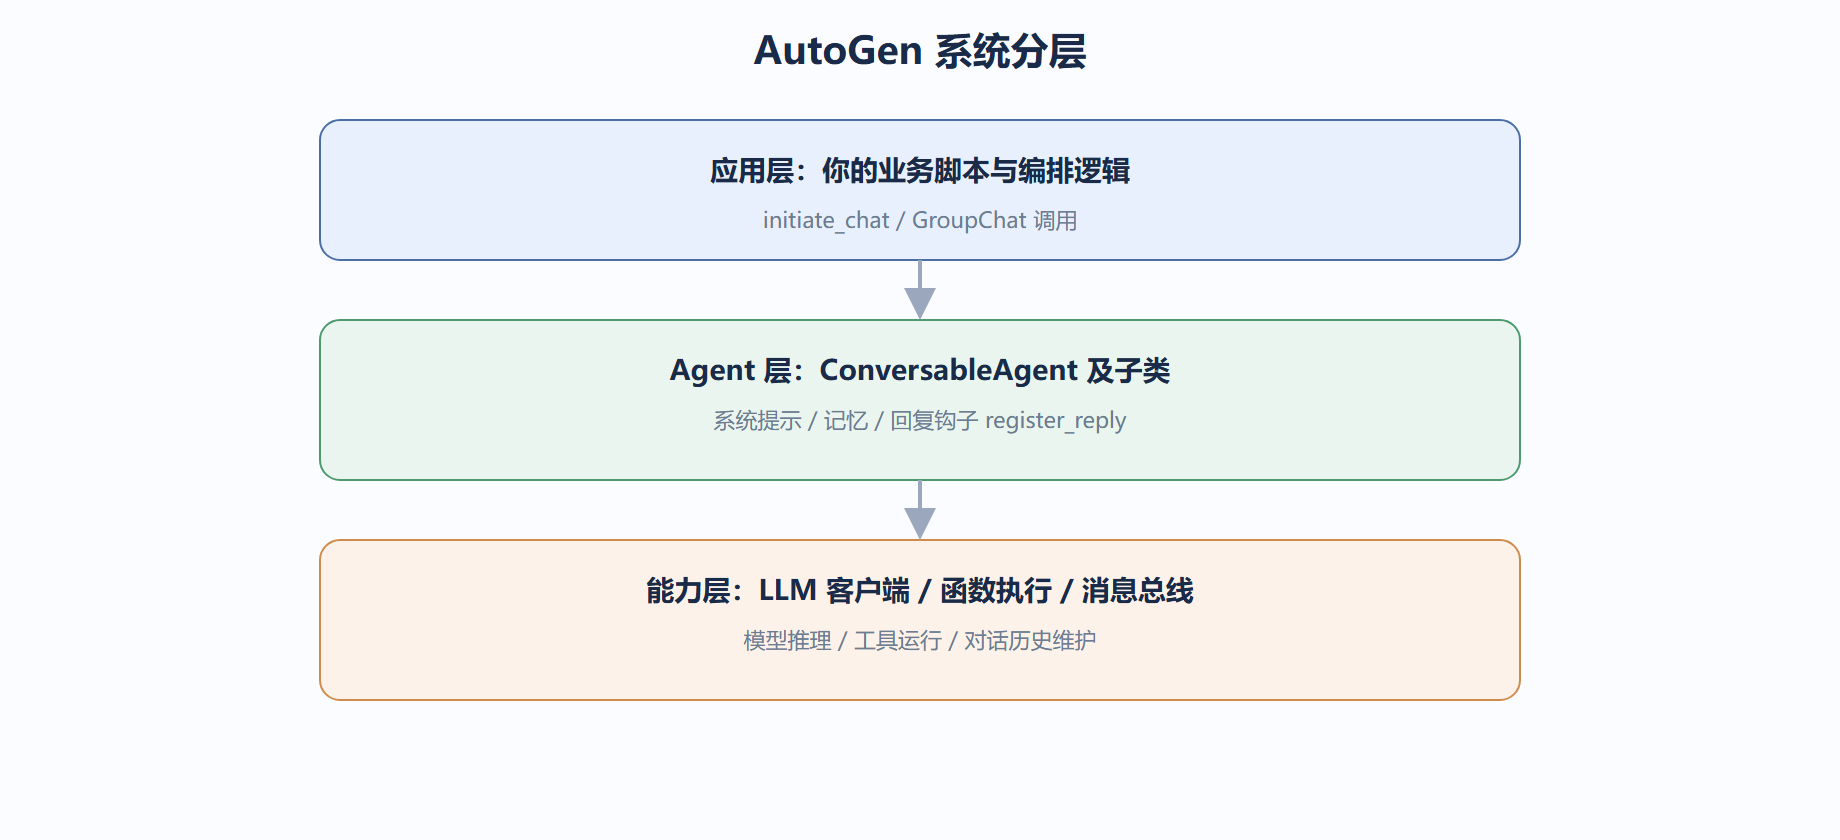
应用层:你写的胶水
你 import 框架、创建 Agent、调用 initiate_chat,这些都在应用层。这一层越薄越好——业务逻辑尽量交给对话涌现,而不是堆在这里的 if/for。我们见过把流程全写死在应用层的项目,最后和手写脚本没区别,白用了框架。
Agent 层:角色与记忆
每个 Agent 持有系统提示(定义它是什么角色)、记忆(对话历史的一部分)和回复钩子。钩子是 AutoGen 很有用的扩展点:你能注册一个函数,在 Agent 每次准备回复前或后插入自己的逻辑,比如记录、改写、拦截。
from autogen import ConversableAgent cfg = {"model": "gpt-4o-mini", "api_key": "YOUR_KEY"} agent = ConversableAgent("helper", llm_config=cfg, system_message="你乐于助人。") # 注册一个回复前钩子:打印每次将要发出的角色 def log_before(recipient, messages, sender, config): print(f"[{sender.name} -> {recipient.name}] 准备回复") return False, None # 返回 False 表示不拦截,继续正常回复 agent.register_reply(trigger=ConversableAgent, reply_func=log_before, position=0, config=None) # 之后每次该 agent 回复前都会先打印一行日志,方便你观察对话走向
能力层:推理与执行
最底层对接大模型客户端(负责把消息发给模型、拿回 completion)、函数执行器(跑你注册的工具)、消息总线(维护对话历史)。这一层你基本不用碰,但要知道"函数执行"默认在主进程里跑——这意味着执行危险代码会真的影响你的机器,第五章讲沙箱。
层与层之间怎么协作
一次对话的旅程:应用层调 initiate_chat → Agent 层生成回复(可能请求函数)→ 能力层调模型、跑函数 → 结果回写进 Agent 层记忆 → 再传给下一个 Agent。这套链路在 2.3、2.4 会拆得更细。
一个排错视角的例子
当你发现某 Agent 没收到预期消息,先在应用层确认 initiate_chat 调用方没错,再去 Agent 层看 register_reply 是否有人拦截,最后去能力层看模型调用是否报错。这个自顶向下的顺序能省掉一半盲目试错。
# 排错时用这段打印各层状态 from autogen import ConversableAgent import os cfg = {"model": "gpt-4o-mini", "api_key": os.environ.get("OPENAI_API_KEY")} probe = ConversableAgent("probe", llm_config=cfg, system_message="你回显收到的内容。") def echo(recipient, messages, sender, config): print("层: Agent | 最新消息来自:", sender.name) print("内容前30字:", str(messages[-1].get("content",""))[:30]) return False, None probe.register_reply(trigger=ConversableAgent, reply_func=echo, position=0) # 把它串进对话,能看清消息在层间怎么走
分层带来的工程红利
把框架切成三层,不只是为了画图好看,它直接决定了你的系统好不好维护。最关键的红利是"关注点分离":应用层只管"点哪把火",Agent 层只管"谁是什么角色",能力层只管"怎么调模型、怎么跑函数"。三层各改各的,互不牵连。比如你想换模型供应商,只动能力层的 llm_config,Agent 的角色定义一行不用动;你想加一个日志需求,只在 Agent 层挂个 reply 钩子,不用碰应用层业务代码。
另一个红利是可观测性。因为消息在层间是显式的字典,你能在任意一层打印它。对比手写脚本把"调模型、跑函数、拼结果"混在一堆过程代码里,出问题时你只能断点一步步走;而分层后,你可以让一个 probe Agent 只回显收到的内容,消息在哪层丢了、被谁改了,一眼可见。我们用交通来类比:分层就像把"发令(应用层)、司机(Agent 层)、车辆与道路(能力层)"分开,事故发生在哪一段,交警直接去那一段查,而不是整车拆开。
| 层 | 你该写什么 | 你不该写什么 | 排错先看这里当 |
|---|---|---|---|
| 应用层 | initiate_chat 的编排骨架 | 业务流程的 if/for 大杂烩 | 对话没发起、参数传错 |
| Agent 层 | 系统提示、钩子、记忆策略 | 模型推理细节 | 角色行为不对、钩子拦截异常 |
| 能力层 | llm_config、函数注册 | 模型客户端内部实现 | 调模型报错、函数执行失败 |
分层意识怎么落到日常改动
分层不是画完图就完事,它要变成你每次改代码时的默认检查:这次改动落在哪一层?比如你想"让某个 Agent 每次回复前记一笔日志",这是 Agent 层的钩子,加在 register_reply,不动应用层业务;你想"换一个便宜的模型供应商",这是能力层的 llm_config,Agent 角色定义一行不动;你想"把两段对话拼成一个工作流",这是应用层的编排,不要因此往 Agent 里塞流程判断。养成这个习惯,你的系统改起来才不至于牵一发动全身。
反例很常见:有人为了"快速实现",把模型调用和业务流程全写在应用层一个大函数里,跑是跑通了,但等要加第二个角色、要换模型、要加日志时,每动一处都要通读整段,分层带来的红利全部丧失。所以分层是"前期多想一点、后期少改一片"的投资。这一章的架构概览,目标就是让你从第一次写 Agent 起就站在三层的坐标系里思考。
本节要点回顾
- 三层:应用层(你的脚本)、Agent 层(角色与记忆)、能力层(推理执行)。
- 应用层越薄越好,逻辑交给对话涌现。
- register_reply 是插入自定义逻辑的关键钩子。
- 分层带来关注点分离与可观测性,排错按层自顶向下。
- 每次改动先问落在哪层,分层是前期投资后期省力。
⚠️ 别把整个业务流程硬编码进应用层,那会抵消框架的灵活性,调试也更难。
💡 分层图本身就是"对话即编排"的剖面:你的代码只在点火,火苗靠 Agent 层和能力层烧起来。