2.2 智能体模型:基类与内置类型
2.2 智能体模型:基类与内置类型
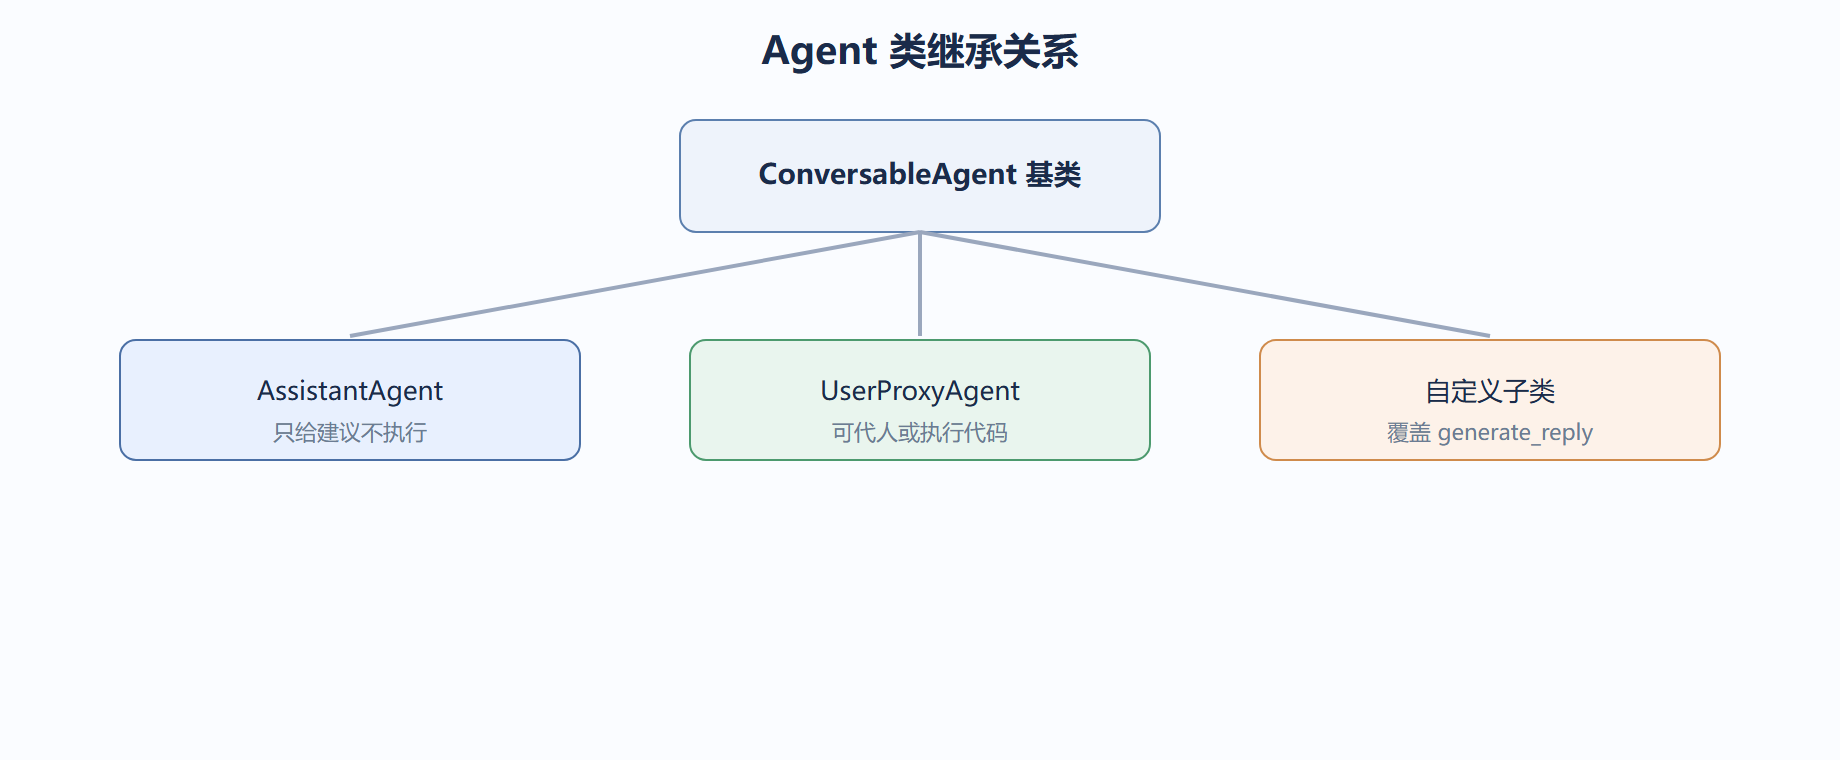
直接看类图,比读文字定义快。所有内置 Agent 都继承自 ConversableAgent——它提供了收消息、发消息、调模型、跑函数这套通用能力。子类只是在系统提示和默认行为上做了裁剪。
ConversableAgent:一切的起点
它是最通用的类,既能接模型也能不接。你用它做基类,或做"纯转发"的中介 Agent。它最关键的方法:generate_reply 决定怎么回,send 把消息发出去。
from autogen import ConversableAgent cfg = {"model": "gpt-4o-mini", "api_key": "YOUR_KEY"} # 基类用法:既能接模型,也能当无模型的中介 relay = ConversableAgent("relay", llm_config=None, # 不接模型 system_message="你只转发消息。")
AssistantAgent:只动口不动手
AssistantAgent 默认接模型,但不执行代码——它给出建议、给出函数调用请求,但不真去跑。适合当"军师"。上生产最安全,因为没法借函数执行搞破坏。
from autogen import AssistantAgent cfg = {"model": "gpt-4o-mini", "api_key": "YOUR_KEY"} advisor = AssistantAgent("advisor", llm_config=cfg, system_message="你给方案,不写可执行代码。") # advisor 只产出文本/函数调用建议,不会落地执行
UserProxyAgent:代人或代执行
UserProxyAgent 默认不接模型,它代表"用户"或"执行环境"。human_input_mode 控制它是否向你讨指令;设成 NEVER 且开了 code_execution 时,它会自动执行 AssistantAgent 请求的代码。这是双刃剑:方便,但危险。
from autogen import UserProxyAgent executor = UserProxyAgent( "executor", human_input_mode="NEVER", # 不询问,直接自动执行 code_execution_config={"use_docker": False}, # 真实场景建议用 docker 沙箱 function_map={"run_query": lambda sql: f"结果:{sql}"}, # 也可映射本地函数 ) # 当 advisor 请求执行某函数,executor 会真正调用并回写结果
怎么选
- 需要模型出主意 → AssistantAgent。
- 需要落地执行或人工介入 → UserProxyAgent。
- 需要完全自定义回复逻辑 → 继承 ConversableAgent 写子类(第三章讲)。
继承关系在实战里意味着什么
"都继承 ConversableAgent"这句话的含金量,很多初学者要踩过坑才懂。它的实际含义是:所有内置类共享同一套收消息、发消息、跑 reply 链的机制,子类只通过默认参数和默认行为做了裁剪。所以你给 ConversableAgent 写的钩子、对消息结构的理解,对 AssistantAgent 和 UserProxyAgent 完全通用——不用为不同类学两套 API。反过来说,如果你发现某个行为"只有 AssistantAgent 有、基类没有",那大概率是你的误解:基类其实都有,只是默认关着。
这带来一个选型心法:先问"这个角色要不要碰真实系统",再问"要不要模型出主意"。两个都要,就用 UserProxyAgent 接函数执行;只要出主意不要动手,就用 AssistantAgent;两者都不要(比如纯转发或做规则裁判),就用 ConversableAgent 配 llm_config=None。绝大多数"我该用哪个类"的问题,落到这三个问题就清楚了。需要更细的回复逻辑(比如根据对话轮次切换语气),那已经超出内置类范畴,得继承 ConversableAgent 写子类——第三章会专门讲。
| 需求 | 推荐类 | 原因 |
|---|---|---|
| 只出主意、不落地 | AssistantAgent | 默认接模型、不执行,最安全 |
| 要执行函数或等人指令 | UserProxyAgent | 可配自动执行或人工介入 |
| 纯转发/规则裁判/无模型 | ConversableAgent(llm_config=None) | 通用基类最灵活 |
| 回复逻辑高度定制 | 继承 ConversableAgent 写子类 | 覆盖 generate_reply |
换模型时,角色定义要不要动
"Agent 独立于模型"这句话在选型里很实用:当你想把助理从贵的模型换成便宜的,只需改 llm_config 里的 model 字段,角色的 system_message、注册的钩子、记忆策略全都不用动。这是分层架构给的红利——模型是可替换的"引擎",角色是稳定的"司机"。但有个前提:不同模型的能力差异会影响角色表现。比如把需要复杂推理的 reviewer 换成弱模型,它挑刺质量会掉,这时你不是改角色定义,而是重新评估"这个角色配哪个模型合适"。所以换模型后,要回到角色职责去验收,而不是只看"能跑"。
另一个常被问的:同一个对话里不同 Agent 能不能用不同模型?能。coder 用强模型保证代码正确,reviewer 用稍弱模型省成本,只要各自 llm_config 独立即可。这正是"角色独立、模型可配"设计的好处——你按角色价值分配算力,而不是全体一刀切。这在第五章讲成本优化时还会用到。
本节要点回顾
- 三个内置类都继承 ConversableAgent。
- AssistantAgent 只动口,UserProxyAgent 可动手或代人选。
- 选类看"要不要执行",不是看"聪不聪明"。
- 继承意味着钩子与消息机制通用,选型先问"碰不碰真实系统"。
- 换模型只改 llm_config,但需回角色职责验收;不同角色可配不同模型。
⚠️ UserProxyAgent 开了自动执行又不用沙箱,等于给模型你机器的操作权,务必谨慎。
💡 基类统一了"收发消息"的能力,子类只差异化"动不动手"——这就是对话即编排里角色分工的底层支撑。