2.3 消息传递与通信协议
2.3 消息传递与通信协议
消息是怎么流动起来的?我们用一张时序图把一次"助理给建议、执行者落地"的往返画出来。看懂这张图,你之后排错就有坐标了——哪一步卡住,对应图里哪根线。
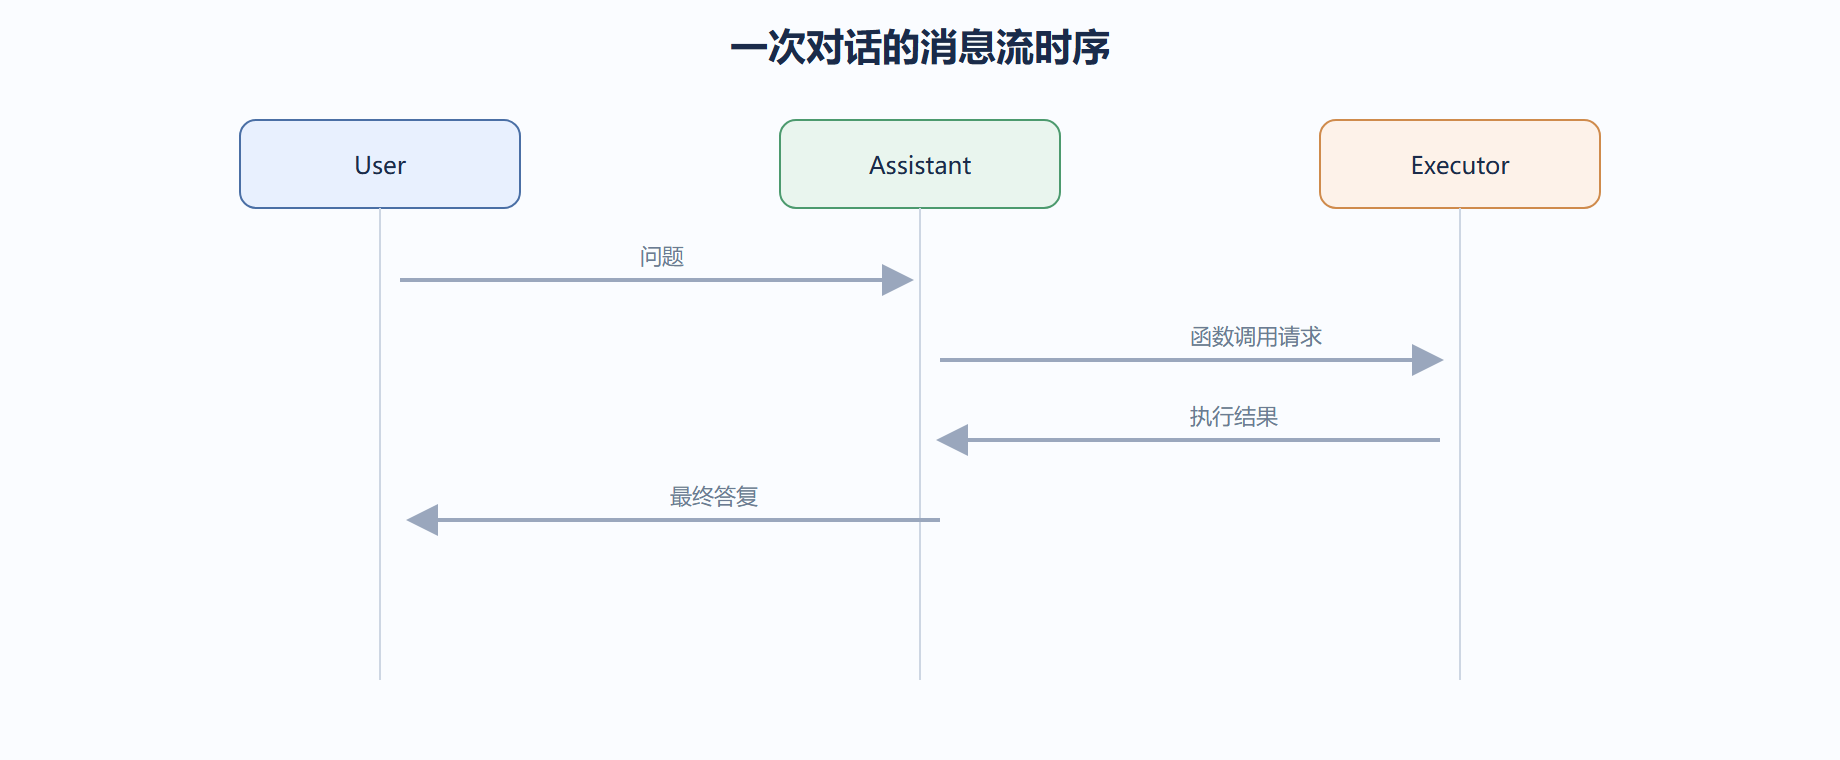
消息的结构
每条消息是一个字典,至少含 role(或 name)和内容 content。当涉及函数调用时,content 里会带函数名和参数,模型返回的结果也会以另一条消息回写。第一章 1.3 讲过概念,这里看代码形态。
from autogen import AssistantAgent, UserProxyAgent cfg = {"model": "gpt-4o-mini", "api_key": "YOUR_KEY"} assistant = AssistantAgent("assistant", llm_config=cfg, system_message="你调用工具回答问题。") user = UserProxyAgent("user", human_input_mode="NEVER", code_execution_config={"use_docker": False}) chat = user.initiate_chat(assistant, message="帮我算 3 乘 4。", max_turns=2) for m in chat.messages: who = m.get("name") or m.get("role") body = str(m.get("content"))[:60].replace("\n", " ") print(f"{who:>10} | {body}") # 你会看到 assistant 发出带函数调用的内容,user 发出执行结果,再 assistant 总结
发送与接收:send 和 receive
Agent 之间通过 send 把消息推给目标,目标 receive 后决定是否回复。initiate_chat 只是帮你发起第一轮并自动接力后续轮次。理解这点很重要:所谓"对话流",本质是 send/receive 在循环。
reply 链:一次回复怎么被算出来
当一个 Agent 收到消息,它会按顺序询问注册的 reply 函数(register_reply)。某个函数返回 (True, content) 就采用该回复并停止;返回 (False, None) 就跳过看下一个。这个链让你能在模型回复之前插入规则、之后做改写。
from autogen import ConversableAgent cfg = {"model": "gpt-4o-mini", "api_key": "YOUR_KEY"} agent = ConversableAgent("a", llm_config=cfg, system_message="你是助手。") # 规则优先:如果用户说"停止",直接拦截,不调模型 def block_stop(recipient, messages, sender, config): last = messages[-1].get("content", "") if "停止" in str(last): return True, "已按要求停止。" # 拦截成功 return False, None agent.register_reply(trigger=ConversableAgent, reply_func=block_stop, position=0) # position=0 表示最先检查
通信协议的本质
AutoGen 没有用特殊二进制协议,消息就是普通字典,在历史里追加。这种"朴素"带来一个好处:你能直接打印、存盘、回放任何一段对话,调试极其方便。代价是长对话占内存,第五章讲截断策略。
reply 链的两个实战陷阱
reply 链看着简单,真用起来有两个坑很高频。陷阱一:position 没排好,规则永远轮不到。比如你注册了一个拦截"停止"的钩子,却把它放在默认模型回复之后(position 较大),那模型已经先回了,拦截形同虚设。记住 position 小的先执行,要拦截就必须 position=0。陷阱二:多个钩子都返回 (True, content),只有第一个生效,后面的永远不会跑——所以钩子之间要有清晰的优先级,别指望"都生效"。
还有一个和群聊强相关的点:消息顺序在群聊里不是由 send 决定,而是由 GroupChatManager 决定(第四章 4.2)。很多人在点对点对话里习惯了"谁 send 谁先到",到了群聊发现顺序和自己想的不一样,就以为出 bug。真相是:点对点里 send 决定顺序,群聊里管理器决定顺序,打印 history 才是唯一真相来源,别凭想象猜。
| 环节 | 谁负责 | 你常在这里出的问题 |
|---|---|---|
| 消息产生 | 模型或函数或人工 | 内容形态不符合预期(如函数参数缺失) |
| 消息发送 | send 调用方 | 发错目标、漏发 |
| reply 链 | 接收方注册的钩子 | position 排错导致规则失效 |
| 历史追加 | 消息总线 | 群聊顺序与想象不符 |
| 结果回写 | 函数执行器/模型 | 返回值没塞回对话导致断流 |
消息体里那些容易忽略的字段
前面说消息是"至少含发送者和内容的字典",但实际消息还带着几个对你调试很有用的隐藏信息。比如函数调用的消息里,除了参数还会有标识这次调用身份的信息,模型返回结果时靠它把"哪次调用的结果"对回"哪次请求"——如果你自己拼消息或回写结果,漏了这层对应,对话就会断流或串味。再比如消息里常带表明来源种类的字段,让你能区分"这是模型生成的"还是"这是函数执行回来的",打印日志时分开着色,一眼能看出对话是在"想"还是在"做"。
理解这些字段的意义在于:当你要做消息回放(5.3)或跨框架传数据(7.2)时,知道哪些字段必须保留、哪些可以丢弃。回放时若丢了函数调用的对应信息,复现出来对话就会和当初跑歪的那次对不上,排查白做。所以别把消息当成"一段文本"敷衍处理,它是一份带结构的数据包,尊重它的结构,调试和集成都顺。
本节要点回顾
- 消息是字典,含发送者和内容;函数调用也走同一结构。
- 对话流 = send/receive 循环,initiate_chat 自动接力。
- reply 链按 position 顺序尝试,可插规则拦截模型。
- 拦截钩子必须 position=0;群聊顺序由管理器定,以 history 为准。
- 消息还有调用对应、来源种类等字段,回放与跨框架传输需保留结构。
⚠️ 别假设消息顺序永远符合你预期,群聊里顺序由管理器定,打印 history 才是真相来源。
💡 消息即数据,对话即编排——你能存、能重放这段数据,正是这套设计好调试的根。