6.1 常见应用场景案例分析
6.1 常见应用场景案例分析
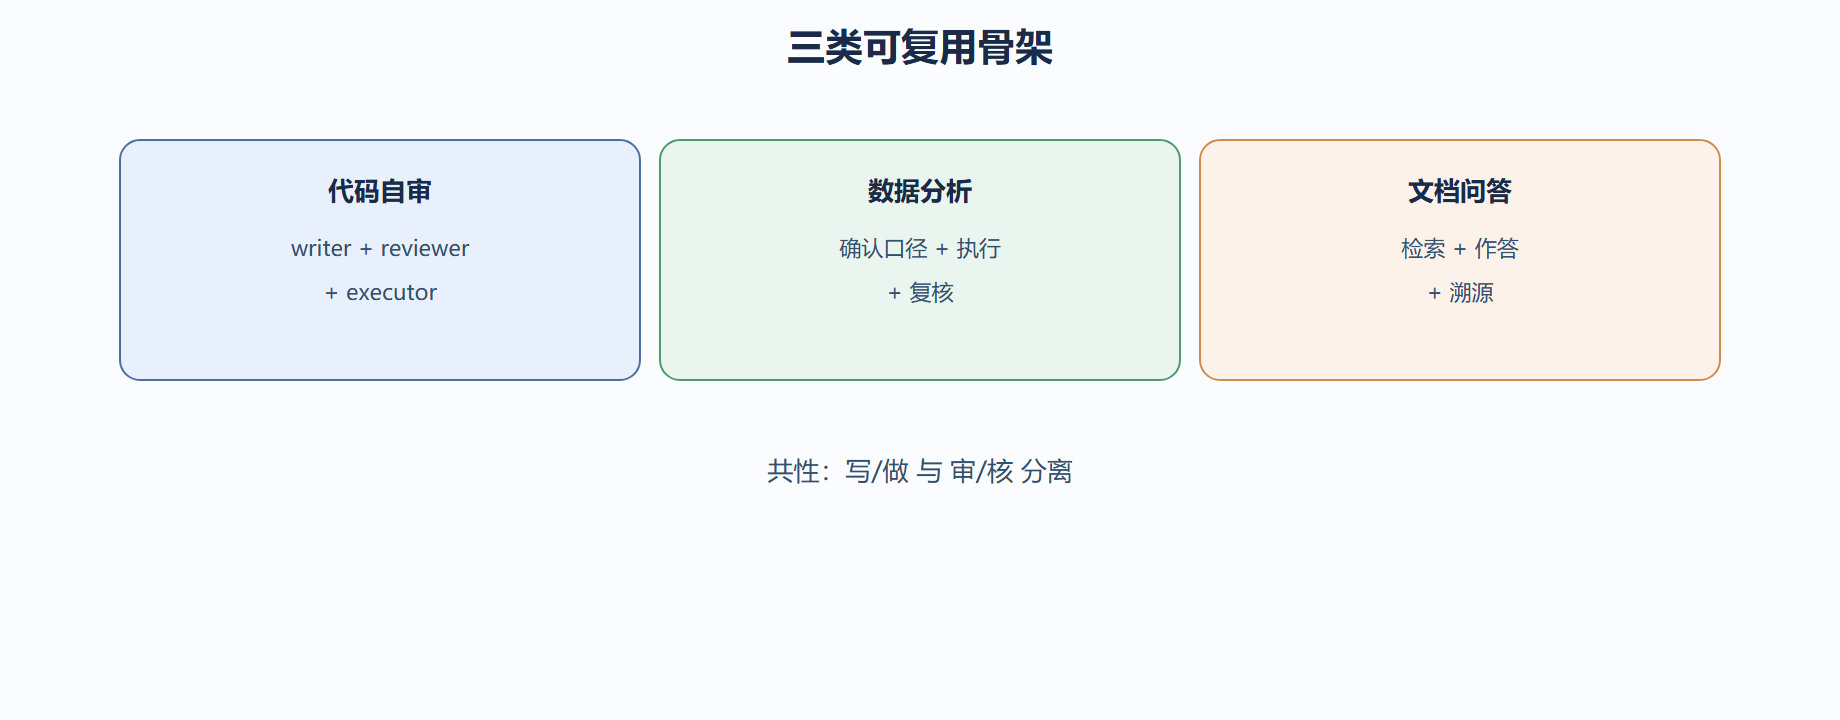
光讲机制不够,得看真实骨头长什么样。这一节给三个能直接抄结构的案例:代码自审、数据分析助手、文档问答。每个都按"背景→操作→结果→解读→变式"走,方便你映射到自己的业务。
案例一:代码生成与自审
背景:团队要快速产出可用脚本,但单 Agent 写的代码常漏边界。
操作:writer 出代码,reviewer 挑问题,executor 跑。
结果:一次跑通率提升,review 环节指出空文件未处理。
解读:质量来自"写"和"审"是两个独立视角,而非一个脑子分饰。
变式:加 tester Agent 专跑测试,形成写-审-测三角色。
from autogen import AssistantAgent, UserProxyAgent import os cfg = {"model": "gpt-4o-mini", "api_key": os.environ.get("OPENAI_API_KEY")} writer = AssistantAgent("writer", llm_config=cfg, system_message="你写 Python,注意边界。") reviewer = AssistantAgent("reviewer", llm_config=cfg, system_message="你只挑代码毛病。") executor = UserProxyAgent("executor", human_input_mode="NEVER", code_execution_config={"use_docker": False}) chat = writer.initiate_chat(reviewer, message="写读 csv 算均值的函数。", max_turns=4) # 再让 executor 接手跑代码(此处省略衔接,详见第四章群聊)
案例二:数据分析助手
背景:业务方用自然语言提数,但常因口径不清返工。
操作:确认 Agent 先对齐"销售额含不含退",执行 Agent 跑查询,复核 Agent 查口径一致。
结果:返工率降,口径错误被提前拦下。
解读:把"对齐"做成独立角色,比让一个 Agent 又对齐又跑更准。
变式:把执行换成真实数据库函数(见 5.5)。
案例三:文档问答与溯源
背景:员工问制度,答案要对且能查原文。
操作:检索 Agent 找片段,作答 Agent 组织,溯源 Agent 标引用。
结果:答案可核验,幻觉下降。
解读:"答得准"和"答有据"分开保证。
变式:检索换成向量库,适配大文档。
三个案例的共性
写/做 与 审/核 的角色分离,是质量提升的统一来源。你自己的业务,先找"哪里需要第二双眼睛",就把那个角色拆出来。
一个文档问答的代码骨架
把检索包成函数注册给作答 Agent,溯源 Agent 在最后标注引用,三者分离。
from autogen import AssistantAgent, UserProxyAgent import os cfg = {"model": "gpt-4o-mini", "api_key": os.environ.get("OPENAI_API_KEY")} def retrieve(q: str) -> str: """从知识库取相关片段。""" return "片段:退款见第三章第四条。" answerer = AssistantAgent("ans", llm_config=cfg, functions=[retrieve], system_message="先检索再作答,并标注引用。") gate = UserProxyAgent("gate", human_input_mode="NEVER", code_execution_config={"use_docker": False}) chat = answerer.initiate_chat(gate, message="退款政策是什么?", max_turns=2) # 作答会带引用,幻觉率明显下降
怎么把案例映射到自己的业务
三个案例不是让你照抄,而是给你一套"拆角色"的方法论。映射时分三步走。第一步,列出你业务里的"产出环节"和"把关环节"——凡是一个环节既产出又自查的,质量都靠不住,因为没人挑刺。第二步,把每个"把关"独立成一个 Agent:代码自审里是 reviewer,数据分析里是口径复核,文档问答里是溯源。第三步,决定这些角色怎么协作(顺序还是群聊,见第四章),原型期用最少角色跑通主路径,别一上来铺满。
用一个判断句收口:你的业务里"哪里需要第二双眼睛",就把那个角色拆出来。写营销文案的,拆个"合规审核";做报表的,拆个"口径对齐";答客户问题的,拆个"事实溯源"。拆得对,质量提升来自视角独立,和模型聪不聪明无关——这点在三个案例的"解读"里反复出现,是第六章最想让你带走的认知。反例是"把写和审放同一个 Agent",那等于没审,框架下质量提升的机制就失效了。
还有个常见误用:把案例当成品直接套。案例给的是结构骨架,你的业务词、数据接口、终止条件都得自己填。照搬代码却没想清自己该拆几个角色,等于把别人的边界假设套到自己身上,出错时更难查。正确用法是"抄结构、换血肉"——骨架照用,角色职责按你的真实环节重写。
| 你的业务环节 | 可拆出的把关角色 | 参考案例 |
|---|---|---|
| 写代码 | 审稿 Agent / 测试 Agent | 案例一 |
| 提数分析 | 口径对齐 Agent / 复核 Agent | 案例二 |
| 问答客服 | 检索 Agent / 溯源 Agent | 案例三 |
| 出文案 | 合规审核 Agent | 套用"做事+审核"模式 |
本节要点回顾
- 三类骨架都靠"做事"与"审核"分离提质量。
- 案例可直接抄结构,换业务词即可。
- 找"需要第二双眼睛"的环节来拆角色。
- 映射走三步:列环节→拆把关→定协作;抄结构不抄成品。
⚠️ 把"写"和"审"放同一个 Agent,等于没审,质量提升主要来自角色独立。
💡 案例是"对话即编排"的成品样板——编排的甜区,就是让不同视角互相挑刺。