6.2 从概念到部署:项目生命周期
6.2 从概念到部署:项目生命周期管理
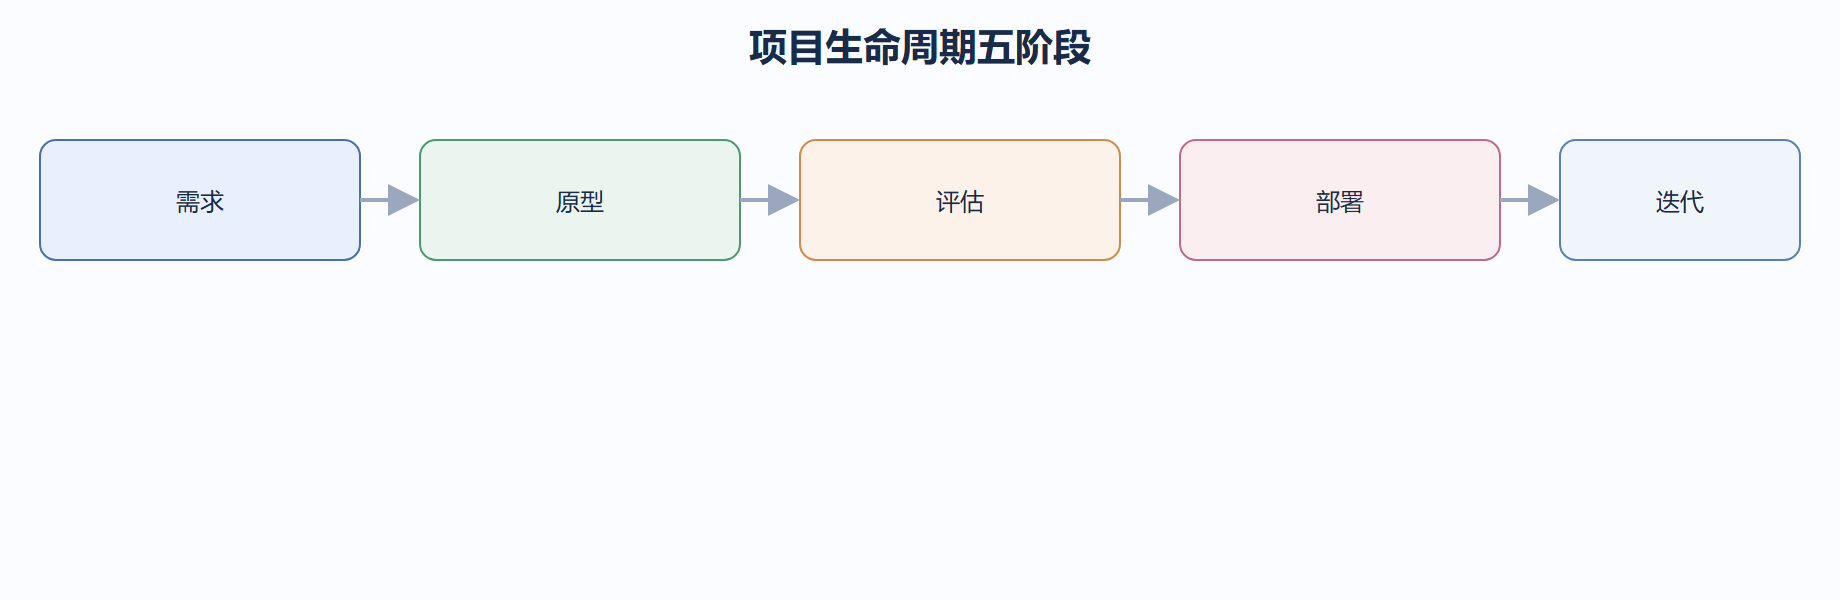
从想法到上线,一个多智能体项目要过五道关。跳过任何一道,上线后都会以某种方式找回来。这一节按阶段讲每关该做什么、用什么 AutoGen 能力。
阶段一:需求——先判断适不适合
用第一章的"三特征"(多角色、有来回、可中断)筛。不适合就别硬上,省时间。
检查点:任务是否真需要多角色协商?直线批处理请用手写脚本。
阶段二:原型——最小骨架跑通
用内置 Agent 搭最小组合(脑+手),ALWAYS 模式逐轮看(4.5)。目标是验证"对话能推进任务",不是追求完美。
检查点:能否用最少角色跑通一条主路径?
阶段三:评估——量化质量
加评估 Agent(4.4),对产物打分或给通过/不通过。用一小批真实样本测完成率和返工率,决定要不要加角色或调提示。
检查点:质量是否达到上线阈值?瓶颈在写还是审?
阶段四:部署——加固与隔离
开缓存(5.1)、沙箱执行(5.4)、会话隔离(5.2)、加日志(5.3)。human_input_mode 切 TERMINATE 留刹车。
检查点:能否扛并发?危险操作是否有人确认?
阶段五:迭代——监控驱动优化
上线后看监控指标(6.4),哪类任务失败多就针对性加角色或改提示。多智能体系统不是一次成型,是养出来的。
# 部署期把执行切到沙箱、模式切 TERMINATE 的示例 executor = UserProxyAgent("exec", human_input_mode="TERMINATE", code_execution_config={"use_docker": "python:3.11-slim"}) # 平时自动,关键处人拍板,配合 5.4 安全边界
一个评估阶段的量化示例
评估不是"感觉还行",而是用样本算通过率。下面示意对一批任务跑评估 Agent 打分。
from autogen import AssistantAgent import os cfg = {"model": "gpt-4o-mini", "api_key": os.environ.get("OPENAI_API_KEY")} evaluator = AssistantAgent("eval", llm_config=cfg, system_message="对给定产物给 通过 或 不通过 及一句话理由。") samples = ["任务A", "任务B", "任务C"] pass_count = 0 for s in samples: # 假设 run_task 返回产物,交给 evaluator 判 verdict = evaluator.initiate_chat(evaluator, message=f"评估: {s}", max_turns=1) if "通过" in str(verdict.messages[-1].get("content","")): pass_count += 1 print(f"通过率 {pass_count}/{len(samples)}") # 通过率低于阈值就回头改提示或加角色,而非直接上生产
迭代阶段的监控驱动
上线后看 6.4 的四个指标,哪类任务失败多就针对性优化。比如"数据分析类"完成率掉,可能是口径 Agent 提示不清,就单独改它、重新评估。多智能体系统是养出来的,不是一次成型。
每个阶段最常栽的坑
五阶段看着清楚,真做起来每个都有典型翻车点。需求阶段:团队带着"框架热"硬上,明明是直线批处理也拆多 Agent,结果延迟翻倍质量没升——记住"三特征"筛不过就别上。原型阶段:一上来就设计完美架构,加五六个角色,结果运行时才暴露协作问题,纸面设计全错——正确做法是最小骨架先跑通主路径。评估阶段:凭"感觉还行"就部署,没有通过率基线,上线后出问题分不清是提示差还是架构差。部署阶段:忘了开沙箱和日志,危险操作自动执行,出事无现场可查。迭代阶段:上线即搁置,不看监控,系统悄悄退化没人发现。
这五个坑有个共同根因:把生命周期当"走流程"而不是"逐关设检查点"。每一关的"检查点"不是形式,是用来在最低成本处拦住问题的闸门。需求关拦住"不该上框架的",比上线后重构省力一百倍;评估关拦住"质量不达标",比用户投诉后回滚省力一百倍。所以我们反复强调:阶段可以快,但检查点不能省,跳过的关会以更高代价在后面找回。
| 阶段 | 典型坑 | 检查点如何拦 |
|---|---|---|
| 需求 | 直线任务硬拆多 Agent | 三特征筛不过就否 |
| 原型 | 完美架构一次铺满 | 最小骨架先跑通 |
| 评估 | 凭感觉上线无基线 | 通过率低于阈值回头改 |
| 部署 | 忘沙箱忘日志 | 扛并发+危险操作人确认 |
| 迭代 | 上线即搁置 | 监控驱动针对性优化 |
评估样本怎么选才有代表性
评估阶段(阶段三)说"用一小批真实样本测通过率",但样本怎么选直接决定结论可信度。坑一:只挑简单任务测,通过率虚高,上线遇到难的就崩——样本要覆盖难中易,尤其包含你最担心的边界情况。坑二:样本全是同一类,比如都问"查销售额",模型在这类上练过就显高,换个问法就露怯——样本要多样,逼近真实分布的混合。坑三:样本量太小(两三个),一次偶然就颠覆结论——够量才有统计意义,具体多少看任务波动,但至少够看到趋势。
评估还要区分"完成率"和"质量分":完成率看产物是否跑通、是否答了所问;质量分看答得对不对、边界处理得好不好。两者常不同步——一个任务"完成了但答错"比"没完成"更危险,因为前者会悄悄流入生产。所以评估 Agent(4.4)最好同时打两个维度,阈值分别设。这套量化不是一次性的,部署后监控(6.4)会持续用同样的口径,前后一致才能看出退化。
本节要点回顾
- 五阶段:需求→原型→评估→部署→迭代,缺一不可。
- 原型用最小骨架,评估用量化,部署重加固。
- 系统是养出来的,靠监控迭代而非一次成型。
- 每阶段有典型坑,检查点是低成本拦截闸门。
- 评估样本覆盖难中易、多样够量,完成率与质量分分开设阈。
⚠️ 跳过评估阶段直接部署,质量无基线,出问题分不清是提示差还是架构差。
💡 生命周期管理让"对话即编排"从 demo 变成可运营的系统,每关都对应前面某章能力。