1.1 定义与核心价值
在体系位置里,这一节是第一章的入口:先不谈架构,只回答"Chroma 到底是什么、解决了哪类问题"。我们从反例出发——你手里有一堆文本,想按意思找,传统手段为什么不够用。
先说一个会翻车的做法
假设我们用 SQLite 存了一千条技术文档,用户问"怎么做向量检索"。最直觉的写法是:
## 反例:用关系型数据库做语义检索 import sqlite3 conn = sqlite3.connect(":memory:") conn.execute("CREATE TABLE docs(id INTEGER, text TEXT)") conn.execute("INSERT INTO docs VALUES (1, '用 HNSW 图做近似最近邻检索')") conn.execute("INSERT INTO docs VALUES (2, '把高维向量存进索引再查最近的点')") ## 用户问句和文档字面不同,LIKE 命中率很低 rows = conn.execute("SELECT * FROM docs WHERE text LIKE '%向量检索%'").fetchall() print(rows) ## 输出: [(1, '用 HNSW 图做近似最近邻检索')] ## 第 2 条其实也相关,但字面没有'向量检索'四个字,漏掉了
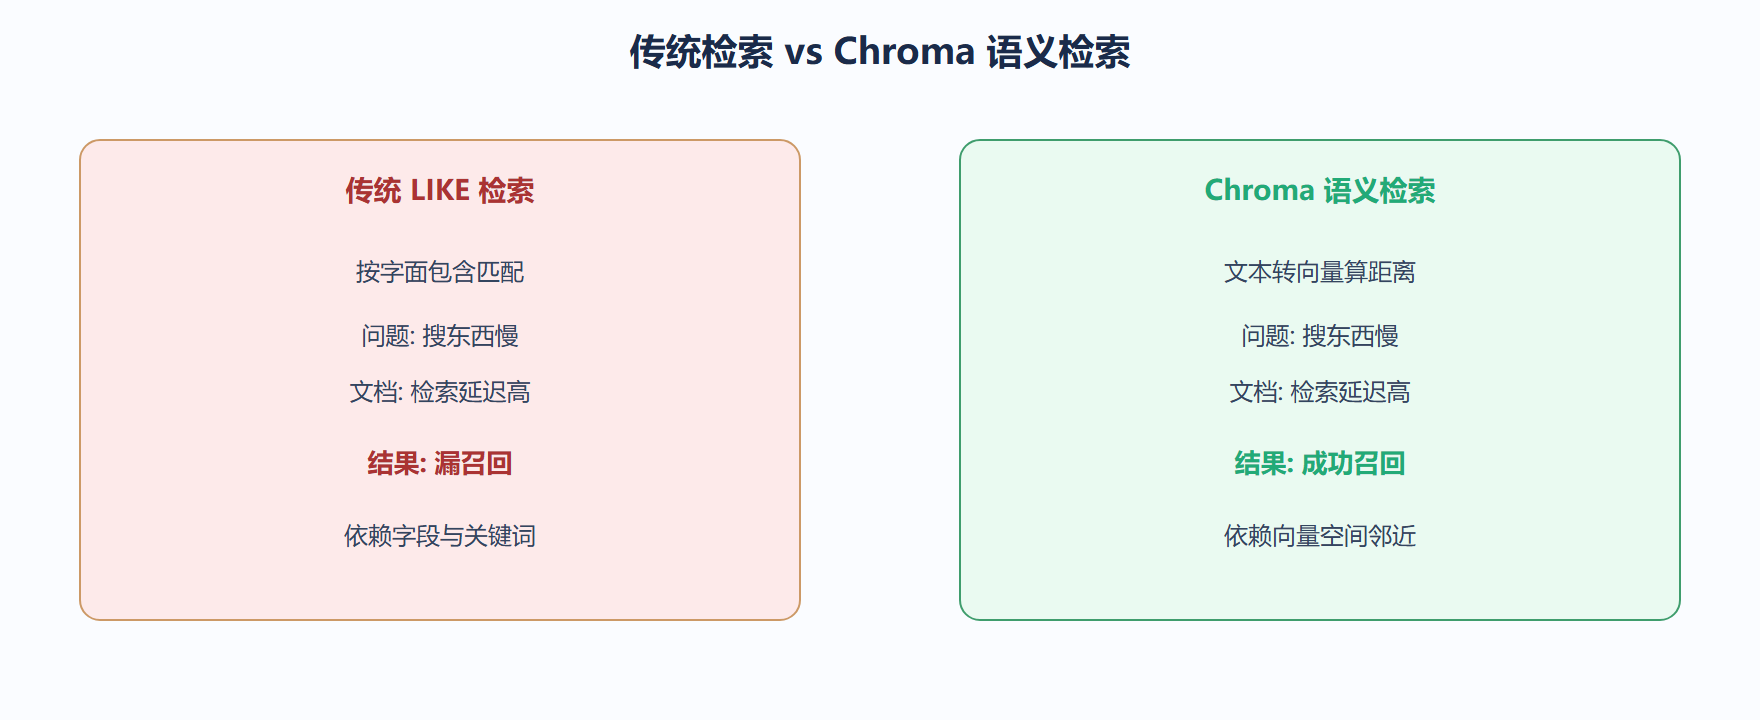
这个例子的坑在于:它靠"字面包含"匹配,而语义检索要的是"意思接近"。第二条讲的事情和"向量检索"明显是一回事,却因为用词不同被丢掉。Chroma 的价值,就是用向量把"意思"变成可计算的距离。
Chroma 做对了什么
它把每条文本先送进嵌入模型,变成一串几百维的浮点数。意思接近的文本,这串数字在空间中离得近。查询时也把问题变成向量,找空间里离它最近的几个,再取出对应的原文。这样第二条文档就能被召回。
## 正解:用 Chroma 做语义召回 import chromadb client = chromadb.Client() col = client.create_collection("demo") col.add( ids=["d1", "d2"], documents=[ "用 HNSW 图做近似最近邻检索", "把高维向量存进索引再查最近的点", ], ) res = col.query(query_texts=["怎么做向量检索"], n_results=2) print(res["documents"]) ## 输出: [['用 HNSW 图做近似最近邻检索', '把高维向量存进索引再查最近的点']] ## 两条都回来,因为语义接近,不依赖字面匹配
对比上面两个片段,差异不在代码量,而在"检索的根据"变了:从字面相等变成了空间邻近。这就是 Chroma 的核心价值——让数据库按语义而非字段工作。
它和"再训一个模型"的区别
有人会问:那我直接微调个大模型记住这些文档不行吗?行,但代价是每次知识更新都要重训,成本高、时效差。Chroma 的思路是"外挂记忆":模型参数不变,知识存在向量库里,用的时候捞出来。这像建筑里的"主体结构"和"可更换的隔断"——承重墙不动,房间布局随时改。
一个完整的微型案例
背景:一个小团队要把内部 FAQ 做成能问答的机器人,问题表述和文档表述经常不一致。
操作:把 200 条 FAQ 写入 Chroma,每次用户提问先做 query 取 top3,再交给 LLM 组织答案。
结果:字面不匹配的问题(如用户打"搜东西慢"对应文档"检索延迟高")也能命中。
解读:召回层承担了"找相关资料"的活,生成层只管"把资料说成人话",职责清晰。
变式:如果 FAQ 经常改,把 add 换成 upsert,并按文档版本写入元数据 version,查询时过滤最新版即可。
我们怎么看它的定位
Chroma 不声称自己是分布式数据库,它明确选了"本地优先、开发者友好"的路线。这意味着它在中小规模、快速原型、单机 RAG 上体验极好,但在十亿级向量、多副本强一致上不是它的主战场。选它之前先问自己:我的数据量是不是单机扛得住?如果是,它几乎是最省心的那个。
深度对照:Chroma 不是"另一个数据库"
把 Chroma 和关系库、文档库放一起比,容易陷入"都是存数据"的误区。关键差异是:传统库按"字段"组织,Chroma 按"意思"组织。前者问"等于什么",后者问"接近什么"。这像电话簿按姓氏查人,vs 你描述长相让朋友猜是谁——两种检索逻辑根本不同。
理解这一点,就不会拿"支持事务吗""支持联表吗"去要求它。那些不是它的职责,强加上反而别扭。
## 用一句话区分两类系统的提问方式(非运行代码) questions = { "关系库": "哪些行满足 price < 100 ?", "Chroma": "哪些文档意思最接近'怎么查慢查询' ?", } for k, v in questions.items(): print(f"{k} 的提问: {v}") ## 关系库 的提问: 哪些行满足 price < 100 ? ## Chroma 的提问: 哪些文档意思最接近'怎么查慢查询' ?
一个边界提醒
Chroma 适合"找相关资料",不适合"做权威记账"。若你的系统既要语义检索又要强一致事务,正确架构是两者并存:向量库负责召回候选,主库负责按主键取权威记录。这像图书馆与档案馆合作——图书馆帮你找书,档案馆给你盖了章的原件。
⚠️ 常见坑:把唯一真相源放在向量库里。向量是派生产物,原始文档才是真相,丢了原文就失去重嵌与核对的依据。
💡 关键直觉:Chroma 的价值是"把意思变成可计算的距离"。记住这句话,你就不会在错误场景误用它,也不会在正确场景低估它。
案例:把"模糊问题"变成"可检索"
背景:客服系统里,用户常问"搜东西好慢",但知识库里写的是"检索延迟优化"。
操作:把知识库写入 Chroma,用户问句直接 query,取 top3 喂给应答模块。
结果:即便字面完全不同,"搜东西慢"也能命中"检索延迟"相关文档,首次解决率提升。
解读:这正是向量库存在的理由——它补上了字面匹配永远补不上的那块。这像翻译官,让说不同词的人听懂彼此。
变式:若同一问题有多篇相关文档,用元数据标"优先级",召回时优先返回官方最新解答。
本节要点回顾:Chroma 把"意思相近"变成可计算的向量距离,解决传统数据库按字面匹配导致的漏召回;它走本地优先路线,适合单机与中小规模语义检索。
⚠️ 不要把 Chroma 当万能存储:它不擅长做事务型强一致、不擅长十亿级分布式,选型时先估量数据规模。
💡 如果你已经在用关系库做 LIKE 搜索且效果够用,不必为了"上向量"而强上 Chroma——只在语义不匹配成为痛点时再引入。