1.2 发展历程与生态位分析
在体系位置里,这一节把 Chroma 放进"向量数据库赛道"里比一比。不看广告看坐标:它诞生的时间、它选的技术路线、它和几个主要对手的差别,决定了你在什么场景下该选它。
一个事实切入
2022 年底大模型走红后,RAG 成为把外部知识接进 LLM 的主流做法。但当时现成的向量存储要么偏重(要起集群),要么偏学术。Chroma 在 2023 年前后以"一行 pip 起本地库"的姿态出现,正好填补了"想要快速原型、不想运维"这块空白。它选的底层是 DuckDB 加 Parquet——前者是单机分析型引擎,后者是列存文件格式,两者都不需要独立服务进程。
和三个主要对手的横向比
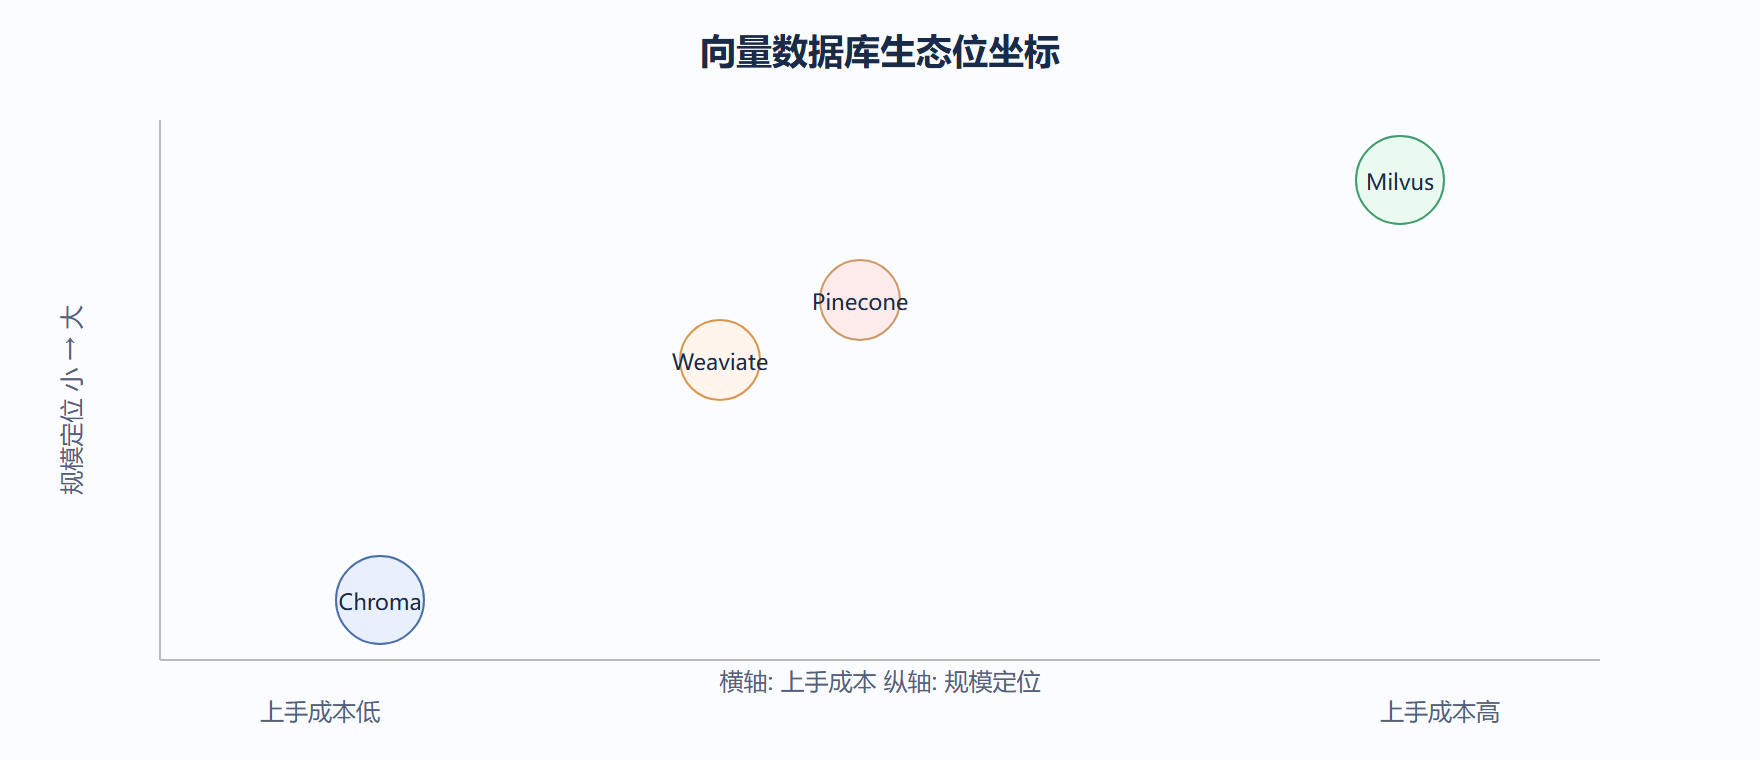
我们用一张对照表说清生态位,而不是空谈"各有优势"。
## 用结构化方式列出几个系统的取向差异(非运行代码,便于对照) systems = { "Chroma": {"部署": "嵌入式优先", "默认存储": "duckdb+parquet", "上手成本": "极低", "规模定位": "中小"}, "Milvus": {"部署": "分布式优先", "默认存储": "自研向量引擎", "上手成本": "较高", "规模定位": "超大"}, "Weaviate": {"部署": "服务端", "默认存储": "自研+对象存储", "上手成本": "中", "规模定位": "中大"}, "Pinecone": {"部署": "云托管", "默认存储": "闭源", "上手成本": "低", "规模定位": "中大"}, } for name, info in systems.items(): print(f"{name:9s} -> {info}") ## 输出: ## Chroma -> {'部署': '嵌入式优先', '默认存储': 'duckdb+parquet', '上手成本': '极低', '规模定位': '中小'} ## Milvus -> {'部署': '分布式优先', '默认存储': '自研向量引擎', '上手成本': '较高', '规模定位': '超大'} ## Weaviate -> {'部署': '服务端', '默认存储': '自研+对象存储', '上手成本': '中', '规模定位': '中大'} ## Pinecone -> {'部署': '云托管', '默认存储': '闭源', '上手成本': '低', '规模定位': '中大'}
这张表揭示了一个工程取舍:Chroma 把"上手成本"压到极低,代价是放弃了开箱即用的分布式能力。这和它的目标用户——研究者、初创团队、做原型的工程师——高度契合。
它为什么敢走"本地优先"
从物理存储的角度看,DuckDB 是进程内引擎,Parquet 是自描述列存文件。二者组合意味着:你的向量库就是硬盘上几个文件,复制、备份、版本管理都和管普通文件没两样。这像建筑里"用预制板"而非"现场浇筑"——交付快、挪动易,只是单栋承载力有限。Chroma 赌的就是:大多数 AI 应用的数据规模,单机就够。
案例:一个创业团队的选型过程
背景:五人团队要做法律咨询 RAG,文档约 80 万份,单机内存 64G。
操作:先用 Chroma 跑通原型,三个月后文档涨到 500 万,查询延迟从 20ms 升到 400ms。
结果:他们在 Chroma 里按案件类型分多个 Collection,配合元数据过滤把单查范围缩到十万级,延迟回到 60ms,没换数据库。
解读:生态位没选错——靠"分库 + 过滤"把单机压力拆小,比直接上分布式省了运维人力。
变式:若继续涨到千万级且多团队并发,那时再评估迁移到分布式方案,但原型期 Chroma 帮他们省了关键的两周。
我们看生态位的结论
Chroma 不是"万能向量库",它是"最快把想法跑起来"的那一档。当你需要的是验证一个语义检索点子、做教学、做单机 Agent 记忆,它几乎零阻力。当你确定要扛亿级向量和强一致多副本,应直接看分布式方案。选错档位的代价,往往是前两周很爽、后两月很痛。
用代码验证"本地优先"不是口号
光看定位表不够,我们用一行客户端实际感受"零配置起库":不写任何连接串、不起服务,库直接落在本地目录。
import chromadb, os if os.path.exists("./quick_chroma"): import shutil; shutil.rmtree("./quick_chroma") # 没有 host/port, 没有账号密码, 直接给个目录就够 cli = chromadb.PersistentClient(path="./quick_chroma") cli.create_collection("verify") print("库已落在:", os.path.abspath("./quick_chroma")) print("目录非空:", os.listdir("./quick_chroma") != []) # 输出: # 库已落在: /当前路径/quick_chroma # 目录非空: True
这个片段印证了前面生态位表里 Chroma 的"上手成本极低"——它不是营销语,而是 PersistentClient(path=...) 这一行就兑现了。对比需要起独立服务的方案,这里少了至少一次进程配置。
深度对照:生态位不是"功能多少"的较量
评估 Chroma 在赛道里的位置,别数它有多少功能,要看它"为谁、解决什么痛点"。它选的本地优先路线,本质是赌"大多数 AI 应用的数据单机就够"。这个赌对不对,取决于你的规模。这像便利店和仓储超市:便利店东西少但下楼就到,仓储超市全但要开车——不同生意选不同。
那些冲着"分布式海量"去的用户,本就不是 Chroma 的目标客群;冲着"今天就想跑通原型"的,它几乎是默认答案。
## 用'目标客群'看生态位(非运行代码) fit = { "快速原型/教学": "极契合", "单机Agent记忆": "极契合", " Ten亿级分布式": "不契合, 看别家", } for k, v in fit.items(): print(f"{k}: {v}") ## 快速原型/教学: 极契合 ## 单机Agent记忆: 极契合 ## Ten亿级分布式: 不契合, 看别家
一个边界提醒
"本地优先"不是"只能本地"。它只是默认形态零配置,当你真需要共享时仍有独立服务与托管路径。别被"嵌入式"标签限制想象——形态可演进,路线是起点不是终点。这像自行车能通勤,也能装上拖斗运货,形态随需扩展。
⚠️ 常见坑:因为"它起步简单"就默认它不能长大。规模跨过单机阈值前,及时评估独立服务或迁移,别等到事故倒逼。
💡 关键直觉:选 Chroma 前先问"我的数据量单机扛不扛得住"。扛得住,它是最省心的;扛不住,早看别家少走弯路。生态位选对,后续都顺。
案例:原型期省下的两周
背景:两人小团队要做内部知识问答,不确定需求能跑通。
操作:用 Chroma 本地优先当天起库,一周迭代出可用原型,验证了语义检索点子。
结果:确认方向后才投入更多资源,没在不确定时先搭复杂分布式,省下至少两周。
解读:生态位的价值在"低门槛验证"。先证实值得做,再决定做多大,是理性的工程节奏。这像先租后买,降低试错成本。
本节要点回顾:Chroma 在 2023 年前后以本地优先路线切入,填补快速原型空白;和 Milvus/Weaviate/Pinecone 比,它用 duckdb+parquet 换极低上手成本,代价是分布式能力。
⚠️ 别因为"原型好用"就默认它能扛生产级规模——规模跨过单机阈值前要重新评估。
💡 选型时先估数据量和并发,再用上表对号入座,能少走很多弯路。