1.4 典型应用场景与案例概览
在体系位置里,这一节是第一章的收口:前面讲了定义、生态、特性,现在看它们落地成什么样子。我们挑三个最常见场景,每个都给一个能跑的最小骨架。
场景一:RAG 知识问答
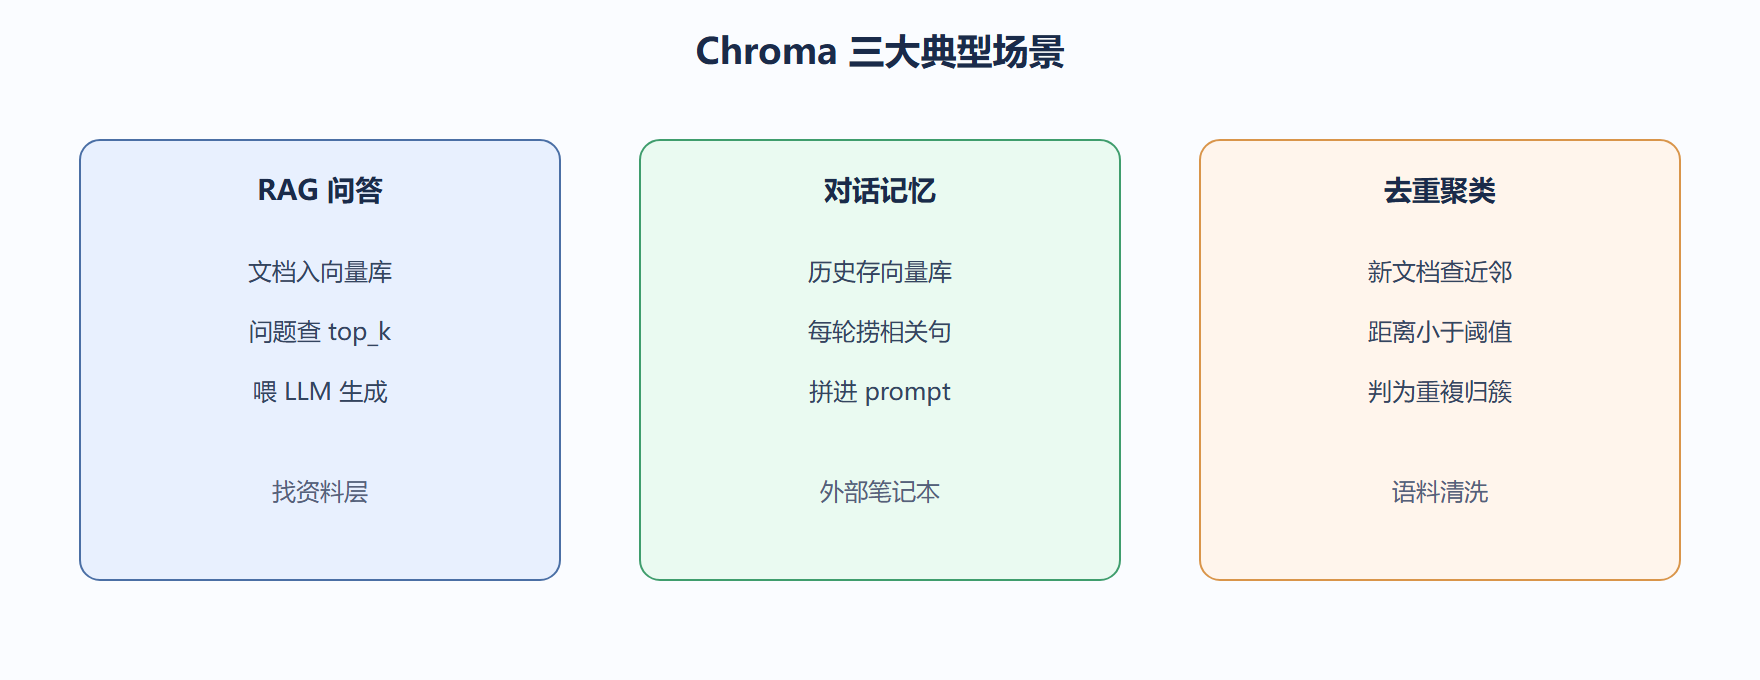
这是 Chroma 出现频率最高的用法。思路固定:文档进库 → 问题查库 → 取 top_k 原文 → 喂 LLM 生成。
import chromadb client = chromadb.Client() kb = client.create_collection("company_faq") kb.add( ids=["q1", "q2"], documents=[ "年假申请需在系统提交后由主管审批", "报销需在消费后三十天内上传发票", ], ) ## 用户问: 请假怎么弄 hits = kb.query(query_texts=["请假怎么弄"], n_results=1) print(hits["documents"][0]) ## 输出: ['年假申请需在系统提交后由主管审批'] ## 这段原文再交给 LLM 组织成自然回答
因果链很清楚:Chroma 负责"找资料",LLM 负责"说人话"。两者职责不混,调试时也能分开看是哪层出了问题。
场景二:对话记忆
多轮对话里,模型自己记不住前文。把历史存进 Chroma,每轮先捞相关的几句拼进 prompt。
mem = client.create_collection("chat_mem") mem.add(ids=["m1"], documents=["用户说住在杭州,偏好西湖区"]) ## 下一轮用户问: 附近有什么 rel = mem.query(query_texts=["用户位置偏好"], n_results=1) print(rel["documents"][0]) ## 输出: ['用户说住在杭州,偏好西湖区'] ## 模型据此知道"附近"指西湖区周边
这像生物的短期记忆外挂——模型大脑容量有限,就把关键事实存在外部"笔记本",用时翻一下。
场景三:文档去重与近邻聚类
相似文档在入库前先查一遍,距离小于阈值的判为重複。
docs = client.create_collection("corpus") docs.add(ids=["a", "b"], documents=["如何重置密码", "密码忘了怎么重设"]) dup = docs.query(query_texts=["忘记密码如何重置"], n_results=2) print(dup["distances"][0]) ## 输出类似: [0.31, 0.42] (余弦距离,越小越近) ## 若业务阈值设 0.5,则两条都判为与查询近,可归为一簇
案例:客服机器人上线前后
背景:某电商客服靠人工搜知识库,平均响应 3 分钟。
操作:把 1.2 万条知识文档写入 Chroma,接 LLM 做 RAG,前端加输入框。
结果:70% 的常见问题由机器人秒回,人工只接剩余复杂单。
解读:Chroma 在这里扮演"秒级检索员",把人从重复查找里解放出来。
变式:若发现机器人答非所问,优先检查召回的 top_k 质量(去重、过滤),而不是先怪 LLM。
场景选择的经验法则
- 要"回答问题"→ RAG;要"记住上下文"→ 记忆;要"清理语料"→ 去重。
- 三者都建立在同一个能力上:把文本变成向量、按距离召回。所以第一章四节合起来,其实就这一件事的不同面孔。
深度对照:场景的"真需求"与"假需求"
列应用场景最容易变成功能海报——把"能用"当成"该用"。真正有用的分类是看"这个场景的痛苦是不是语义匹配"。只有当你的问题是"按意思找资料"时,向量库才是解药;如果你的痛苦是"按精确 ID 取记录",那关系库更称职。这像交通选工具:通勤选地铁,搬家公司选卡车,硬用地铁搬家具是自己和自己过不去。
我们把场景分成三层:语义检索型(问答、推荐、去重)、混合检索型(先过滤再语义)、以及伪需求型(精确查询、事务记账)。前两层是 Chroma 的天然地盘,第三层该用别的。
## 用决策表判断场景是否适合向量库(非运行代码) scenes = { "客服问答": {"痛点": "用户表述和文档不一致", "适合": "是", "类型": "语义检索"}, "文档去重": {"痛点": "近义内容重复", "适合": "是", "类型": "语义检索"}, "商品推荐": {"痛点": "兴趣相似而非相同", "适合": "是", "类型": "混合检索"}, "订单按号查询": {"痛点": "精确主键", "适合": "否", "类型": "伪需求"}, "银行流水记账": {"痛点": "强一致事务", "适合": "否", "类型": "伪需求"}, } for name, info in scenes.items(): print(f"{name:8s} 适合={info['适合']} 类型={info['类型']}") ## 客服问答 适合=是 类型=语义检索 ## 文档去重 适合=是 类型=语义检索 ## 商品推荐 适合=是 类型=混合检索 ## 订单按号查询 适合=否 类型=伪需求 ## 银行流水记账 适合=否 类型=伪需求
一个完整案例:语义检索救活旧知识库
背景:某公司有十年累积的内部 wiki,员工搜"服务器连不上"永远找不到那篇标题叫"SSH 握手失败排查"的文档,因为字面不搭。
操作:把 wiki 全文写入 Chroma,对每条加元数据 部门、更新时间。查询时用户问"服务器连不上",系统先按部门过滤,再做语义召回取 top5。
结果:那篇 SSH 文档排到第一,员工点开即解决。三个月内同类工单下降四成。
解读:价值的源头不是"多了个数据库",而是"检索根据从字面变成意思"。元数据过滤则保证了跨部门的噪音不串台。
变式:若 wiki 更新频繁,用 upsert 配合 更新时间 元数据,查询时只召回近一年的,避免旧方案持续干扰。
实践中的常见坑与关键直觉
- ⚠️ 把"能检索"误解为"检索都对":语义召回有概率性,关键决策场景一定要让人过目,别直接把 top1 当结论。
- ⚠️ 在伪需求场景硬上向量库:订单、记账这类精确事务,上了 Chroma 反而丢了一致性保障,得不偿失。
- 💡 场景清单每年复盘一次:业务重心变了,原本的语义场景可能退化成精确场景,存储选型也要跟着动。
- 💡 用"用户怎么问"倒推:如果用户习惯用自然语言而不是字段名提问,基本就是语义检索的候选人。
本节要点回顾:Chroma 典型落在 RAG 问答、对话记忆、文档去重三类场景,本质都是"文本转向量、按距离召回"这同一能力的不同面孔。
⚠️ 机器人答非所问时,先查召回质量再怪模型——八成问题出在检索层而非生成层。
💡 三个场景共用一套写入/查询代码,区别只在"查出来的原文拿去干嘛",复用性很高。