1.3 关键特性与技术优势
在体系位置里,这一节把 Chroma 的宣传册式特性翻译成"对你写代码真正有用的点"。我们逐条验证,哪些是真价值,哪些需要打个问号。
特性一:四元组数据模型
Chroma 不让向量孤立存在,而是把 ids、documents、embeddings、metadatas 绑成一个语义单元。这避免了"查到向量却不知道对应哪段原文"的尴尬。
import chromadb c = chromadb.Client() col = c.create_collection("papers") col.add( ids=["p1"], documents=["量子纠缠是非局域的关联现象"], metadatas=[{"source": "arxiv", "year": 2023}], # embeddings 不传则自动用内置模型生成 ) print(col.get(ids=["p1"])["metadatas"]) ## 输出: [{'source': 'arxiv', 'year': 2023}]
这个设计的价值在于:查询返回的不只是距离,而是能直接用的"原文 + 上下文"。类似金融账户里"余额"必须和"流水"绑在一起,不能只存一个数。
特性二:元数据过滤
where 子句允许在向量检索前先按字段剪枝。这是很多纯向量库缺失的能力。
## 只看 2023 年 arxiv 来源、且语义相近的文档 res = col.query( query_texts=["非局域性是什么"], n_results=5, where={"source": "arxiv", "year": 2023}, ) print(len(res["documents"][0]), "条命中") ## 输出: 1 条命中
工程上这意味着你可以把"检索范围"先收窄,再算向量距离,既快又准。
特性三:内置嵌入函数
不传 embeddings 时,Chroma 用默认模型现算。对新手是福音,对生产要警惕——默认模型维度、语言覆盖可能不匹配你的数据。
## 显式指定嵌入函数,避免默认模型不透明 from chromadb.utils import embedding_functions ef = embedding_functions.DefaultEmbeddingFunction() col2 = c.create_collection("papers2", embedding_function=ef) ## 之后 add/query 都走同一函数,保证向量空间一致
特性四:本地优先与可移植
落盘是几个 Parquet 文件,复制即迁移。这点在第六章还会展开,这里先点出:它让"库"的边界和"文件"的边界重合,运维心智负担小。
案例:过滤带来的召回质量提升
背景:一个内部知识库混了技术文档和产品文档,用户问技术问题时总被产品文档干扰。
操作:给每篇加 type 元数据,查询时 where={"type": "tech"}。
结果:技术类问题的答案相关度明显上升,产品文档不再抢戏。
解读:元数据过滤不是锦上添花,而是多领域混合库里的"必选项"。
变式:若类型很多,可改用 $in 列表,或加 category 二级字段做层次过滤。
需要打个问号的"优势"
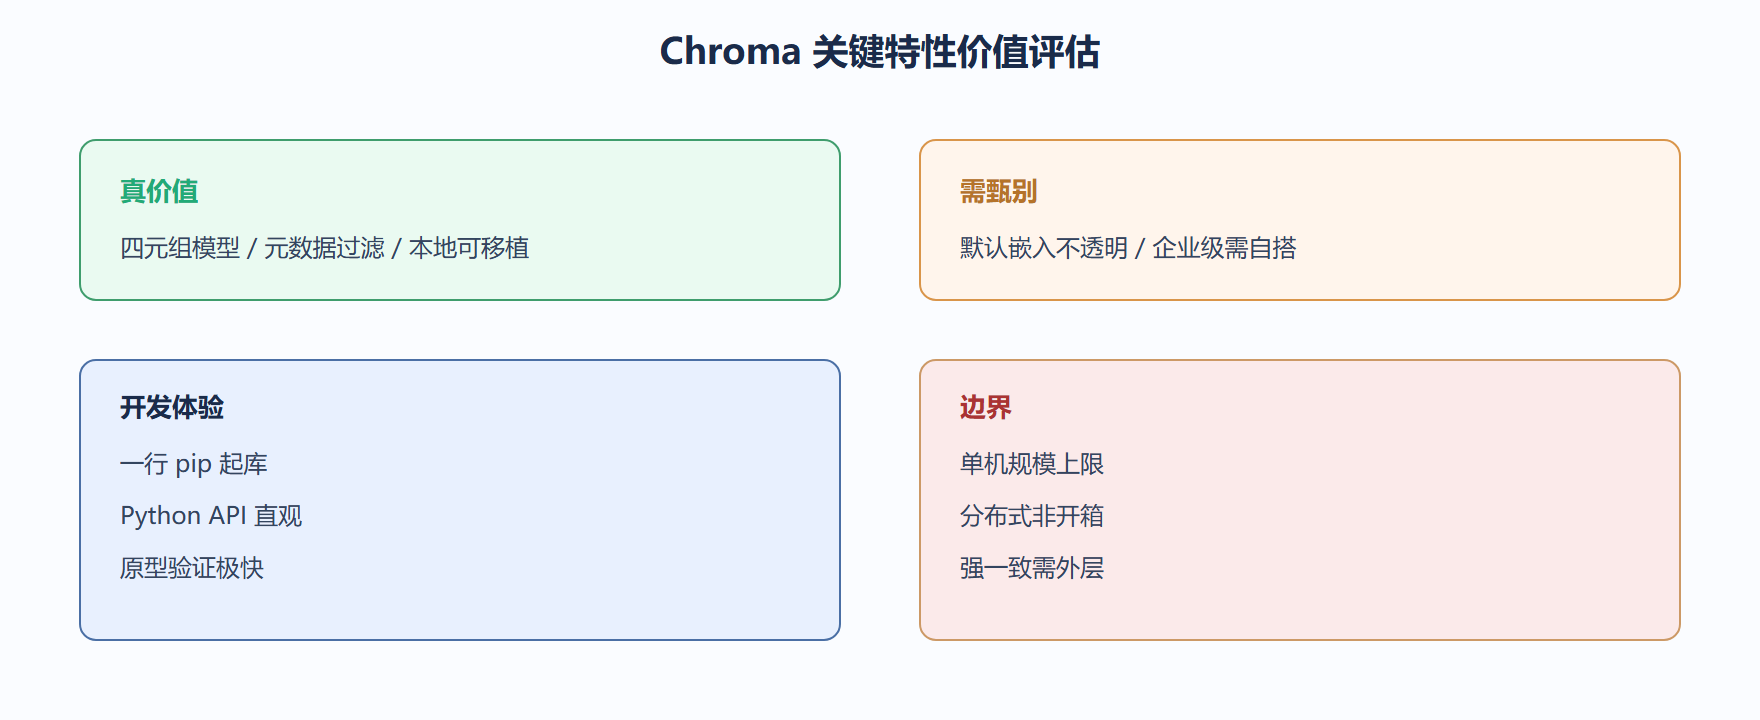
- "极致性能":默认 HNSW 在内存里,单机规模下快,但别拿它和分布式引擎的吞吐比。
- "企业级":多租户、细粒度权限不是开箱能力,需要你自己在外层做。
深度对照:哪些"特性"是表象,哪些是内核
Chroma 的特性清单里,有些是"看起来很香但实际很少单独用"的装饰,有些是"决定你项目能不能活下来"的骨架。分清两者,才不会在选型会上被功能表带偏。这像看一辆车的参数:零百加速是表象卖点,底盘结构是内核——前者决定广告好不好看,后者决定弯道里命还在不在。
内核级特性有三个:嵌入式零依赖(库即服务)、按 Collection 隔离的命名空间、以及把"嵌入生成"和"存储检索"解耦。前两个决定你怎么组织数据,第三个决定你能不能随时换模型。装饰级特性如"支持某家云托管""有某语言客户端",它们方便但不构成壁垒——换一家也有。
## 用结构化方式区分特性的"权重"(非运行代码) features = { "嵌入式零依赖": {"层级": "内核", "换掉成本": "高", "影响": "部署形态"}, "Collection 隔离": {"层级": "内核", "换掉成本": "高", "影响": "数据组织"}, "嵌入与存储解耦": {"层级": "内核", "换掉成本": "中", "影响": "模型可移植性"}, "多语言客户端": {"层级": "装饰", "换掉成本": "低", "影响": "开发体验"}, "云托管选项": {"层级": "装饰", "换掉成本": "低", "影响": "运维便利"}, } for name, info in features.items(): tag = "★" if info["层级"] == "内核" else " " print(f"{tag} {name:8s} 层级={info['层级']} 影响={info['影响']}") ## ★ 嵌入式零依赖 层级=内核 影响=部署形态 ## ★ Collection 隔离 层级=内核 影响=数据组织 ## ★ 嵌入与存储解耦 层级=内核 影响=模型可移植性 ## 多语言客户端 层级=装饰 影响=开发体验 ## 云托管选项 层级=装饰 影响=运维便利
这张表的价值在于:当你被问"Chroma 有什么优势"时,先抛三个内核特性,再补装饰特性——前者让人记住,后者只是锦上添花。
一个被忽视的特性:元数据的"第二索引"
很多新手把 Chroma 当成纯向量库,忘了它还有结构化元数据过滤。元数据是挂在每条记录上的键值对,查询时可以先用元数据缩小范围,再在缩小后的集合里做向量检索。这像图书馆先按"分类号"定位书架,再在书架上按"意思相近"找书——两步结合,比全库语义扫描又快又准。
⚠️ 常见坑:把本该放元数据的字段(如日期、来源、语言)也塞进文档正文,导致无法高效过滤,只能全量语义检索,既慢又贵。元数据过滤是在向量距离计算之前发生的前置剪刀。
💡 关键直觉:向量检索负责"找意思近的",元数据负责"先划掉不相关的"。两者不是竞争关系,而是流水线上下游。设计 schema 时先问"哪些维度是过滤条件",把它们提升为元数据。
实践中的常见坑与关键直觉
- ⚠️ 误把"客户端多"当"能力强":Chroma 的 Python 与 JS 客户端最成熟,其他语言若只是社区维护,别假设 API 完全对齐,先核对方法签名。
- ⚠️ 误以为"开源"等于"免运维":嵌入式模式把运维负担转成你的代码责任——备份、升级、迁移都归你,只是没有独立服务进程而已。
- 💡 选特性时做"抽掉测试":想象没有这个特性项目还能不能跑?能跑的就是装饰,不能跑的是内核,资源优先投在内核上。
- 💡 把"嵌入模型可换"当成长期资产:今天用 A 模型,明天模型升级,只要接口不变,你的检索逻辑不需重写——这是解耦特性的真实红利。
本节要点回顾:Chroma 的四元组模型、元数据过滤、本地可移植是真价值;默认嵌入不透明和企业级能力需自行处理。把特性翻译成"对你代码有用与否"的判断,比背特性列表更有用。
⚠️ 别迷信"内置嵌入"——生产环境一定显式指定 embedding 函数,否则换版本后向量空间可能不一致,旧数据查不到。
💡 元数据过滤是多领域混合库的必选项,设计 schema 时尽早规划 type/category 等字段。