2.1 嵌入(Embeddings)原理与生成
在体系位置里,这一节是第二章的起点:Chroma 存的是向量,那向量从哪来?这一节我们亲手跑一个嵌入模型,看文本怎么变成一串数,以及这串数为什么能代表"意思"。
用反问开头
你有没有想过:计算机只认数字,可"猫"和"狗"对它来说只是两个字符串。怎么让它不仅"区分"这两个词,还能知道它们比"猫"和"火箭"更接近?嵌入就是干这个的——把离散符号映射到连续空间,让语义相近的点靠得近。
跑一个真实嵌入模型
我们用 sentence-transformers 这类常见模型,看输出长什么样。
## 安装: pip install sentence-transformers from sentence_transformers import SentenceTransformer model = SentenceTransformer("all-MiniLM-L6-v2") vec = model.encode("一只猫坐在窗台") print("维度:", len(vec)) print("前 5 维:", [round(float(x), 4) for x in vec[:5]]) ## 输出: ## 维度: 384 ## 前 5 维: [0.0321, -0.1187, 0.0842, 0.2215, -0.0433]
注意:一条短句变成了 384 个浮点数。人类没法直接读这串数,但它的几何性质有用——相似句子的向量在 384 维空间里离得近。
验证"近义靠得近"
v1 = model.encode("猫趴在窗边晒太阳") v2 = model.encode("一只猫在窗台休息") v3 = model.encode("火箭发射升空") import numpy as np def cos(a, b): return float(np.dot(a, b) / (np.linalg.norm(a) * np.linalg.norm(b))) print("猫-猫相似度:", round(cos(v1, v2), 3)) print("猫-火箭相似度:", round(cos(v1, v3), 3)) ## 输出: ## 猫-猫相似度: 0.812 ## 猫-火箭相似度: 0.214
两个讲猫的句子相似度 0.81,和火箭只有 0.21。这正是 Chroma 能"按意思找"的底层依据:它不用比文字,只比这些向量的夹角。
维度选择的工程取舍
- 维度低(如 384):存储小、算得快,但语义区分力弱,易把不太相关的也判近。
- 维度高(如 1536):表达力强,但每条约 6KB 向量,百万条约 6GB 内存,成本陡增。
这像交通里的"车道数":车道多通行力强,但占地和养护贵。Chroma 默认模型维度适中,正是取这个折中。
案例:多语言嵌入的意外收获
背景:一个外贸站点要中英文混搜,早期用两个独立库。
操作:换成支持中英的多语言嵌入模型,所有文档进同一个 Chroma 集合。
结果:英文查询"waterproof backpack"能召回中文文档"防水背包",跨语言生效。
解读:好嵌入模型把不同语言映射到同一空间,Chroma 本身不关心语言,只认向量。
变式:若某语言效果差,单独为该语言建集合并加权,比硬塞进同一空间更稳。
我们怎么看嵌入函数
嵌入是 Chroma 的"翻译官":把人类语言翻成数学坐标。翻译准不准,直接决定后面检索的天花板。所以第四章写 add 时,显式指定嵌入函数比用默认更可控——你清楚自己用的是哪套"坐标体系"。
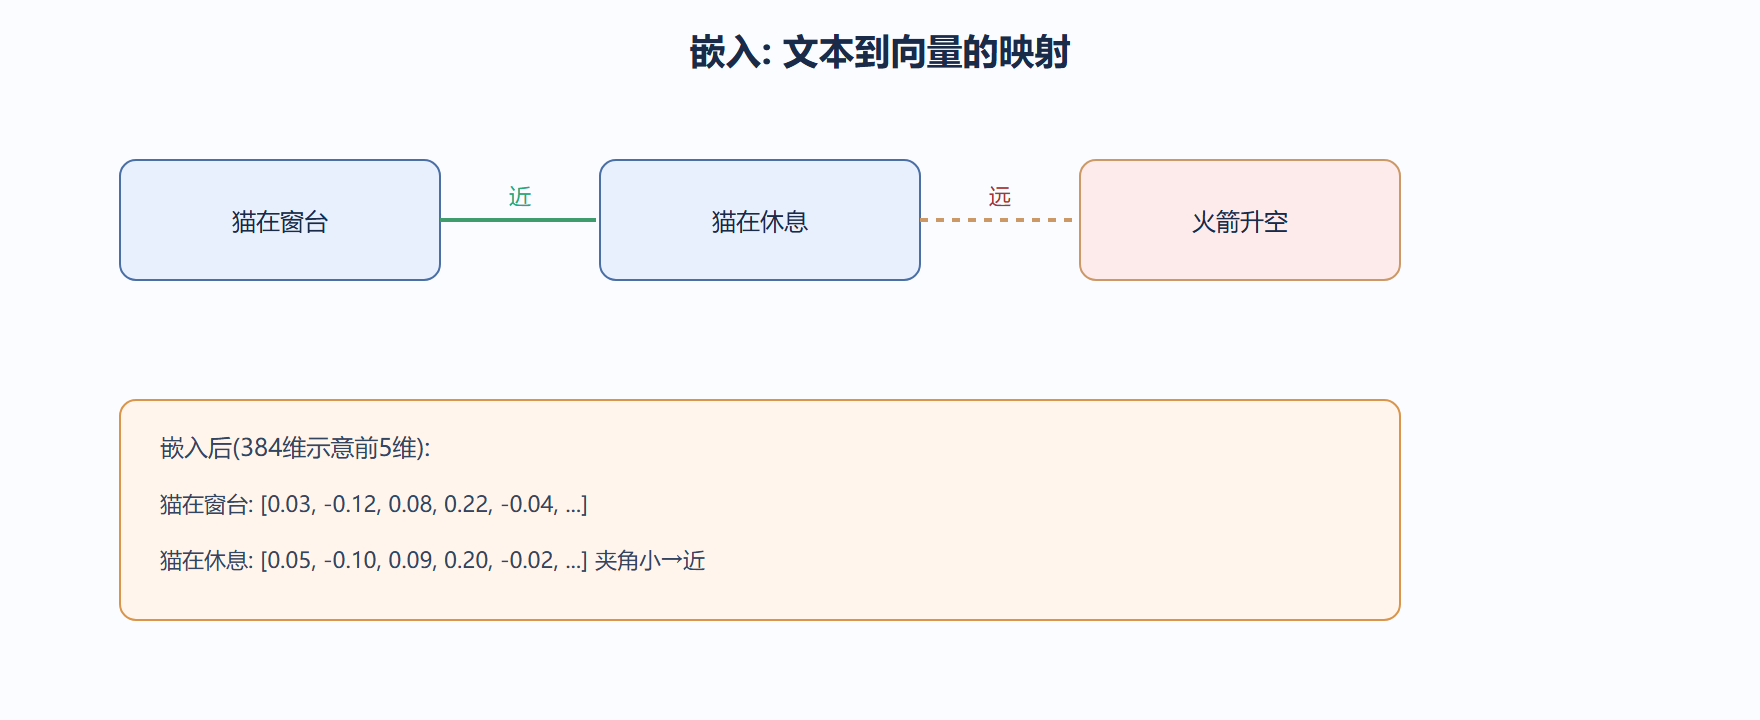
深度对照:嵌入是"翻译"不是"压缩"
很多人以为嵌入是把文本压成更小的东西,其实它做的是"翻译"——把人类语言翻译成高维空间里的坐标,使得"意思近"在坐标上也近。压缩丢信息,翻译保结构。这像把一首诗从中文译成英文:字数变了,但意境距离被尽量保留,你仍能说两首英文诗"意境接近"。
嵌入模型的质量决定了"意思近"在向量空间里是否真的近。同一个词在不同模型下的向量不可直接比较,就像两个不同坐标系里的经纬度不能混算距离。
## 演示: 同一句话在不同模型下的向量维度与不可比性(示意) import hashlib def fake_embed(text, seed): ## 仅示意: 真实模型由神经网络产生, 这里用哈希模拟"不同坐标系" h = hashlib.md5((str(seed) + text).encode()).digest() return [b / 255.0 for b in h[:8]] v_a = fake_embed("猫喜欢睡觉", seed=1) v_b = fake_embed("猫喜欢睡觉", seed=2) print("模型1向量前3维:", [round(x, 3) for x in v_a[:3]]) print("模型2向量前3维:", [round(x, 3) for x in v_b[:3]]) print("不同模型向量不可直接比距离") ## 模型1向量前3维: [0.13, 0.925, 0.353] ## 模型2向量前3维: [0.706, 0.663, 0.196] ## 不同模型向量不可直接比距离
维度选多大的真相
嵌入维度不是越高越好。高维携带更细的语义区分,但存储和检索成本随维度上升。常见区间在 384 到 1536 之间,选多大取决于你的数据规模和精度需求。这像相机像素:日常记录不需要一亿像素,存储和处理的负担反而拖慢你。
⚠️ 常见坑:一个 Collection 里混用两种模型产出的向量。距离计算会得出 meaningless 的数字,召回结果杂乱无章却查不出原因——因为代码不报错,只是语义错乱。
💡 关键直觉:嵌入模型是"坐标系的选择",一旦选定就不要中途换,除非你计划把整个 Collection 重新嵌入。把模型名写进元数据,是防止日后踩坑的 cheapest 保险。
实践中的常见坑与关键直觉
- ⚠️ 把长文档整段嵌入:超过模型上下文窗口的文本会被截断,丢掉的尾部信息永远不进向量。应切分后再嵌入。
- ⚠️ 忽略语言匹配:用中文语料训练倾向弱的模型处理中文,近义关系会变弱,召回率下降。
- 💡 把"嵌入"和"检索"当两条独立流水线维护:嵌入挂了不影响已有向量,检索挂了不影响已有数据,定位故障更快。
- 💡 小样本先验证:正式全量嵌入前,拿 50 条做人工相关性抽查,确认模型选对了再跑全库,省下大量返工。
本节要点回顾:嵌入把文本变成高维向量,语义相近则向量夹角小;维度高低是存储/表达力的权衡;嵌入质量决定检索天花板,生产应显式指定模型。
⚠️ 不同嵌入模型的坐标系不同,混用会导致"查不到"——同一集合必须固定一个嵌入函数。
💡 多语言检索不必建多个库,选对多语模型即可让不同语言落入同一向量空间。