2.2 向量数据库(Vector Database)基础
在体系位置里,这一节把视野从"单个向量"拉到"一类系统"。向量数据库和普通数据库到底差在哪?不把这件事想透,你写查询时会一直用错心智模型。
一张图先建立直觉
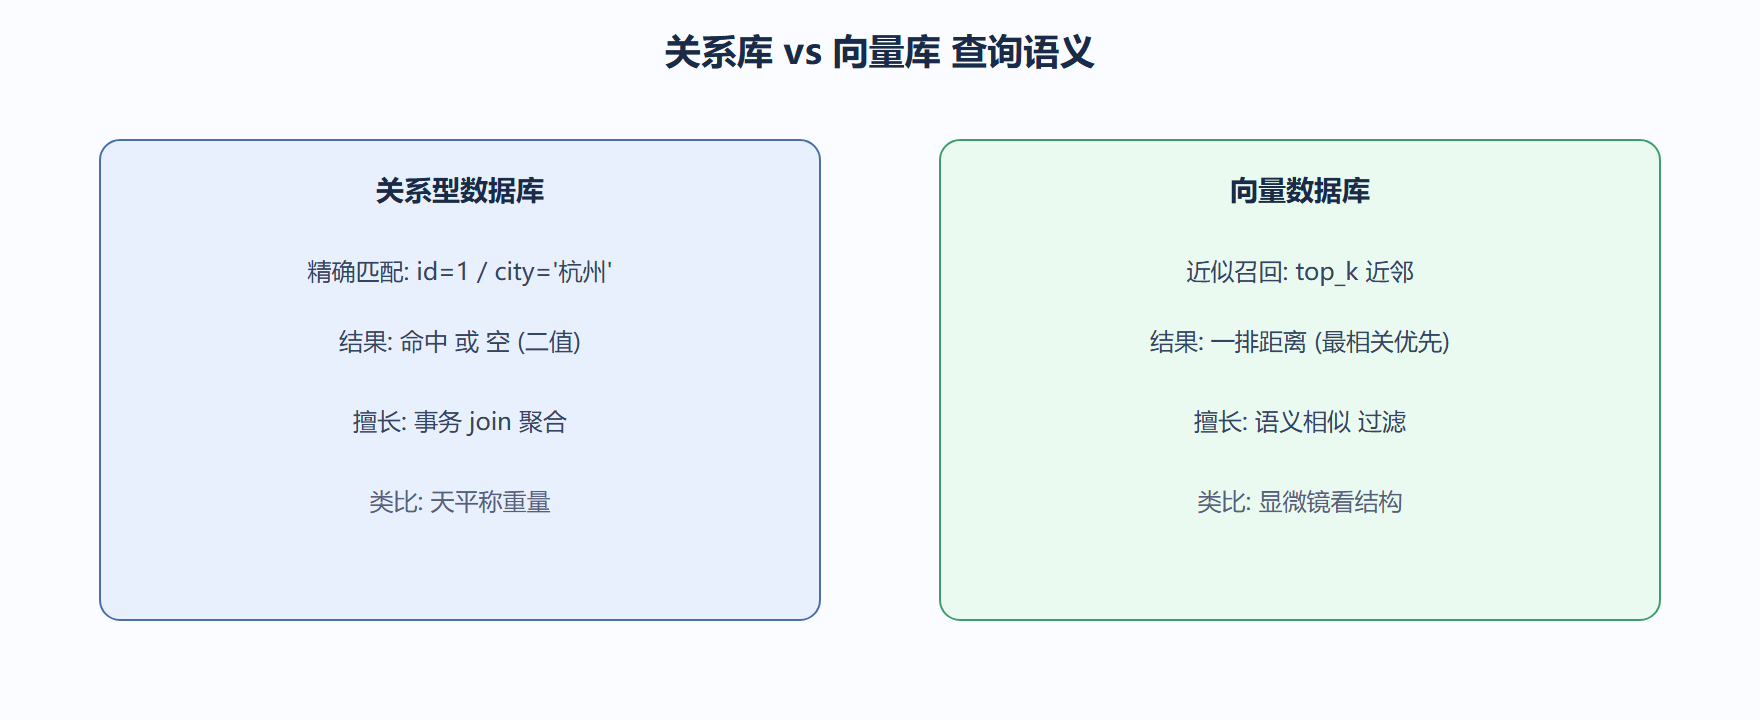
普通数据库的查询是"精确匹配":主键等于某值、字段满足某条件,结果要么在要么不在。向量数据库的查询是"近似召回":没有唯一正确答案,只返回离得最近的一批。这是两种根本不同的查询语义。
## 关系库: 结果确定 rows = conn.execute("SELECT * FROM t WHERE city='杭州'").fetchall() # 命中或空 ## 向量库: 结果是"最近的 k 个",本身带距离 res = col.query(query_texts=["江南水乡"], n_results=3) print(res["distances"][0]) ## 输出类似: [0.22, 0.35, 0.41] # 三个候选,越近越相关,没有"精确等于"
看输出:向量查询返回的是一排距离,不是"有或无"。你的代码得学会处理"最可能"而不是"一定"。
为什么需要专门的数据结构
暴力做法是对每条都算距离再排序,复杂度 O(N·d)。当 N 到百万、d 到几百,每次查询要算上亿次乘法,慢得不可用。向量数据库的核心是"用索引换时间"——牺牲一点精度,换几个数量级的加速。这正是第三章 HNSW 要讲的,这里先种下因果:因为暴力算太慢,所以必须有近似索引。
四类查询需求对照
needs = { "精确点查": ("关系库", "WHERE id=1", "结果确定"), "范围/聚合": ("关系库", "GROUP BY city", "结果确定"), "语义近邻": ("向量库", "query_top_k", "返回最近k个"), "近邻+字段过滤": ("向量库", "query + where", "先过滤再近邻"), } for k, (who, how, note) in needs.items(): print(f"{k:10s} -> 用{who}, {how}, {note}") ## 精确点查 -> 用关系库, WHERE id=1, 结果确定 ## 范围/聚合 -> 用关系库, GROUP BY city, 结果确定 ## 语义近邻 -> 用向量库, query_top_k, 返回最近k个 ## 近邻+字段过滤 -> 用向量库, query + where, 先过滤再近邻
案例:混合查询的真实形态
背景:一个房产平台,既要"语义找描述像的房子",又要"只在北京、价低于 800 万"。
操作:描述进向量字段,城市/价格进元数据,query 时 where={"city":"北京","price":{"$lt":800}}。
结果:既保证了语义相关,又锁死了业务约束,不会推上海的房子。
解读:现代向量库(含 Chroma)的发力点正是"向量近邻 + 标量过滤"的组合,单靠任一部分都做不全。
变式:若过滤后候选太少,可放宽 where 或改用 $lte,本质是精度与召回的权衡。
我们怎么理解"向量数据库"这名字
它叫数据库,但擅长的是"相似性"而非"事务"。这像物理里的"显微镜"和"天平":都能测,但一个看结构相似、一个看精确重量。把向量库当关系库用(强一致事务、复杂 join)是错配;把它当"相似性召回引擎"用,才是对的地方。
深度对照:向量库和传统库的"根本分歧"
传统数据库回答"哪些记录满足条件",向量数据库回答"哪些记录意思最接近"。前者是布尔逻辑(满足/不满足),后者是连续度量(多近)。这个分歧导致两者在索引、查询、甚至"什么是好结果"上完全不同。这像图书馆 vs compass:图书馆按编号精确取书,compass 给你"方向最接近目标"的几本书,没有唯一正确答案。
向量库的索引不是为了"快速等于",而是为了"快速近似最近邻"——它允许少量误差换取数量级的提速,这是传统 B 树索引没有的取舍。
## 用对照说明两类查询的本质差异(非运行代码) query_types = { "关系库": {"输入": "WHERE price < 100", "输出性质": "精确集合", "索引": "B树/哈希"}, "向量库": {"输入": "query_vector", "输出性质": "top_k 近邻", "索引": "近似最近邻图"}, } for k, v in query_types.items(): print(f"{k}: 输出={v['输出性质']} 索引={v['索引']}") ## 关系库: 输出=精确集合 索引=B树/哈希 ## 向量库: 输出=top_k 近邻 索引=近似最近邻图
为什么"近似"是被允许的
精确最近邻要扫全库算距离,向量维度高时成本爆炸。近似算法(如基于图的导航)用"大概率找到够近的点"换速度,对语义检索这种本身就有容错的场景,用户根本感知不到那点误差。这像导航软件给你"次优但快很多的路线",你通常不会为了省五百米绕远三公里。
⚠️ 常见坑:把向量库当精确系统用,期待每次 top1 都"正确"。语义检索的 k 一般取 3 到 10,把候选交给上层模型或人工再判,比死磕 top1 更稳。
💡 关键直觉:向量库的"好"是概率意义下的好。理解这一点,你就不会在架构评审里要求它给出和传统库一样的强保证,也就不会用错地方。
实践中的常见坑与关键直觉
- ⚠️ 拿准确率指标套向量库:用"精确率 100%"要求语义召回是误解场景,应看 top_k 命中率与人工满意度。
- ⚠️ 忽略维度对内存的压力:高维向量乘数据量就是内存账单,规模上来前先算总账。
- 💡 把向量库定位为"检索加速器"而非"唯一真相源":原始数据仍留在你的主库,向量库只管找。
- 💡 理解近似的代价边界:数据量小的时候,精确和近似差别不大;量越大,近似的价值越突出。
一个"误当精确库"的案例
背景:某系统把订单精确查询也放进了向量库,期待 top1 就是那笔单。
操作:语义检索天然容错,精确主键场景反而丢了强一致保障。
结果:订单类查询迁回关系库,向量库只管语义检索,各司其职。
解读:选错场景比不用更糟,看清"痛点是不是语义匹配"再选型。这像拿尺子称重量。
变式:若既要语义又要精确,用向量库召回候选,再回主库按主键取权威记录。
本节要点回顾:向量库的核心是"近似召回"而非"精确匹配";为避开 O(N·d) 暴力算距离,必须用索引换时间;它的主战场是语义近邻加标量过滤的组合查询。
⚠️ 别拿向量库做强一致事务或复杂 join——那是关系库的地盘,错配会带来正确性和性能双重问题。
💡 查询返回的是"距离列表"不是"命中集合",代码逻辑要从"有无"切换到"最近几个"。