2.4 相似性度量(Similarity Metrics)
在体系位置里,这一节是第二章的收口,也是整个"查向量"的底层逻辑:两点之间的距离怎么算,不同算法适合什么数据。这一节我们亲手算三种度量,看数值差异意味着什么。
历史角度切入
早期信息检索用"词频重合"衡量相关,后来发现方向比长度更重要——于是余弦相似度成了文本向量的默认选择。但向量数据库不止余弦,内积和欧氏距离各有主场。理解三者,你才能在 Chroma 里选对 metadata 之外的那层排序依据。
三种度量亲手算
import numpy as np def cosine(a, b): return float(np.dot(a, b) / (np.linalg.norm(a) * np.linalg.norm(b))) def inner(a, b): return float(np.dot(a, b)) def euclid(a, b): return float(np.linalg.norm(np.array(a) - np.array(b))) a = [1.0, 2.0, 3.0] b = [2.0, 4.0, 6.0] # 与 a 同向, 长度翻倍 c = [3.0, 0.0, 0.0] # 与 a 不同向 print("余弦 a,b:", round(cosine(a, b), 3), " a,c:", round(cosine(a, c), 3)) print("内积 a,b:", round(inner(a, b), 3), " a,c:", round(inner(a, c), 3)) print("欧氏 a,b:", round(euclid(a, b), 3), " a,c:", round(euclid(a, c), 3)) ## 余弦 a,b: 1.0 a,c: 0.801 ## 内积 a,b: 28.0 a,c: 3.0 ## 欧氏 a,b: 3.742 a,c: 3.742
解读:a 和 b 方向完全相同,余弦=1;但内积因 b 更长而更大;欧氏距离只看空间离多远,a-b 和 a-c 碰巧一样远。三种度量关心的"近"不是一回事。
Chroma 里怎么指定
Chroma 的 distance 度量在创建集合时定,可选 l2(欧氏)、cosine、ip(内积)。注意 Chroma 内部统一存距离(越小越近),余弦会被转成距离表达。
c = chromadb.Client() col_cos = c.create_collection("by_cosine", metadata={"hnsw:space": "cosine"}) col_l2 = c.create_collection("by_l2", metadata={"hnsw:space": "l2"}) col_cos.add(ids=["x"], documents=["猫和狗都是宠物"], embeddings=[[0.1,0.2,0.3]]) col_l2.add(ids=["x"], documents=["猫和狗都是宠物"], embeddings=[[0.1,0.2,0.3]]) ## 查询时同一问题, 两种空间下的距离数值含义不同, 排序也可能不同
怎么选:一张对照
guide = { "cosine 余弦": "关心方向, 忽略长度; 文本嵌入默认, 适合大多数语义检索", "ip 内积": "关心方向与长度; 嵌入已归一化时等价余弦, 否则偏好长向量", "l2 欧氏": "关心绝对位置; 图像/数值特征常用, 对向量尺度敏感", } for k, v in guide.items(): print(f"{k}: {v}") ## cosine 余弦: 关心方向, 忽略长度; 文本嵌入默认, 适合大多数语义检索 ## ip 内积: 关心方向与长度; 嵌入已归一化时等价余弦, 否则偏好长向量 ## l2 欧氏: 关心绝对位置; 图像/数值特征常用, 对向量尺度敏感
案例:归一化如何改变内积
背景:团队用内积空间,发现长文档总被优先召回,短问题反而吃亏。
操作:在写入前对所有向量做 L2 归一化,使内积退化为余弦。
结果:长短文档回到同一尺度竞争,召回更公平。
解读:内积对长度敏感是特性也是坑;归一化是常用的"拉平"手段。
变式:若业务就是要"信息量大(长)的优先",保留内积不归一化,反而成了特性。
我们看度量的取舍
度量不是越高级越好,而是越贴合数据分布越好。文本嵌入通常已隐含方向语义,余弦最稳;图像特征尺度不均,欧氏或归一化内积更合理。换度量等于换了"近"的定义,必须和嵌入模型、业务目标一起考虑,不能孤立调。
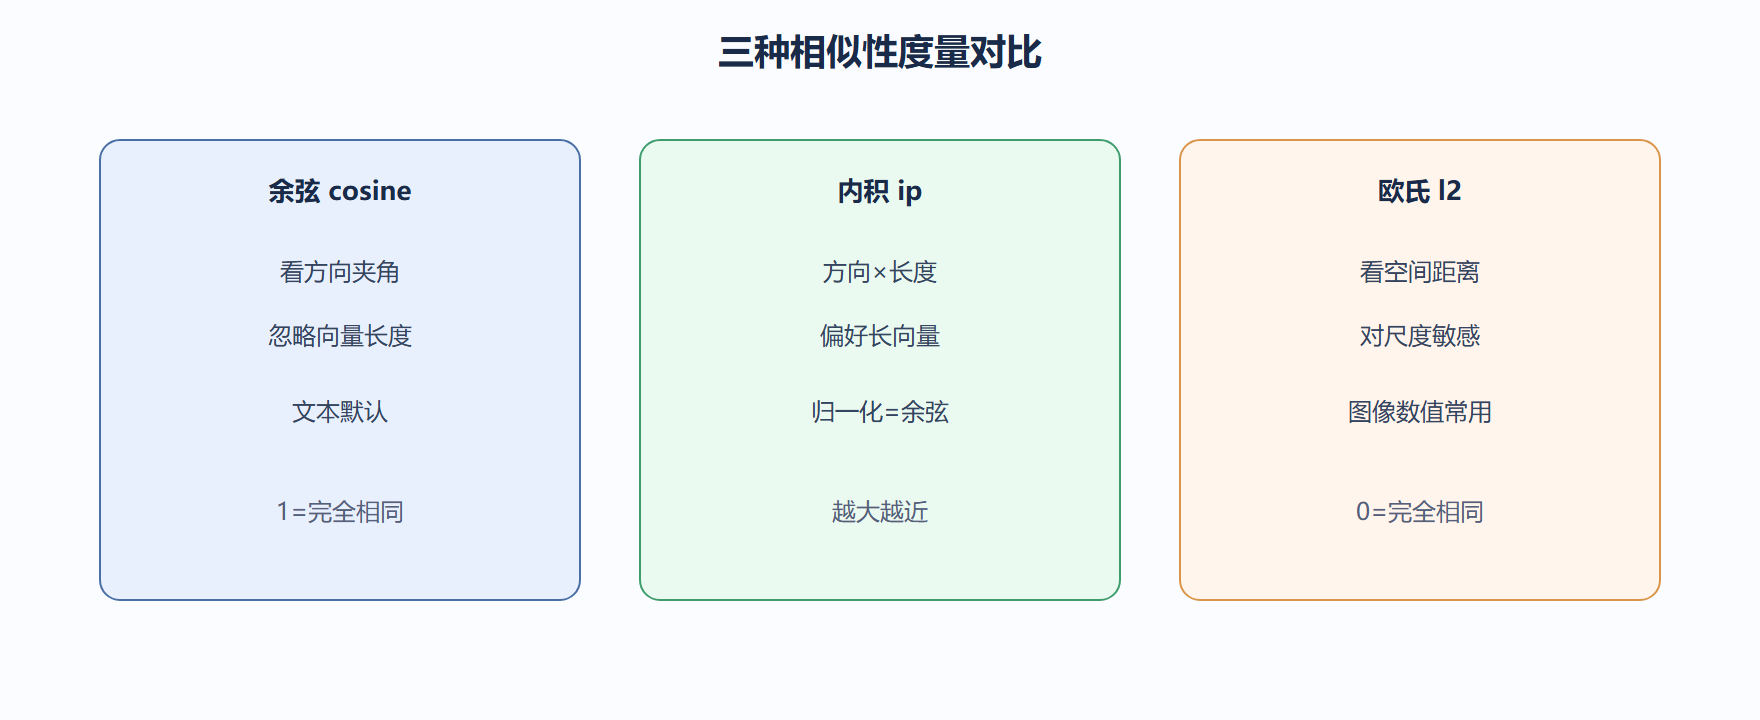
深度对照:三种度量的"性格"差异
Chroma 支持余弦、L2(欧氏)、内积三种距离度量。它们不是"哪个最准"的关系,而是"为不同数据分布量身定做"。余弦只看方向不看长度,适合文本(长文短文意思近就该近);L2 看实际空间距离,对向量幅度敏感;内积在向量已归一化时近似余弦但计算更省。这像三种尺子:卷尺量长度、秤量重量、秒表量时间,挑错工具才会得出荒谬结论。
## 用示意说明三种度量的关注点(非运行代码) metrics = { "cosine": {"关注": "方向", "忽略": "模长", "典型用途": "文本语义"}, "l2": {"关注": "空间距离", "忽略": "无", "典型用途": "归一化前原始向量"}, "ip": {"关注": "投影", "忽略": "需先归一化", "典型用途": "已归一化向量"}, } for k, v in metrics.items(): print(f"{k:7s} 关注={v['关注']} 用途={v['典型用途']}") ## cosine 关注=方向 用途=文本语义 ## l2 关注=空间距离 用途=归一化前原始向量 ## ip 关注=投影 用途=已归一化向量
选错度量会怎样
若文本嵌入本该用余弦,却用了 L2,那么长文本的向量模长更大,会系统性地"离谁都远",召回偏向短文本,语义公平性被破坏。这个 bug 不报错,只表现为"长内容总排后面"。这像用体重当身高排序,高个子若偏瘦就吃亏。
⚠️ 常见坑:一个 Collection 创建时定了余弦,之后换模型产出归一化不同的向量却没重建,距离分布漂移,召回质量 silently 下降。
💡 关键直觉:度量方式要在 Collection 创建时定好且全程不变。它是"距离的定义",改定义等于改坐标系,旧向量全失准。
实践中的常见坑与关键直觉
- ⚠️ 混用不同度量解释结果:A 实验用余弦、B 实验用内积,拿两者的距离数值比大小是无意义的。
- ⚠️ 未归一化就上内积:内积对模长敏感,不归一化会被长度主导,先把向量归一化再考虑内积。
- 💡 文本场景默认余弦最稳,不纠结;只有在明确做了归一化且追求推理速度时,才切内积。
- 💡 把度量写进 Collection 的元数据备注,三个月后接手的人不会猜你当初为什么选它。
本节要点回顾:余弦看方向、内积含长度、欧氏看绝对位置;Chroma 在集合 metadata 用 hnsw:space 指定;文本默认余弦,内积敏感长度可用归一化拉平。度量选择须与嵌入模型和业务一起考虑。
⚠️ 集合创建后度量不能改——写错空间要重建集合,历史数据得重新导入。
💡 文本检索拿不准就用 cosine;若发现长文档总被偏袒,先怀疑内积未归一化而非模型问题。