2.3 ChromaDB 数据组织结构
在体系位置里,这一节落到 Chroma 自己的内部组织:一个 Collection 到底由哪些字段构成、它们之间怎么约束。这是第四章写 add 前的必读,因为参数名直接对应这里的概念。
四字段模型
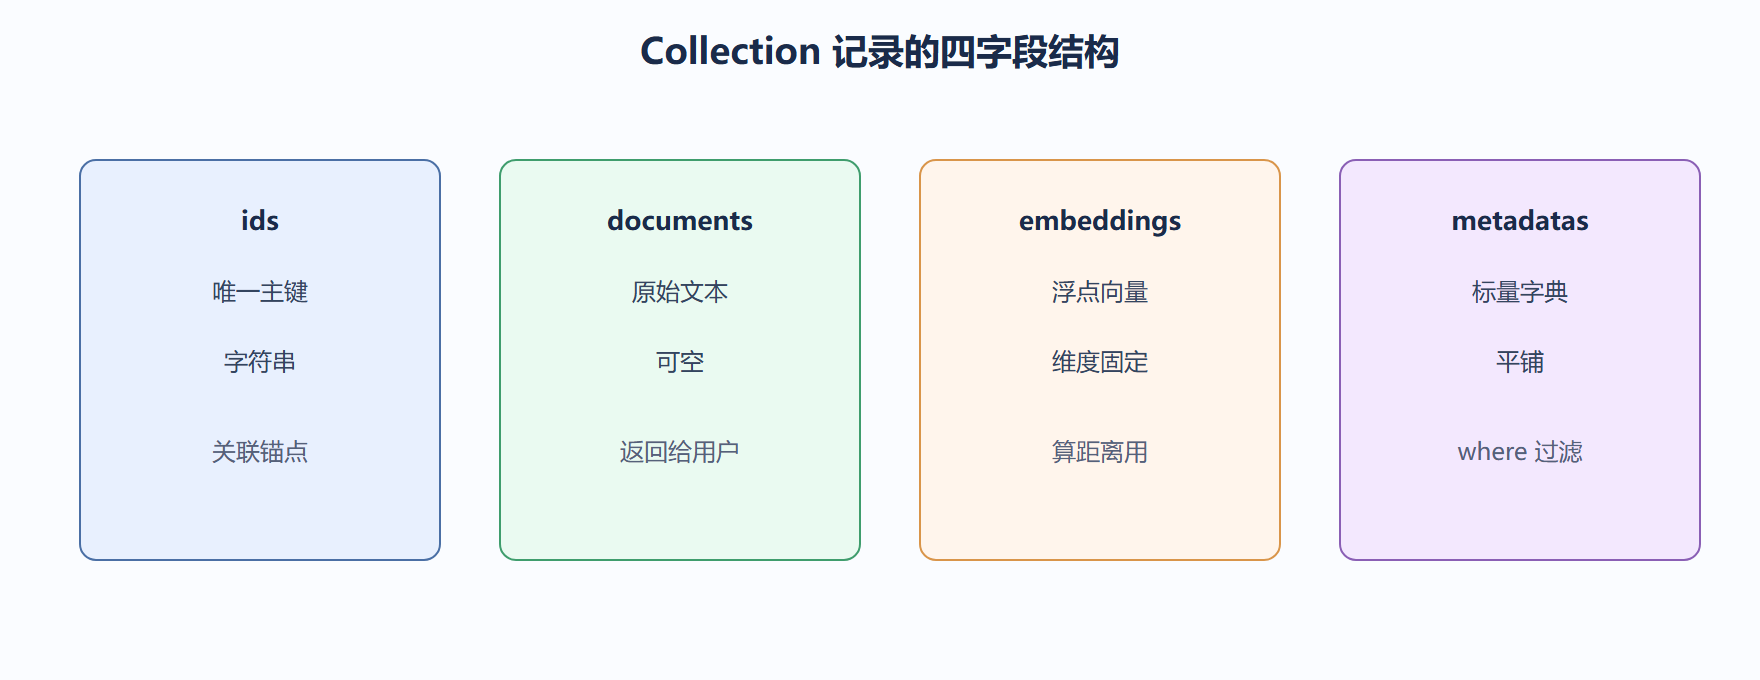
Chroma 的最小组织单元是 Collection,里面每条记录必须同时具备四个部分:
import chromadb c = chromadb.Client() col = c.create_collection("org_demo") col.add( ids=["r1"], # 唯一主键, 字符串 documents=["Chroma 用 HNSW 建索引"], # 原始文本 embeddings=[0.1, 0.2, -0.3, 0.05], # 向量, 长度必须一致 metadatas=[{"lang": "zh"}], # 过滤字段, 字典 ) print(col.count()) # 输出: 1
四个字段的约束:
ids:集合内唯一,重复写入会报错或覆盖(取决于用 add 还是 upsert)。documents:文本,可空但一般要有,查询返回时靠它。embeddings:浮点列表,同一集合维度必须固定。metadatas:只支持基本类型(str/int/float/bool),不能嵌套复杂结构。
维度必须一致
col.add(ids=["x"], documents=["a"], embeddings=[0.1, 0.2]) # 2维 ## 下面这行会抛错: 维度不匹配 try: col.add(ids=["y"], documents=["b"], embeddings=[0.1, 0.2, 0.3]) # 3维 except Exception as e: print("错误:", type(e).__name__) ## 输出: 错误: ValueError (维度不一致)
为什么这么硬?因为向量之间的距离只有在同维度下才有意义。这像交通里的"车道宽度标准"——不同宽度的车不能混上同一条高速。
元数据类型的边界
## 合法元数据 col.add(ids=["m1"], documents=["d"], metadatas=[{"k": "v", "n": 1, "f": 1.5, "b": True}]) ## 非法: 嵌套列表/字典会报错 try: col.add(ids=["m2"], documents=["d"], metadatas=[{"bad": {"x": 1}}]) except Exception as e: print("错误:", type(e).__name__) ## 输出: 错误: ValueError
元数据只承载"过滤用标量",复杂对象应序列化成字符串或拆成平铺字段。
案例:用元数据支持层次过滤
背景:一个内容库分"频道→栏目"两级,查询常需按栏目过滤。
操作:元数据设计成 {"channel": "tech", "column": "db"},查询用 where={"channel":"tech","column":"db"}。
结果:两级过滤一次完成,不必为每栏目建独立集合。
解读:平铺的元数据字段比嵌套结构更契合 Chroma 的过滤引擎。
变式:栏目很多时可用 $in 列表一次跨多个栏目召回。
我们看组织设计的取舍
Chroma 把"向量 + 原文 + 元数据 + id"绑死,看似限制自由,实则省了你自己维护关联表的麻烦。代价是元数据不能太复杂——真要存富结构,把它塞进 documents 或外部表,用 id 关联。这像建筑里"承重墙不能打洞",换来整体结构稳定。
深度对照:Collection 是"抽屉"不是"表"
Chroma 里最高的组织单元是 Collection。它既不是关系库的表(没有固定列约束),也不是文件夹(不按路径寻址),而更像一个"带统一规则的抽屉":同一个抽屉里的记录共享嵌入空间和元数据 schema 约定。这像办公楼里按业务分的档案柜——财务柜和人事柜分开,各自内部怎么排有自己的习惯,但跨柜不混。
Client 之下挂多个 Collection,Collection 之下是具体的记录(id、文档、向量、元数据)。理解这三层,数据建模就清楚了。
## 用层级结构表达 Chroma 的数据组织(示意) org = { "Client": ["Collection_A", "Collection_B"], "Collection_A": { "记录结构": ["id", "document", "embedding", "metadata"], "隔离级别": "嵌入空间独立", }, } print("Client 下挂的 Collection:", org["Client"]) print("单条记录字段:", org["Collection_A"]["记录结构"]) ## Client 下挂的 Collection: ['Collection_A', 'Collection_B'] ## 单条记录字段: ['id', 'document', 'embedding', 'metadata']
怎么切分 Collection 才合理
经验法则:语义空间一致、过滤维度稳定的放一个 Collection;语义空间不同(例如中文文档和图像描述)或过滤逻辑互斥的,拆开。拆太细会增加管理成本,拆太粗会让元数据过滤负担变重。这像城市分区:分太碎通勤累,不分又混乱。
⚠️ 常见坑:把所有数据塞进一个 Collection,再用海量元数据区分。结果查询时过滤后仍要扫大空间,既慢又难维护。适度切分是免费的加速。
💡 关键直觉:Collection 边界 = 嵌入模型与语义域的边界。同一个 Collection 内应保证"向量可比",跨 Collection 的比较没有意义。
实践中的常见坑与关键直觉
- ⚠️ 用 Collection 当权限隔离:Chroma 的 Collection 不提供细粒度访问控制,别把它当成安全边界。
- ⚠️ id 重复跨 Collection 无感知:id 只在单个 Collection 内唯一,别假设全局唯一。
- 💡 给 Collection 起业务语义名而非编号,半年后你还能看懂"faq_cn"比"col_3"强太多。
- 💡 元数据字段先约定再写入,避免同一 Collection 内出现五花八门的键名,后期过滤会非常痛苦。
本节要点回顾:Chroma 一条记录由 ids/documents/embeddings/metadatas 四字段构成;向量维度全集必须一致,元数据只接受平铺标量;四字段绑死省去自维护关联,代价是结构不能复杂。
⚠️ 同一集合混用不同维度向量会直接报错——写入前务必确认嵌入函数输出维度恒定。
💡 富结构数据别塞元数据,序列化进 documents 或用 id 关联外部表,保持元数据扁平利于过滤。