3.1 架构概述与组件
在体系位置里,这一节掀开 Chroma 的引擎盖,看一次 query 从你敲下回车到拿到结果,内部经过哪些组件。知道分层,后面调优才有落脚点。
直接定义式切入
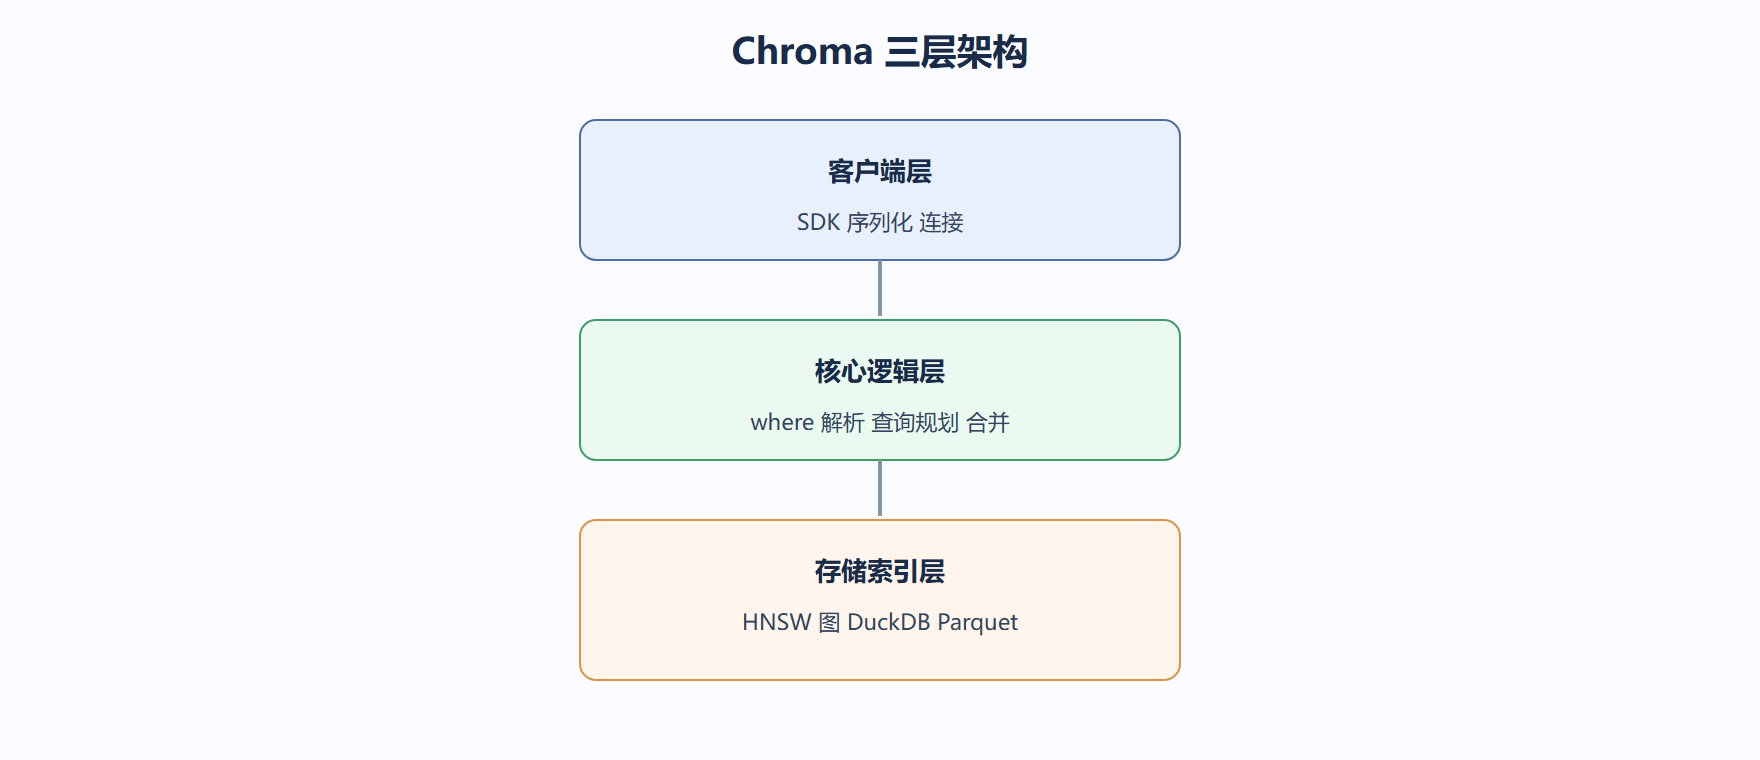
Chroma 的运行时可以切成三层:客户端层负责接你的 Python 调用;核心逻辑层负责把"查询"翻译成"先过滤后近邻"的执行计划;存储索引层负责真正存向量、建图、落盘。三层各管一摊,互不越界。
三层职责对照
layers = { "客户端层": ["Python/JS SDK", "序列化请求", "连接管理"], "核心逻辑层": ["Collection 管理", "where 解析", "查询规划", "结果合并"], "存储索引层": ["HNSW 内存图", "DuckDB 元数据", "Parquet 向量段"], } for layer, jobs in layers.items(): print(f"{layer}: {', '.join(jobs)}") ## 客户端层: Python/JS SDK, 序列化请求, 连接管理 ## 核心逻辑层: Collection 管理, where 解析, 查询规划, 结果合并 ## 存储索引层: HNSW 内存图, DuckDB 元数据, Parquet 向量段
一次查询的旅程(代码视角无法看见的部分)
## 你只写了一行 res = col.query(query_texts=["如何备份"], n_results=3, where={"type": "ops"}) ## 内部实际发生: ## 1. 客户端层: 把请求序列化发给核心层 ## 2. 核心层: 解析 where, 生成执行计划 -> 先按 type=ops 剪枝 ## 3. 存储层: 在 HNSW 图里对剩余候选做近邻搜索 ## 4. 核心层: 取回原文, 按距离排序, 合并 top3 ## 5. 客户端层: 反序列化返回给你 print("你看到的是结果, 看不到的是这 5 步") ## 输出: 你看到的是结果, 看不到的是这 5 步
为什么分层重要:一个真实卡点
背景:某服务查询偶发超时,团队一开始怀疑网络。
操作:在核心层加日志,发现耗时全在"元数据过滤后候选仍过大",HNSW 在近邻阶段扫了过多点。
结果:给 where 加了更具体的字段,候选从 50 万降到 5 万,延迟正常。
解读:问题出在层与层交界处(过滤没剪够),而不是某一层孤立慢。懂分层才能定位到"交界"。
变式:若过滤已很紧但仍慢,那是索引层 ef_search 问题,转到 3.2 和第六章调。
客户端层到底做了什么
前面把客户端层一句话带过,这里补一层:它不只是"转发请求",还承担嵌入函数的调用时机。当你调用 add 不传 embeddings 时,是客户端层在写入前悄悄调用你指定的嵌入函数把文档变成向量,再发往核心层。理解这一点,你才明白为什么"嵌入函数必须在建集合时定"——它是在客户端层被绑定的。
import chromadb from chromadb.utils import embedding_functions ef = embedding_functions.DefaultEmbeddingFunction() # 嵌入函数在客户端层生效: add 时不传 embeddings, 由它现场算 cli = chromadb.Client() col = cli.create_collection("client_layer", embedding_function=ef) col.add(ids=["x"], documents=["客户端层负责调嵌入函数"]) # 查询时同样走该函数, 保证向量空间一致 print(col.query(query_texts=["嵌入在哪算"], n_results=1)["documents"]) # 输出: [['客户端层负责调嵌入函数']]
这段说明:客户端层是"嵌入函数的作用边界",跨进程的服务端模式下这个职责会移到服务端,但语义不变。回到分层的意义——无论嵌入在哪算,核心层和存储层都不关心,它们只认向量。
我们看架构的取舍
Chroma 把"简单"放在第一优先级:三层边界清晰,默认实现不引入额外服务进程。这像建筑里"功能分区"——厨房、卧室、客厅分开,各自好维护。代价是当单层成为瓶颈(如单机内存)时,扩展要靠换存储后端而非简单加机器。
深度对照:分层不是装饰,是故障隔离
Chroma 的架构大致分三层:客户端接口、核心执行层、底层存储与索引。分层的目的不是"显得专业",而是让每一层可以独立替换或出问题时不拖垮全局。这像建筑的承重、机电、装修三层:装修坏了不影响承重,机电检修不必拆墙。
客户端只负责把你的调用翻译成内部请求;核心层决定怎么查、怎么算距离、怎么合并过滤;存储层管向量和元数据的落盘。理解这条链路,调性能时才知道瓶颈在哪一环。
## 用调用链表达一次查询经过的层(示意) chain = ["客户端接口", "请求解析", "元数据过滤", "向量检索", "结果合并", "存储读取"] for i, step in enumerate(chain, 1): print(f"第{i}环: {step}") ## 第1环: 客户端接口 ## 第2环: 请求解析 ## 第3环: 元数据过滤 ## 第4环: 向量检索 ## 第5环: 结果合并 ## 第6环: 存储读取
嵌入式架构带来的"隐性简化"
因为 Chroma 可以进程内运行,所谓"网络调用"在很多部署里根本不存在——客户端和核心层在同一个进程,省掉了序列化、连接池、超时那一整套分布式复杂度。这像在家做饭 vs 点外卖:前者厨房就在手边,后者要操心配送。代价是你自己负责厨房的卫生(备份、升级)。
⚠️ 常见坑:把嵌入式的简单误读为"没有架构"。正因为它分层清晰,你才能把存储换成持久化目录、把嵌入模型换成别家,而不动查询逻辑。
💡 关键直觉:评估架构别只看"组件多不多",要看"层与层之间能不能替换"。可替换的层,才是你未来腾挪的空间。
实践中的常见坑与关键直觉
- ⚠️ 把单进程当无限扩展:进程内架构省了网络,但内存和 CPU 仍受单机限制,规模大了要重新设计。
- ⚠️ 忽略层的边界做"绕过":直接碰底层存储文件绕过接口,升级时极易不兼容,等于给自己埋雷。
- 💡 排错按层二分:先确认客户端收到正确请求,再确认核心层返回,最后看存储,能快速定位。
- 💡 把"哪些层可换"列成清单,架构评审时这就是你的议价筹码和风险评估依据。
本节要点回顾:Chroma 分客户端层、核心逻辑层、存储索引层;查询先过滤后近邻,瓶颈常在层与层交界;清晰分层便于定位问题,代价是单层扩展靠换后端而非加机器。
⚠️ 查询慢别只盯网络——先判断耗时在过滤剪枝还是近邻搜索,二者解法完全不同。
💡 给 where 加具体字段能显著缩小近邻候选集,是性价比最高的首轮优化。