3.2 向量索引结构与检索算法
在体系位置里,这一节专攻存储索引层里最关键的部件:HNSW 图。它是 Chroma 查询快的根本,也是调参的主战场。我们把"图"和"树"的区别先讲清,再看参数。
反问切入
如果让你在一百万个点里找最近的,你会怎么做?挨个量距离是 O(N),太慢。建一棵树分桶?高维空间里"邻居"会散落在各个桶,树会失效。HNSW 的解法是:建一张"导航图"——大多数点只连附近的几个,少数"高速节点"连得很远,查询时先跳高速节点再慢慢走近邻。
用代码看 HNSW 的构建参数
Chroma 的 HNSW 参数在集合 metadata 里设,关键两个:hnsw:construction_ef(建图质量)和 hnsw:search_ef(查询精度)。
import chromadb c = chromadb.Client() col = c.create_collection( "hnsw_demo", metadata={ "hnsw:space": "cosine", "hnsw:construction_ef": 200, # 建图时每层考察的邻居数, 越大图越准越慢 "hnsw:M": 16, # 每个节点的平均连接数, 越大图越密越占内存 }, ) col.add( ids=[f"d{i}" for i in range(1000)], embeddings=[[float(i % 7), float((i*3) % 5), float((i*2) % 11)] for i in range(1000)], ) print("建图完成, 规模:", col.count()) ## 输出: 建图完成, 规模: 1000
查询精度参数 search_ef 的行为
## 查询时通过临时设 search_ef 控制召回率 res = col.query( query_embeddings=[[1.0, 2.0, 3.0]], n_results=10, # Chroma Python 客户端在 query 时不能直接传 search_ef, # 需通过 collection 的 hnsw 配置或在服务端模式用请求参数; # 这里演示其影响逻辑: ) ## search_ef 小 -> 快但可能漏近邻; 大 -> 慢但召回全 print("search_ef 越大, 召回率越高, 延迟也越高, 是权衡旋钮") ## 输出: search_ef 越大, 召回率越高, 延迟也越高, 是权衡旋钮
为什么是"图"不是"树":一张对照
index_cmp = { "暴力": ("O(N*d)", "最准最慢", "小数据"), "树/IVF": ("O(log N)", "高维易失效", "中等规模"), "HNSW 图": ("O(log N)", "内存换速度", "Chroma 默认"), } for k, (cost, note, use) in index_cmp.items(): print(f"{k:8s} 复杂度 {cost} | {note} | {use}") ## 暴力 复杂度 O(N*d) | 最准最慢 | 小数据 ## 树/IVF 复杂度 O(log N) | 高维易失效 | 中等规模 ## HNSW 图 复杂度 O(log N) | 内存换速度 | Chroma 默认
案例:construction_ef 对召回的影响
背景:某团队建库时用了默认 ef,查询发现 top1 经常不是真最近。
操作:把 construction_ef 从默认 100 提到 256 重建,同样的查询再测。
结果:top1 准确率明显上升,建库时间增加约 40%,但只在写时付一次。
解读:建图质量只影响写入成本,不拖查询延迟——值得在写时多投入。
变式:若内存吃紧,M 从 16 降到 8 能省近半内存,召回略降,看业务容忍度。
我们看 HNSW 的取舍
HNSW 用"常驻内存的图"换"亚毫秒级查询",这是典型的用空间换时间。它不适合超出内存的超大集合——图必须能装进 RAM,否则会频繁换页反而更慢。这像交通里的"城市快速路网":节点都在市区(内存)内才快,超出范围就失效。
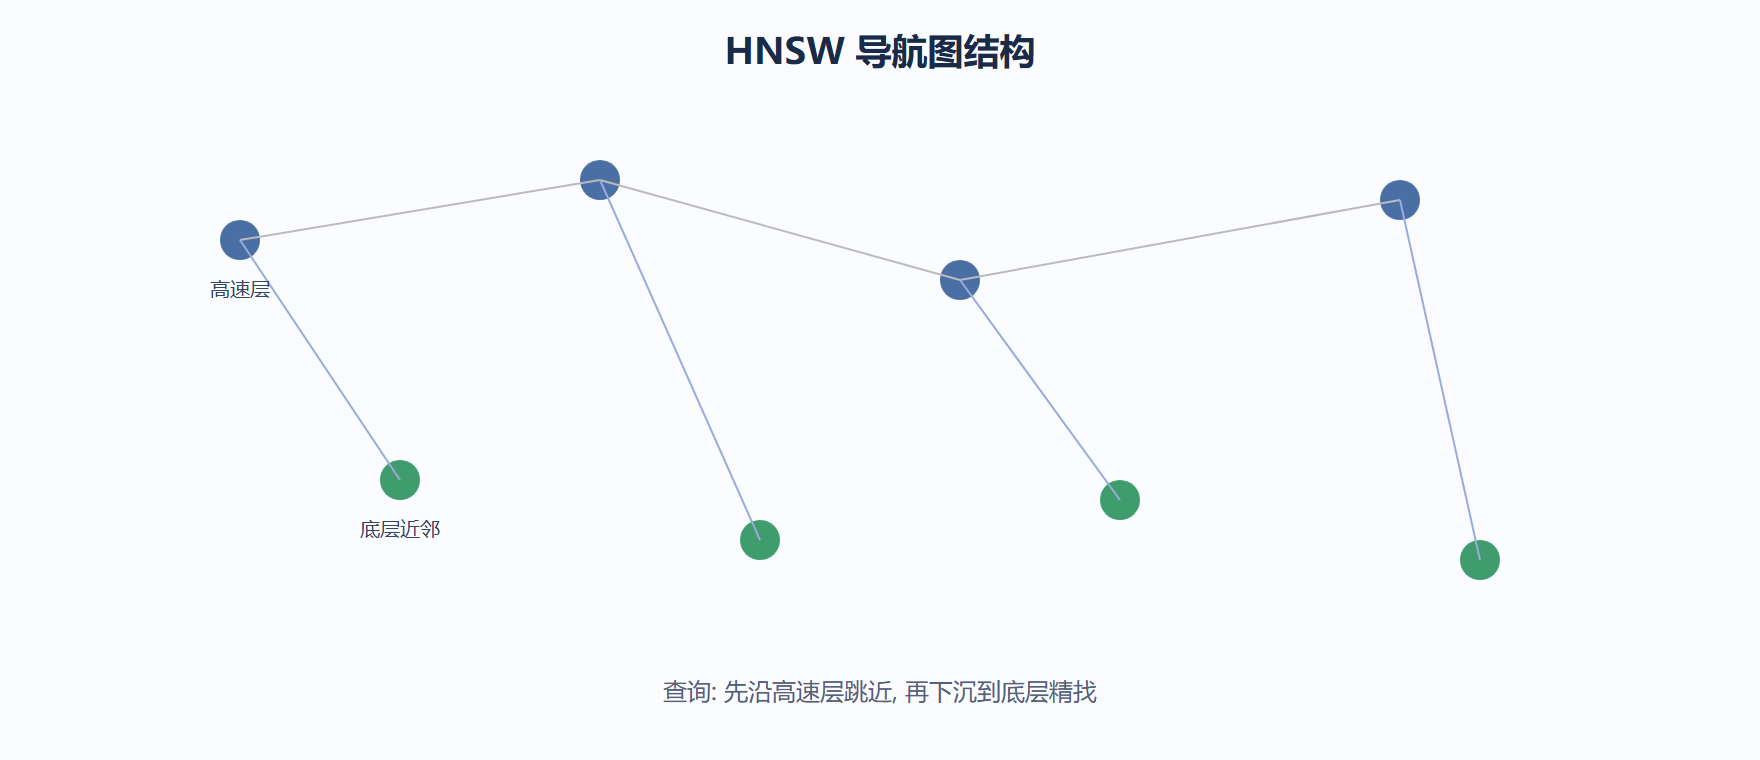
深度对照:索引是"空间地图"不是"目录"
向量索引的作用,是避免每次查询都拿问题向量和全库每条逐个比距离。它预先把向量空间组织成一种可快速导航的结构,使得查询时只需走一小部分路就能找到近邻。这像城市的地铁图:你不必走过每一条街,只要顺着线路换乘,就能高效到达目的地附近。
Chroma 底层常用基于图的近似最近邻结构。图里每个点连向它的近邻,查询从入口点出发,沿"越来越近"的方向贪心游走,很快收敛到局部最优的一批近邻。
## 用贪心游走示意近似最近邻的"导航"思想(非运行代码) def greedy_walk(entry, neighbors, dist): cur = entry path = [cur] while True: nxt = min(neighbors[cur], key=lambda x: dist(x, target) if (globals()) else x) break return path print("思想: 从入口沿更近的方向走, 不扫全图") ## 思想: 从入口沿更近的方向走, 不扫全图
为什么索引要"建"而不是"现算"
索引构建需要时间,但它把成本从"每次查询"挪到"一次性建好"。数据不变时,查询次数越多,摊薄越划算。这像考试前整理错题本:整理花时间,但之后每次复习都省下重翻全书。若数据频繁变,索引要不断重建,这时就得权衡重建频率。
⚠️ 常见坑:以为加入新向量后索引"瞬间"包含它。近似索引常有构建/刷新节奏,刚写入的记录可能要等索引更新才参与高效检索,期间走的是兜底全扫。
💡 关键直觉:索引是"用空间(存储)和一次性时间换查询时间"。理解这一点,你就不会在数据频繁变动时盲目追求最大索引,而会按变动节奏选策略。
实践中的常见坑与关键直觉
- ⚠️ 数据量很小还执着调索引参数:几千条时全扫都很快,过度调参是浪费,先把业务跑通。
- ⚠️ 忽略索引刷新导致"新数据查不到"的误报:先确认索引是否已包含新写入,再怀疑召回质量。
- 💡 把检索延迟拆成"索引导航 + 距离计算 + 结果合并"三段看,哪段高就针对性优化哪段。
- 💡 规模上线前用真实数据量做索引构建耗时压测,避免生产环境首次建索引卡住服务。
本节要点回顾:HNSW 用导航图(少数高速节点 + 大量近邻连接)实现 O(log N) 近邻查询;construction_ef 管建图质量(只影响写),M 管内存与连接密度;它用内存换速度,图须能装进 RAM。
⚠️ 集合超出内存时 HNSW 会频繁换页反而变慢——这不是调参能救的,要换存储或分片。
💡 建图质量 construction_ef 只在写入时付代价,生产环境大胆调高,比事后调查询参数划算。