3.3 数据存储与持久化
在体系位置里,这一节看存储索引层怎么把"内存里的图"变成"硬盘上的文件",以及重启后怎么恢复。这是第六章生产部署的底层依托,也是很多人担心"本地库靠不靠谱"的落点。
直接定义
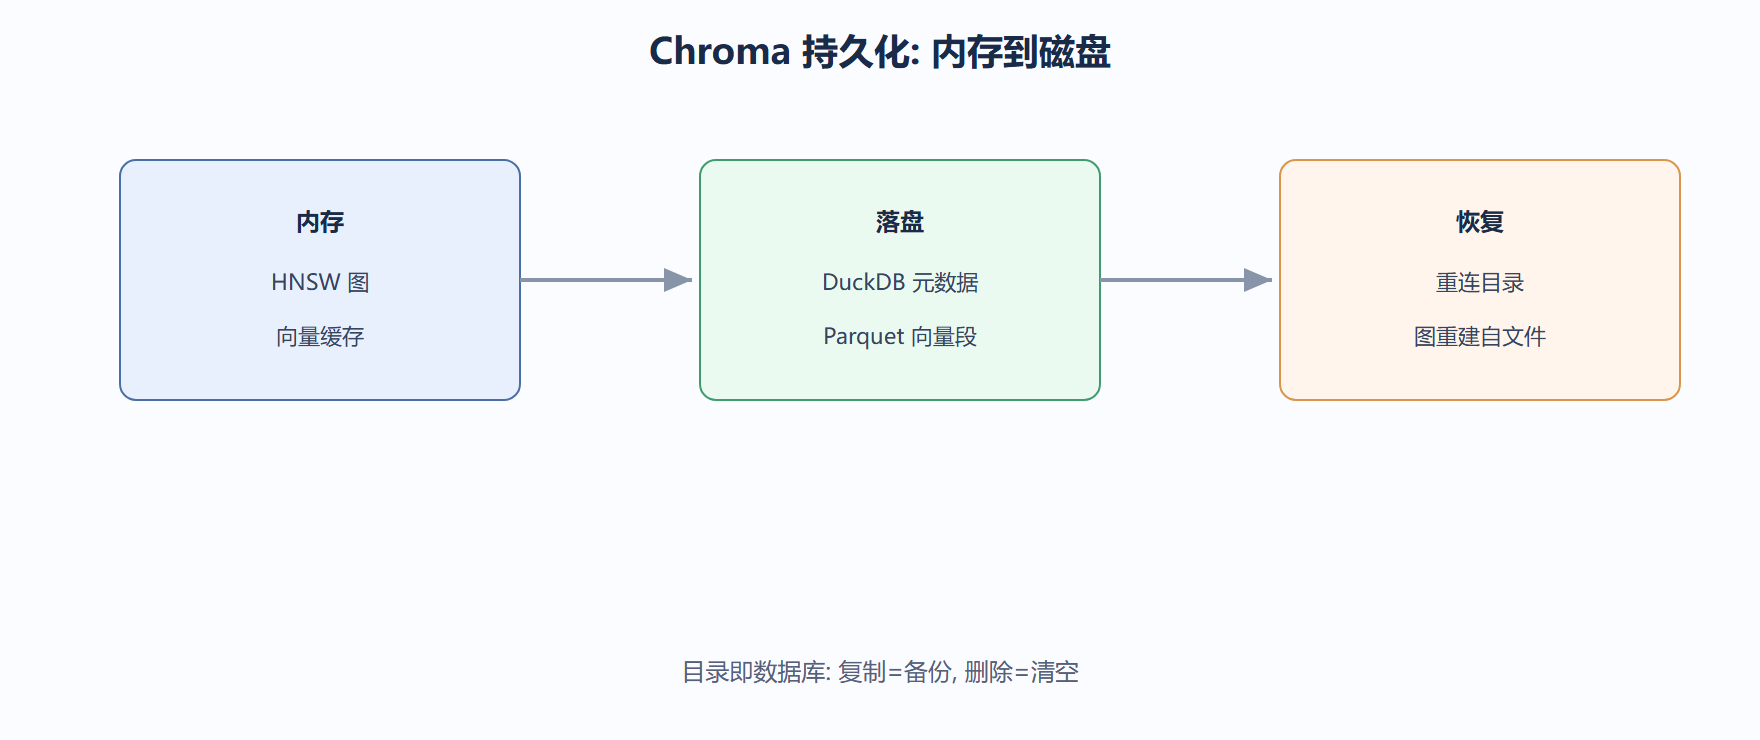
Chroma 默认用 duckdb+parquet:元数据(ids、metadatas、部分映射)存在 DuckDB 管理的表里,向量段存在 Parquet 列存文件里,HNSW 图的结构信息也随之一起落盘。PersistentClient 指定目录后,所有这些都写进那个目录,进程退出不丢。
看落盘长什么样
import chromadb, os path = "./my_chroma_db" if os.path.exists(path): import shutil; shutil.rmtree(path) client = chromadb.PersistentClient(path=path) col = client.create_collection("persist_demo") col.add(ids=["p1", "p2"], documents=["第一条", "第二条"], metadatas=[{"k": 1}, {"k": 2}]) print("目录内容:", sorted(os.listdir(path))) ## 输出类似: ['.duckdb', 'xxxx.parquet', ...] (具体文件名带 uuid)
这段说明:所谓"数据库"就是目录下几个文件。复制目录 = 备份;删目录 = 清空。管理心智和管普通文件一致。
重启恢复
## 重新连同一个目录, 数据还在 client2 = chromadb.PersistentClient(path=path) col2 = client2.get_collection("persist_demo") print("重启后条数:", col2.count()) ## 输出: 重启后条数: 2 print("重启后内容:", col2.get(ids=["p1"])["documents"]) ## 输出: 重启后内容: ['第一条']
为什么用 Parquet 而不是 CSV
reasons = { "Parquet": ["列存压缩高", "类型自描述", "向量段批量读快", "适合分析引擎"], "CSV": ["文本存储大", "无类型", "逐行解析慢", "不适合向量"], } for k, v in reasons.items(): print(f"{k}: {', '.join(v)}") ## Parquet: 列存压缩高, 类型自描述, 向量段批量读快, 适合分析引擎 ## CSV: 文本存储大, 无类型, 逐行解析慢, 不适合向量
案例:误删文件后的恢复策略
背景:运维误删了 chroma 目录下的某个 parquet,查询报"段缺失"。
操作:因之前有整目录定时备份,从备份恢复整个目录,而非单文件修补。
结果:服务十分钟内恢复,没有逐文件拼凑的隐患。
解读:把"库"当"目录"管理,备份单位就是目录,简单可靠。这像生物里"整颗种子"比"单片叶子"更能复原。
变式:若没有整目录备份,单 parquet 缺失会导致部分向量不可查,应触发重建该集合而非侥幸继续。
我们看持久化的取舍
duckdb+parquet 把"嵌入式"做到极致:无服务进程、文件即库、易备份。代价是大规模高并发写时,单文件锁会成为瓶颈——这正是第六章要换服务端模式的原因。理解落盘格式,你才知道"迁移"其实就是搬目录,"损坏"要按目录粒度恢复。
深度对照:持久化是"把记忆写进本子"
嵌入式模式下,Chroma 的向量和元数据最终落在本地目录的文件中(底层借助单机分析引擎与列存格式)。持久化的意义是:进程重启、机器重启,你的数据还在,不像纯内存数据库一断电就归零。这像把密码记在笔记本而非只靠脑子——脑子(内存)快但易失,笔记本(磁盘)慢但长久。
持久化客户端和临时客户端的核心区别,就是"有没有把数据落到目录"。临时客户端适合试跑和单测,持久化客户端适合真实业务。
## 用对照说明两种客户端的生命期(示意) modes = { "临时客户端": {"落盘": "否", "重启后": "数据消失", "用途": "实验/测试"}, "持久化客户端": {"落盘": "是", "重启后": "数据仍在", "用途": "真实业务"}, } for k, v in modes.items(): print(f"{k}: 落盘={v['落盘']} 重启后={v['重启后']}") ## 临时客户端: 落盘=否 重启后=数据消失 用途=实验/测试 ## 持久化客户端: 落盘=是 重启后=数据仍在 用途=真实业务
备份其实只是"复制文件"
因为数据就是目录里的几个文件,备份不需要特殊工具——复制目录即可,版本管理也能直接套用。这比"导出 sql 再导入"轻得多。但反过来,责任也回到你:你不备份,没人替你存。
⚠️ 常见坑:直接热复制正在写入的目录,可能拿到半截文件。应确认没有写入在进行,或用导出机制拿到一致快照。
💡 关键直觉:持久化降低了"存"的门槛,但抬高了"管"的责任。把备份写进你的运维 checklist,比依赖任何高级特性都实在。
实践中的常见坑与关键直觉
- ⚠️ 把临时客户端用于业务:程序一关数据没了,还以为是 bug,其实是模式选错。
- ⚠️ 多个进程同时写同一目录:文件级并发写可能损坏数据,单机嵌入式应控制写入口。
- 💡 把数据目录纳入整体备份策略,和你的主库备份一起排期,别让向量库成为备份盲区。
- 💡 升级版本前先备份目录,万一格式不兼容还能回退,这是嵌入式模式给你的自由也是风险。
一个热备翻车的案例
背景:某人在服务写入时直接复制数据目录做备份,恢复发现文件半截。
操作:忽略了"写入进行中复制不一致",拿到损坏快照。
结果:改为先停写或用导出机制取一致快照,备份可靠。
解读:持久化简化了"存",但备份要讲方法,热复制有坑。这像拍照时人还在动会糊。
变式:若不能停写,用支持一致快照的导出通道,拿到的是某时刻完整视图。
一个边界提醒
持久化不等于"高可用"。它解决重启不丢,但不解决磁盘坏、误删、版本不兼容。完整可靠要靠"持久化 + 备份 + 版本策略"三件套,缺一不可。这像存钱:活期账户(持久化)之外还得有保险柜和记账(备份)。
本节要点回顾:Chroma 默认 duckdb+parquet 落盘,目录即库;重启重连目录即恢复;Parquet 列存适合向量段;备份单位是整个目录。嵌入式极致简单,代价是高并发写有单文件锁瓶颈。
⚠️ 别试图只恢复单个 parquet 来修"段缺失"——按目录粒度从备份复原,单文件拼凑会留隐患。
💡 把 chroma 目录纳入整目录定时备份,比任何精细备份策略都简单可靠。