4.2 Collection 管理
在体系位置里,这一节管"容器":Collection 是 Chroma 里所有数据的一级组织单位。怎么建、怎么命名、怎么设度量、怎么删,这一节一次讲清,因为后面的增删改查都作用在 Collection 上。
场景代入
想象你要管一个公司的文档:技术文档、产品文档、HR 文档混在一起会互相干扰。最自然的做法是分三个 Collection——这正是 Collection 的用途,它是"同一向量空间、同一业务域"的边界。
创建与命名
import chromadb c = chromadb.Client() tech = c.create_collection("tech_docs", metadata={"hnsw:space": "cosine"}) print("已建集合:", tech.name, "度量:", tech.metadata.get("hnsw:space")) ## 输出: 已建集合: tech_docs 度量: cosine
注意:集合名在客户端内要唯一,重复 create_collection 会报错。若要"有则取无则建",用 get_or_create_collection。
same = c.get_or_create_collection("tech_docs") print("复用同一集合, 条数:", same.count()) ## 输出: 复用同一集合, 条数: 0
列出与获取
all_cols = c.list_collections() print("当前集合:", [x.name for x in all_cols]) ## 输出: 当前集合: ['tech_docs'] got = c.get_collection("tech_docs") print("取到的集合名:", got.name) ## 输出: 取到的集合名: tech_docs
删除集合(危险操作)
## 删除会清空该集合全部数据, 不可恢复(除非有目录备份) c.delete_collection("tech_docs") print("删除后列表:", [x.name for x in c.list_collections()]) ## 输出: 删除后列表: []
案例:多业务域分集合
背景:一个平台同时有"课程视频文案"和"用户评论",两者语义分布差异大。
操作:建 course 和 comment 两个集合,各自独立写入与查询。
结果:课程查询不会误召回评论,评论情感分析也不会被课程长文干扰。
解读:分集合本质是"分向量空间"——不同分布的语料放一起会互相污染近邻排序。这像建筑里"不同功能分区",住宅和工厂不混建。
变式:若两域偶有交叉查询,可保留分集合,查询时并行查两个再合并结果,比硬塞一起更可控。
多个集合的元数据存储
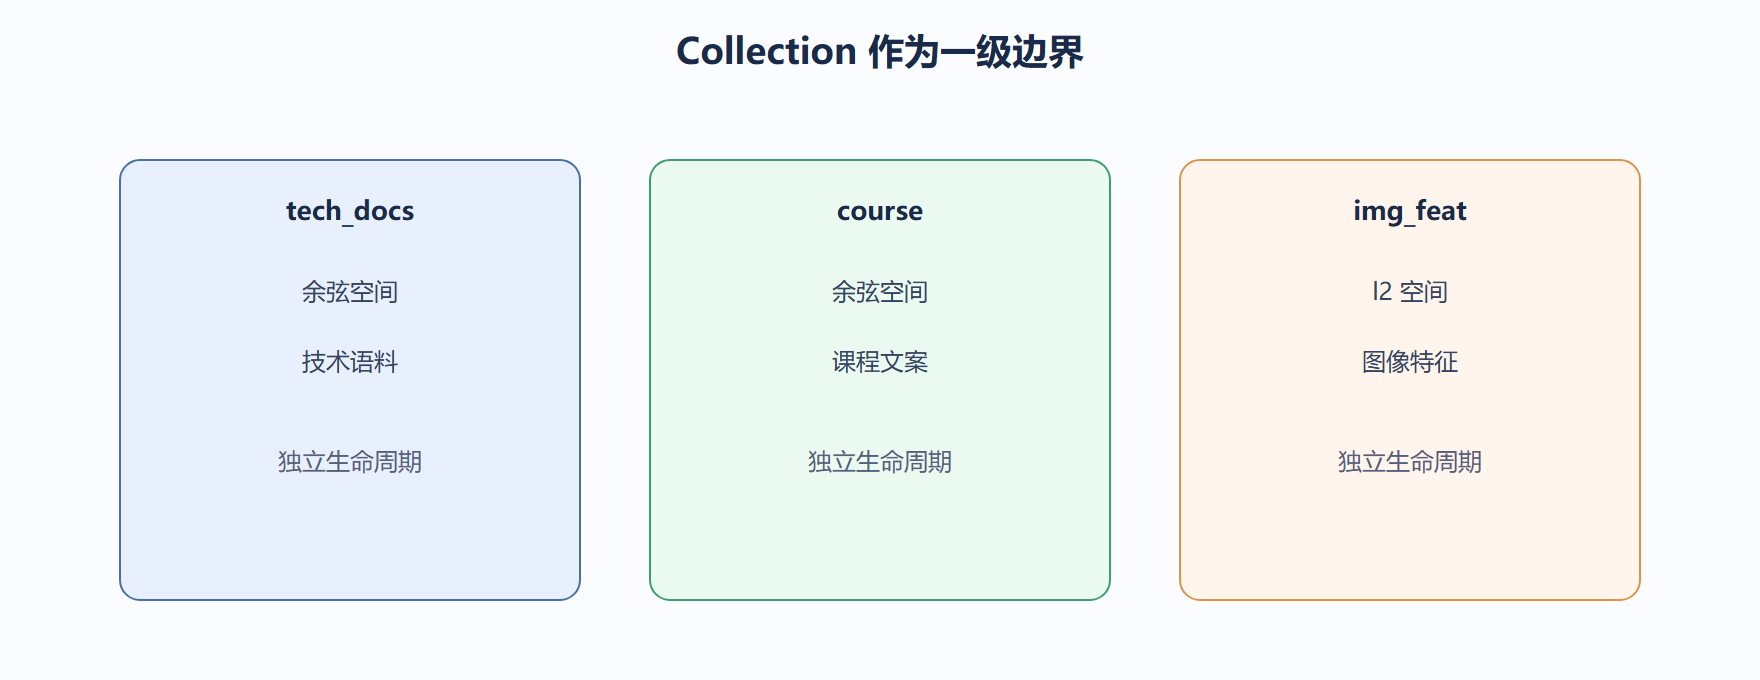
Chroma 的元数据(如度量空间)在集合级设置,不是全局。这意味着你可以一个库里既有 cosine 的文本集合,又有 l2 的图像集合,互不冲突。
img_col = c.create_collection("img_feat", metadata={"hnsw:space": "l2"}) print("文本空间:", tech.metadata, "图像空间:", img_col.metadata) ## 输出: 文本空间: {'hnsw:space': 'cosine'} 图像空间: {'hnsw:space': 'l2'}
我们看集合管理的取舍
Collection 给的是"边界清晰"——每个集合独立空间、独立度量、独立生命周期。代价是跨集合查询要自己合并。数据域明显不同时,分集合几乎是必选项;域相近时,用单个集合加元数据过滤(见 4.4)更轻。
深度对照:建 Collection 是"立规矩"不是"建文件夹"
创建 Collection 时你要定下的,不只是名字,还有嵌入模型和距离度量——这些一旦确定,后面所有写入都按这套规矩来。这像成立一个协会要先定章程:会员准入标准(嵌入模型)和评比办法(距离度量)定下后,才接收会员(记录)。
很多人随手建 Collection 不指定参数,结果用了默认度量,后来发现不适配自己的数据分布,再改就要重建,代价不小。
## 创建时就把"规矩"定清楚(示意) rules = { "name": "faq_cn", "embedding_model": "需与写入向量一致", "metric": "cosine(文本默认推荐)", "metadata_schema": "先约定键名", } print("建 Collection 前确认:", list(rules.keys())) ## 建 Collection 前确认: ['name', 'embedding_model', 'metric', 'metadata_schema']
改名与删库的取舍
Collection 名字创建后通常不直接"改名",更常见的做法是新建一个、迁移数据、再删旧的。删除则是不可逆操作,相当于把整个抽屉连同内容丢弃。这像搬家:先在新柜子摆好,再清旧柜子,而不是边住边拆。
⚠️ 常见坑:用程序循环里动态建 Collection 却不检查是否已存在,重复创建或命名冲突导致逻辑错乱。建之前先查存在性。
💡 关键直觉:Collection 的"创建成本"很低,但"重建成本"很高(要重嵌数据)。所以创建前的参数确认,是一次性投入、长期回报。
实践中的常见坑与关键直觉
- ⚠️ 把 Collection 当临时变量随手建:脚本跑完忘清理,环境里堆满 test_xxx,管理混乱。
- ⚠️ 删除前不备份:误删后向量不可恢复,原始文档若也没留底,等于数据归零。
- 💡 用命名约定表达用途与版本,如 faq_cn_v2,升级模型时新老并存灰度,验证后再切。
- 💡 把 Collection 清单和维护人写进项目文档,避免"这个库谁建的、干嘛用的"无人知晓。
一个命名救场的案例
背景:团队早期把所有数据塞进一个 Collection,半年后没人记得里面有哪些来源。
操作:按业务域拆分出 faq_cn、docs_en、logs 三个 Collection,名字即文档。
结果:查询时范围显著缩小,延迟下降,新成员也能一眼看懂结构。
解读:好的命名是免费的文档。Collection 名承载语义,省去大量口头解释。这像仓库分区贴标,找货快一倍。
变式:若某域再细分,用 faq_cn_v2 灰度,验证稳了再弃旧,避免一刀切风险。
本节要点回顾:Collection 是 Chroma 的一级数据边界,含独立向量空间、度量与生命周期;get_or_create_collection 避免重复创建报错;删除不可恢复需谨慎;不同分布语料应分集合以防近邻污染。
⚠️ delete_collection 清空且不可恢复——生产环境执行前确认有目录级备份,或加二次确认。
💡 数据域差异大时果断分集合;域相近时优先单集合加元数据过滤,跨集合合并查询更麻烦。