4.3 数据 CRUD 操作
在体系位置里,这一节是 Collection 建好之后的日常操作:增、查、改、删。CRUD 看似基础,但 Chroma 的"改"和"删"有些语义细节,踩过才知道。
直接写代码:增(add)
add 要求 ids 在集合内唯一,重复会报错。这是写数据的第一道约束。
import chromadb c = chromadb.Client() col = c.create_collection("crud") col.add( ids=["a1", "a2"], documents=["Chroma 支持元数据过滤", "HNSW 是默认索引"], metadatas=[{"cat": "api"}, {"cat": "index"}], ) print("写入后:", col.count()) ## 输出: 写入后: 2 try: col.add(ids=["a1"], documents=["重复会报错"]) # 重复 id except Exception as e: print("重复 id 报错:", type(e).__name__) ## 输出: 重复 id 报错: ValueError (或 DuplicateIDError)
查(get)
get 按 id 精确取,不走向量检索,适合"我知道要哪条"。
row = col.get(ids=["a1"], include=["documents", "metadatas"]) print(row["documents"], row["metadatas"]) ## 输出: ['Chroma 支持元数据过滤'] [{'cat': 'api'}]
改(upsert / update)
update 改已有 id 的字段,id 不存在会报错;upsert 则是"有则改无则加",更省心。
## update: 必须 id 已存在 col.update(ids=["a1"], documents=["Chroma 支持 where 过滤"]) print(col.get(ids=["a1"])["documents"]) ## 输出: ['Chroma 支持 where 过滤'] ## upsert: 不存在就新增 col.upsert(ids=["a3"], documents=["新增或更新都行"], metadatas=[{"cat": "new"}]) print("upsert 后:", col.count()) ## 输出: upsert 后: 3
删(delete)
col.delete(ids=["a3"]) print("删除后:", col.count()) ## 输出: 删除后: 2 ## 按元数据批量删 col.add(ids=["a4"], documents=["待清", metadatas=[{"cat": "tmp"}]] or ["待清"], metadatas=[{"cat": "tmp"}]) col.delete(where={"cat": "tmp"}) print("按元数据删后:", col.count()) ## 输出: 按元数据删后: 2
案例:文档版本更新用 upsert
背景:知识库文档会修订,修订后要用新内容覆盖旧向量。
操作:以文档稳定 id 做 upsert,Chroma 自动重算该条向量并覆盖。
结果:同一 id 始终对应最新版,不需要先 delete 再 add。
解读:upsert 把"改"封装成幂等操作,重试安全。这像金融账户"存入"而非"先取再存",少一步就少一个出错点。
变式:若需保留历史版本,别覆盖,改用带版本号的 id(如 doc_v2)并靠元数据过滤取最新。
我们看 CRUD 的取舍
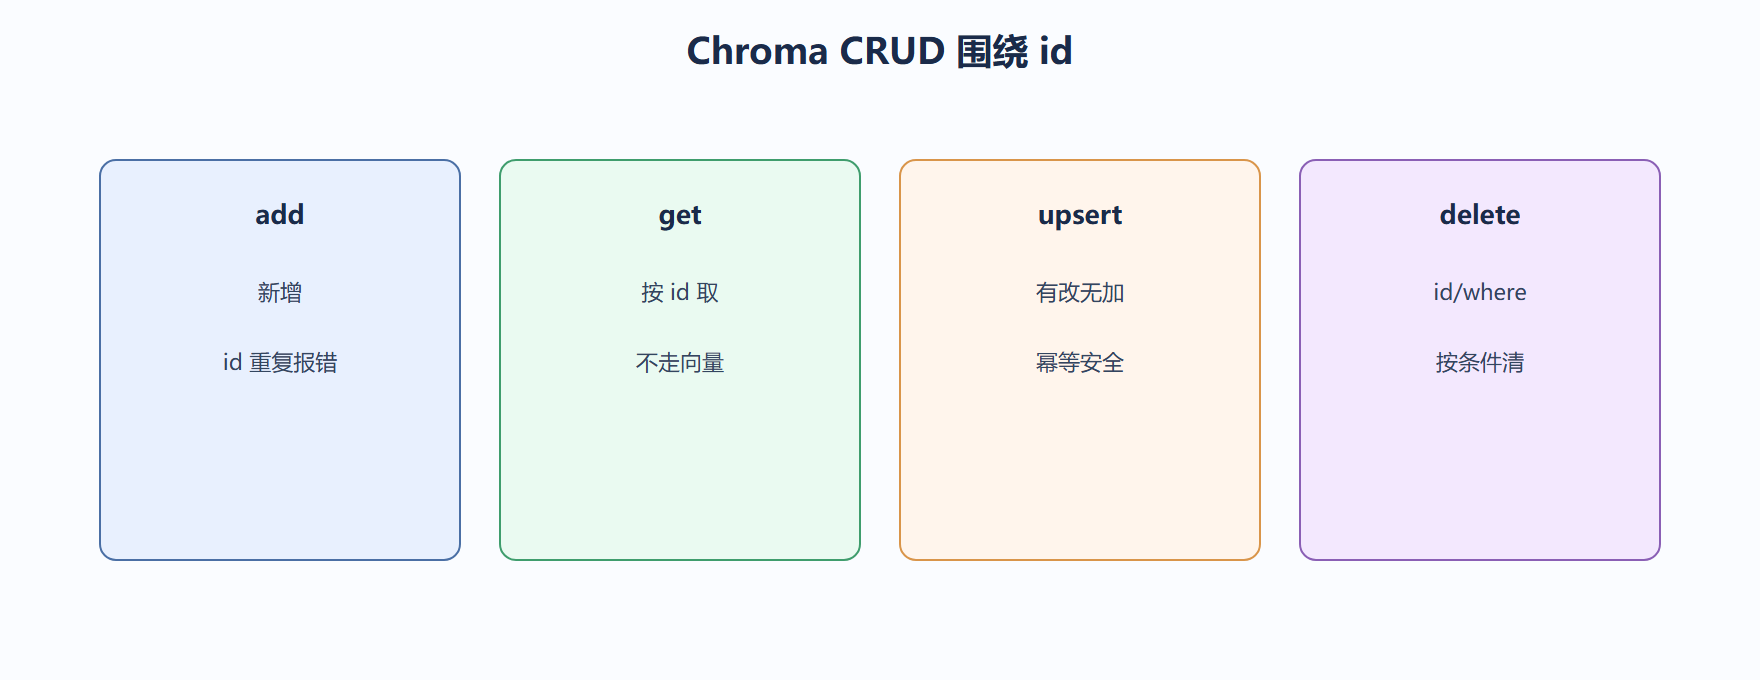
Chroma 的增删改都围绕 id 这个锚点:add 防重复、update 防误建、upsert 图省心、delete 支持按 id 或按 where。理解"id 是唯一的修改入口"后,所有写操作都不混乱。代价是它不做跨文档事务——多条写入中途失败不会自动回滚,需要你自己保证。
深度对照:CRUD 在向量库里的"变味"
传统 CRUD 里 Update 是改某行字段,向量库里的"更新"往往不是改向量,而是用新内容重新嵌入再写入(upsert)。因为向量是内容算出来的,内容变了,旧向量就失效。这像换照片:你不会在旧底片上涂改,而是重洗一张贴上去。
add 与 upsert 的区别也关键:add 要求 id 不存在,重复会报错;upsert 则是"有则更新、无则插入",更适合持续同步。
## 用对照说明 add 与 upsert 的行为(非运行代码) ops = { "add": {"id存在时": "报错", "语义": "首次写入"}, "upsert": {"id存在时": "覆盖", "语义": "同步更新"}, } for k, v in ops.items(): print(f"{k}: id存在={v['id存在时']} 用途={v['语义']}") ## add: id存在=报错 用途=首次写入 ## upsert: id存在=覆盖 用途=同步更新
删除的粒度
删除可以按 id 删单条,也可以按元数据条件批量删。批量删适合"下架某来源的全部文档"这类场景。这像图书馆退书:一本一本退,或按"某出版社全部"整批退,工具要选对。
⚠️ 常见坑:用 add 做每日同步,碰上已存在的 id 直接抛异常中断。持续写入应默认用 upsert,除非你明确要"重复即报错"的强约束。
💡 关键直觉:向量库的写操作本质是在"维护一份嵌入快照"。任何源数据变化,都要触发重新嵌入,否则库里存的是过期语义。
实践中的常见坑与关键直觉
- ⚠️ 改了源文档却只 update 元数据不重嵌:向量还是旧内容算的,检索会返回语义错位的结果。
- ⚠️ 大批量写不分批:一次塞十万条可能撑爆内存或超时,分批写入更稳。
- 💡 给每条记录带"源版本"元数据,upsert 时连带更新,查询可按版本过滤,避免新旧混排。
- 💡 把写操作做成幂等:同样的同步跑两遍结果一致,出问题重跑不脏数据。
幂等写入的小案例
背景:每日同步脚本因网络抖动重跑,用 add 导致重复 id 报错中断。
操作:改成 upsert,重跑时已有记录被覆盖而非报错。
结果:脚本可安全重试,数据不重不漏。
解读:写操作做成幂等,是运维友好的基本素养。这像转账:重复提交不该扣两次钱。
变式:若需审计"何时改过",在元数据写 updated_at,upsert 时一并更新即可追溯。
本节要点回顾:Chroma 的增删改查都以 id 为锚;add 重复报错、update 要求存在、upsert 幂等最省心、delete 支持 id 或 where;不做跨文档事务,多条写入需自行保证。
⚠️ Chroma 没有跨文档事务——批量 add 中途失败不会回滚,生产写入要有重试或分批校验机制。
💡 文档修订优先用 upsert 而非 delete+add,幂等且重试安全,版本历史需求才用带版本号 id。