4.5 数据导入导出与迁移
在体系位置里,这一节收尾第四章:数据从哪来、怎么批量进 Chroma、怎么搬走。真实项目里数据从来不是手敲几条,而是从 CSV/JSON/数据库灌进来,或要整体迁移到另一台机器。
从一个反例说起
有人图省事,把十万条文档在一个 add 调用里全传进去,结果内存爆了、超时了。Chroma 的 add 虽支持批量,但一次塞太多会压垮客户端内存和建图过程。正确做法是分批。
从 JSON 批量导入
import chromadb, json client = chromadb.Client() col = client.create_collection("import_demo") docs = [ {"id": f"d{i}", "text": f"文档内容编号 {i}", "cat": "bulk"} for i in range(250) ] ## 分批, 每批 50 batch = 50 for i in range(0, len(docs), batch): chunk = docs[i:i+batch] col.add( ids=[d["id"] for d in chunk], documents=[d["text"] for d in chunk], metadatas=[{"cat": d["cat"]} for d in chunk], ) print("导入完成, 总条数:", col.count()) ## 输出: 导入完成, 总条数: 250
分批的因果:每批独立建图、独立占内存,批大小是可调的"内存/速度"旋钮。太小慢、太大爆,50~500 是常见区间。
导出为可迁移格式
## 用 get 全量取出, 转成 JSON 便于搬运 all_data = col.get(include=["documents", "metadatas", "embeddings"]) export = { "ids": all_data["ids"], "documents": all_data["documents"], "metadatas": all_data["metadatas"], "embeddings": all_data["embeddings"], } with open("export.json", "w", encoding="utf-8") as f: json.dump(export, f, ensure_ascii=False) print("导出条数:", len(export["ids"])) ## 输出: 导出条数: 250
注意导出时带上 embeddings,这样导入别处不用重新算向量,省时且保证向量空间一致。
目录级迁移(最省事)
## 若用 PersistentClient, 直接搬目录即可, 不必导出 JSON ## 源: ./chroma_data 目标机器同路径解压 import shutil, os if os.path.exists("./chroma_data"): shutil.make_archive("chroma_data", "zip", "./chroma_data") print("已打包目录, 可整体迁移") ## 输出: 已打包目录, 可整体迁移
案例:换机器不重算向量
背景:训练机建好 50 万条向量库,要搬到生产机。
操作:用 get(include=["embeddings"]) 导出带向量的 JSON,在生产机 add 时显式传 embeddings(不传则重算,且默认模型可能不同)。
结果:生产机向量空间和训练机完全一致,查询行为不变,且省去重算的算力。
解读:带 embedding 迁移 = 复制"坐标",不带 = 重新"测量",后者有模型漂移风险。这像建筑图纸搬迁——带原始尺寸搬家才不会走样。
变式:若嵌入模型已统一锁定,也可直接搬目录,比 JSON 更快且保留索引结构。
我们看迁移的取舍
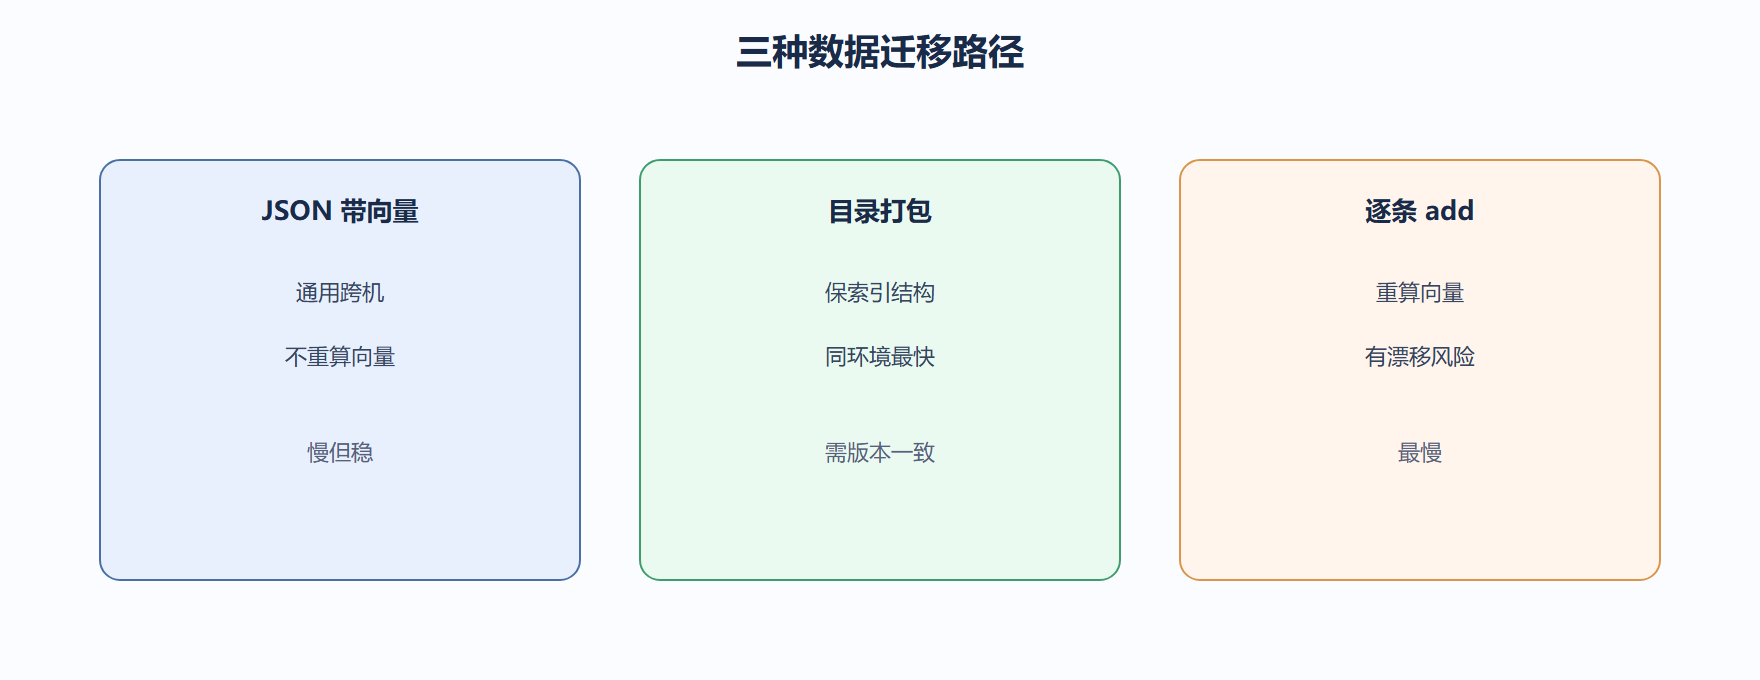
三种迁移路径各有适用:JSON 带向量最通用(跨版本跨机),目录打包最快(保索引),逐条 add 最慢(重算)。选型看"是否要保索引"和"环境是否一致"。无论哪种,锁定嵌入函数是前提,否则迁移后向量空间对不上。
深度对照:迁移是"搬家"不是"复制粘贴"
把数据从一个 Chroma 环境搬到另一个,难点不在复制,而在于"嵌入模型和度量方式要一致"。如果目标环境用了不同的嵌入模型,直接搬向量过去,距离全错。这像把一套用公制标的坐标搬到英制地图——数字还在,意义没了。
因此迁移前先确认:源和目标的嵌入模型、距离度量、元数据 schema 是否对齐。对齐了,导出再导入才安全。
## 迁移前的一致性检查清单(示意) checklist = ["嵌入模型一致", "距离度量一致", "元数据键名一致", "id 不冲突"] print("迁移前核对:", checklist) ## 迁移前核对: ['嵌入模型一致', '距离度量一致', '元数据键名一致', 'id 不冲突']
导出的两种思路
一种是从客户端按 Collection 读出记录(id、文档、元数据),在目标端重新嵌入写入;另一种是直接搬底层存储文件。前者更稳(重新嵌入保证模型一致),后者更快但要求两端版本兼容。
⚠️ 常见坑:直接复制底层文件到版本不同的环境,格式不兼容打不开,还以为文件损坏。跨大版本迁移优先走"读出-重嵌-写入"路径。
💡 关键直觉:向量数据真正的"源"是你的原始文档,向量只是派生产物。只要原始文档在,任何环境都能重建向量库,所以迁移时保住原文比保住向量更根本。
实践中的常见坑与关键直觉
- ⚠️ 只搬向量不搬原始文档:一旦模型要换,向量全废且无法重算,陷入死局。
- ⚠️ 迁移后不抽样验证:搬完就上线,结果发现部分记录缺失,影响召回。
- 💡 迁移走灰度:新老环境并行跑一段时间比对召回,确认一致再切流量。
- 💡 把"原始文档 -> 向量"的流水线索留好,未来任何重嵌、重迁都有据可依。
一次迁移翻车的案例
背景:某人直接复制底层文件到新版本环境,打开报格式不兼容。
操作:误以为"文件在就能用",忽略了版本间格式差异。
结果:改用"读出记录-重嵌-写入"路径,顺利迁完。
解读:向量库的真相源是原始文档,迁文件不如迁数据。这像搬家用照片备份而非底片,丢了冲印能力。
变式:大库迁移分 Collection 灰度,每批验证召回一致再切,降低整体风险。
本节要点回顾:批量导入要分批(50~500/批)控制内存;导出务必带 embeddings 以保向量空间一致;目录打包迁移最快但需版本一致;逐条 add 会重算有漂移风险。锁定嵌入函数是迁移前提。
⚠️ 迁移时不带 embeddings 而依赖重新 add 算向量,若默认模型已变,旧查询会静默失效——务必显式传 embedding 或锁模型。
💡 跨机器跨版本迁移优先选 JSON 带向量;同环境同版本直接打包目录,既保索引又最快。