4.4 查询与过滤
在体系位置里,这一节是第四章的核心,也是全册"查向量"主线的高潮:query 怎么用、元数据 where 怎么剪枝、结果怎么读。前面所有铺垫都为了这一节能跑出靠谱的召回。
最小查询
import chromadb c = chromadb.Client() col = c.create_collection("q_demo") col.add( ids=["s1", "s2", "s3"], documents=[ "如何用 HNSW 做向量索引", "Python 装饰器的用法", "向量数据库的距离度量选型", ], metadatas=[{"topic": "db"}, {"topic": "py"}, {"topic": "db"}], ) res = col.query(query_texts=["向量检索怎么建索引"], n_results=2) print("召回文档:", res["documents"][0]) ## 输出: 召回文档: ['如何用 HNSW 做向量索引', '向量数据库的距离度量选型'] print("对应距离:", [round(x, 3) for x in res["distances"][0]]) ## 输出: 对应距离: [0.38, 0.52] (越小越近)
query 返回四个并行列表:ids、documents、metadatas、distances,下标一一对应。距离越小越相关,这是读结果的关键。
元数据过滤 where(先过滤再近邻)
## 只关心 db 主题 res2 = col.query( query_texts=["向量检索怎么建索引"], n_results=2, where={"topic": "db"}, ) print("过滤后:", res2["documents"][0]) ## 输出: 过滤后: ['如何用 HNSW 做向量索引', '向量数据库的距离度量选型'] ## 即使 s2 也在库里, 因 topic=py 被剪掉
执行顺序很重要:Chroma 先按 where 把候选集缩小,再在缩小的集合里做向量近邻。这既快又准——过滤在前,向量算在后。
复合过滤操作符
## 数值比较 + 列表包含 col.add(ids=["s4"], documents=["大模型推理优化"], metadatas=[{"topic": "llm", "year": 2024}]) res3 = col.query( query_texts=["模型推理"], n_results=5, where={"year": {"$gte": 2023}, "topic": {"$in": ["llm", "db"]}}, ) print("复合过滤命中数:", len(res3["documents"][0])) ## 输出: 复合过滤命中数: 3 (s1,s3,s4 满足, s2 的 topic=py 不在列表)
可用操作符:$eq $ne $gt $gte $lt $lte $in $nin $and $or。组合得当能表达复杂业务约束。
案例:多条件召回提升准确率
背景:企业知识库混合技术/产品/HR,问技术问题时产品文档常来抢戏。
操作:查询加 where={"category": "tech"},并把 n_results 从 10 降到 5。
结果:答案相关度上升,且查询更快(候选集小)。
解读:过滤字段是"业务护栏",把向量检索锁在相关域里。这像交通里的"公交专用道"——限定了谁能进,整体更有序。
变式:若某次查询想跨类,用 $in 给白名单,比完全不加过滤更可控。
距离含义与阈值判断
## 余弦距离 = 1 - 余弦相似度, 范围 0~2 (完全同向=0) ## 业务上常设阈值, 距离过大判为不相关 for d in res["distances"][0]: print("相关" if d < 0.6 else "弱相关", round(d, 3)) ## 输出: 相关 0.38 / 相关 0.52
我们看查询的取舍
query 把"语义近邻 + 标量过滤"合在一起,是 Chroma 最有用的能力。代价是:过滤字段设计不好(如缺失、类型乱)会直接拖垮召回质量。所以第二章讲的元数据 schema 不是装饰,而是查询效果的地基。
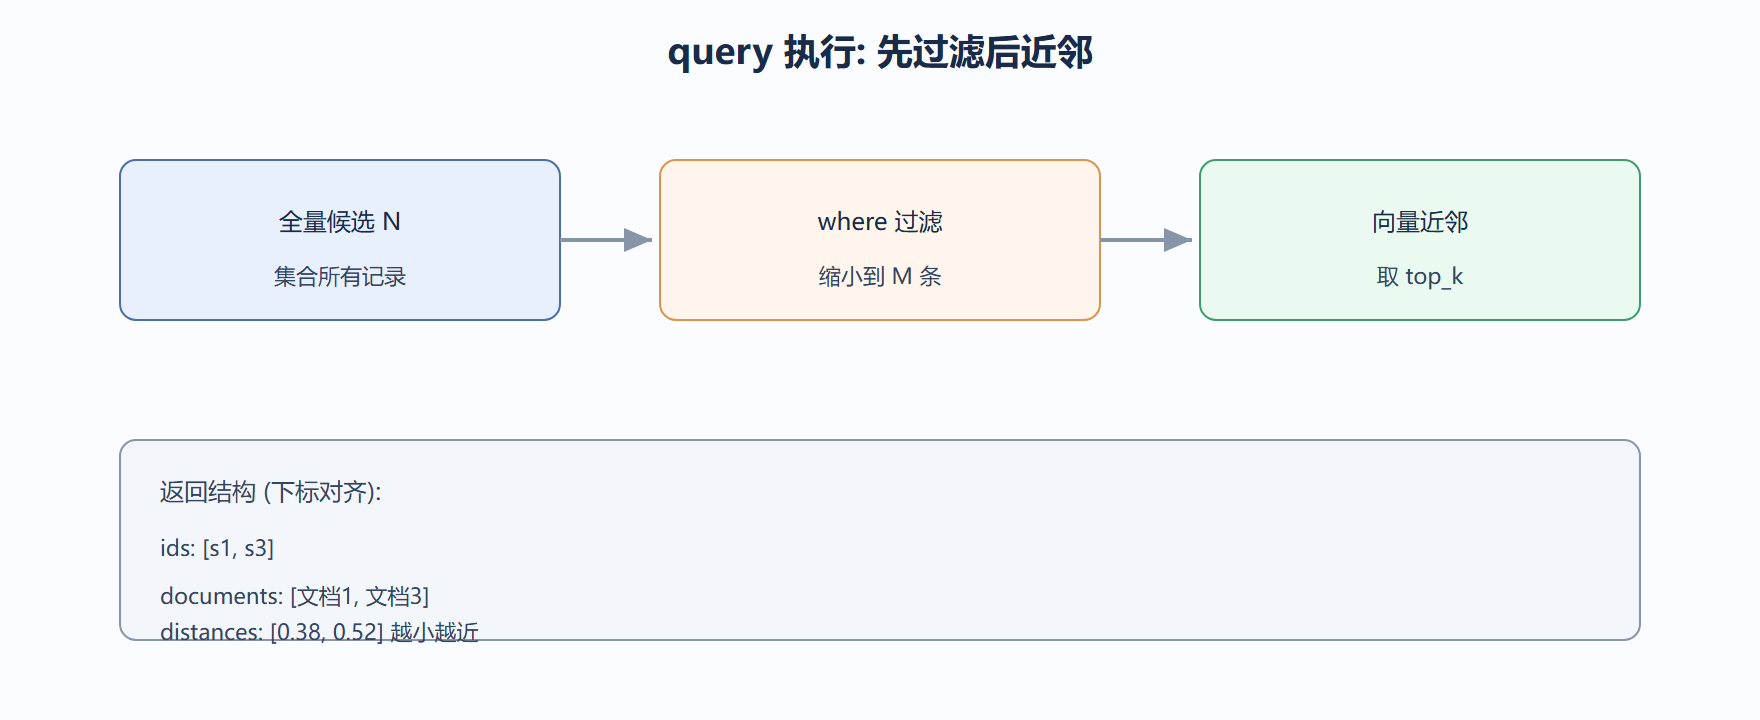
深度对照:查询是"两步走"不是"一步搜"
Chroma 的查询强大之处在于它能把"元数据过滤"和"向量检索"组合:先按 where 条件划掉不相关的,再在剩下的里面找意思最近的。这像招聘:先按学历门槛筛掉一批,再对剩下的人做能力(语义)排序,效率和质量兼得。
只做向量检索不做过滤,容易在大数据量下既慢又噪音多;只做过滤不检索,又退回了关系库的老路。两者结合才是向量库的甜区。
## 查询的两段式结构(示意) query_plan = { "where": "先按元数据划范围, 如 部门=技术", "query_texts": "再按语义找最近, 如 怎么查慢查询", "n_results": "取前 k 个候选", } print("查询顺序:", " -> ".join(query_plan.keys())) ## 查询顺序: where -> query_texts -> n_results
n_results 取多少合适
k 太小容易漏掉真相关的(只给 top1 太武断),k 太大则噪音混入、上层判断负担重。经验上问答取 3 到 5,推荐取 10 到 20。这像点菜:只点一个可能不合口味,点一桌又吃不下,适中最好。
⚠️ 常见坑:where 条件写错字段名,Chroma 不会报"字段不存在",而是返回空集,常被误判为"库里没数据"。
💡 关键直觉:过滤是"剪刀",检索是"放大镜"。先用剪刀把范围收小,放大镜才照得准。设计查询时先想清楚哪部分该剪、哪部分该照。
实践中的常见坑与关键直觉
- ⚠️ 把过滤条件写进文档正文而非元数据:导致无法走 where 快路径,退化为全量语义扫描。
- ⚠️ 期望 top1 永远正确:语义检索有容错,关键场景取 top_k 交上层或人工复核。
- 💡 复杂查询先在少量数据上验证 where 与 query 的组合效果,再上全量,避免全量跑完才发现条件错。
- 💡 把高频查询的"过滤维度"固化成元数据约定,查询代码才能稳定复用。
本节要点回顾:query 返回 ids/documents/metadatas/distances 四个对齐列表,距离越小越相关;where 在向量检索前剪枝,复合操作符丰富;过滤字段质量直接决定召回效果,是第二章 schema 设计的落地。
⚠️ 以为 where 是在向量检索后过滤是常见误解——实际先过滤再近邻,过滤字段缺失会让候选集过大拖慢查询。
💡 把 where 当业务护栏用:每次查询尽量带上能缩窄范围的元数据,相关度和速度双提升。