5.2 与主流 AI 框架的集成
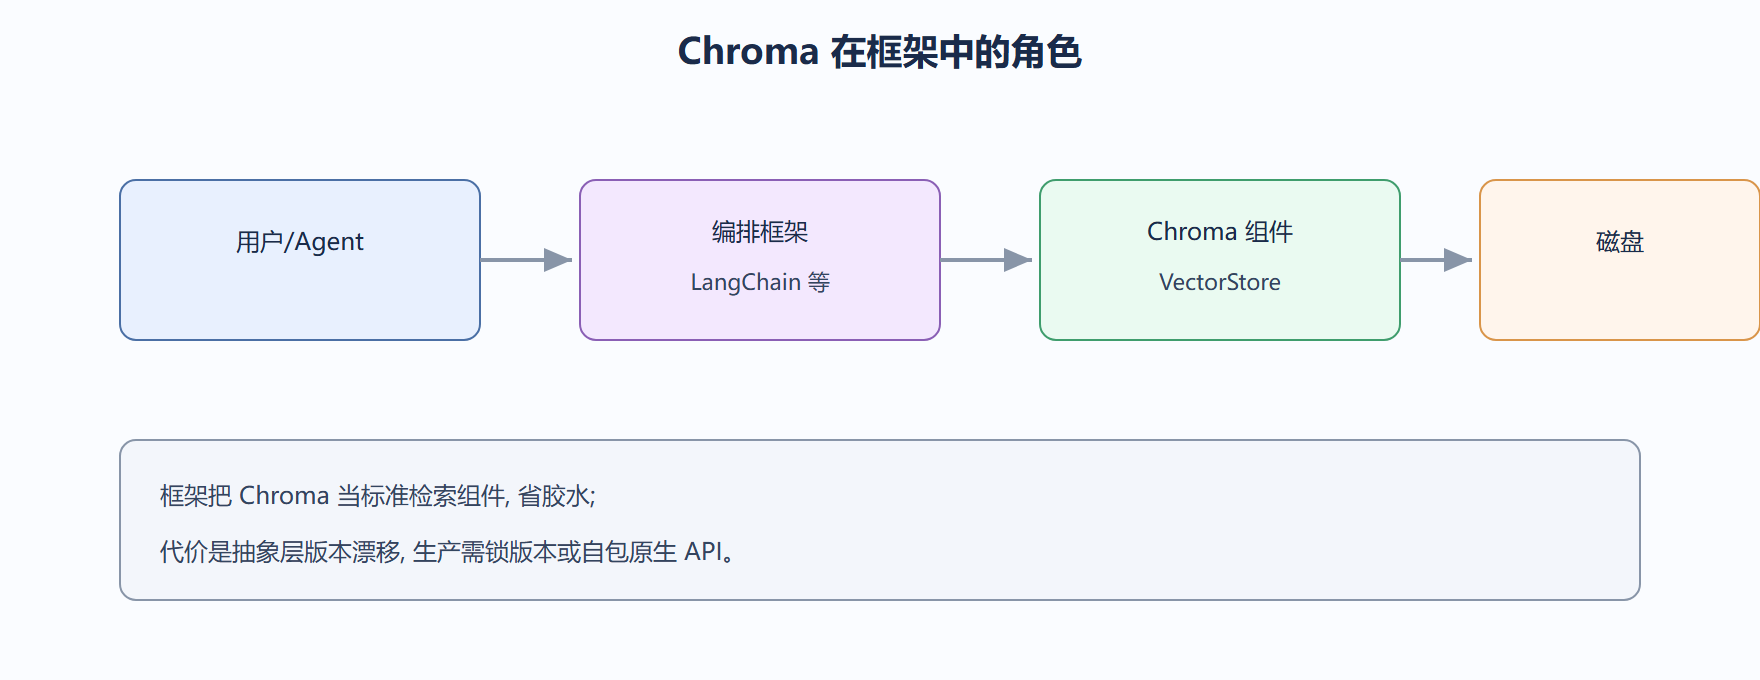
在体系位置里,这一节把 Chroma 接进 LangChain、LlamaIndex 这类编排框架。单个 Chroma 查询你已经会了,框架的价值是把它变成"链"里的一个标准组件,少写胶水代码。
直接定义
编排框架把"检索"封装成一个可插拔的 VectorStore 组件。你给框架一个 Chroma 实例,它就能在 Agent、链、索引里直接调用,不必自己拼 prompt。这是从"能查"到"能编排"的跃迁。
LangChain 里的 Chroma
## 安装: pip install langchain chromadb from langchain.vectorstores import Chroma from langchain.embeddings import SentenceTransformerEmbeddings embed = SentenceTransformerEmbeddings(model_name="all-MiniLM-L6-v2") store = Chroma(collection_name="lc_demo", embedding_function=embed) store.add_texts( ["用 HNSW 建向量索引", "余弦相似度看方向"], metadatas=[{"src": "a"}, {"src": "b"}], ) ## 直接当检索器用 retriever = store.as_retriever(search_kwargs={"k": 2}) docs = retriever.get_relevant_documents("向量检索怎么建索引") print([d.page_content for d in docs]) ## 输出: ['用 HNSW 建向量索引', '余弦相似度看方向']
注意:框架要求你显式传 embedding_function,这正好呼应第二章"锁定嵌入"的原则——框架不会替你藏这个坑。
LlamaIndex 里的 Chroma
## 安装: pip install llama-index from llama_index.vector_stores import ChromaVectorStore from llama_index import VectorStoreIndex, StorageContext import chromadb chroma_client = chromadb.PersistentClient(path="./llama_chroma") chroma_col = chroma_client.create_collection("llama_demo") vector_store = ChromaVectorStore(chroma_collection=chroma_col) storage = StorageContext.from_defaults(vector_store=vector_store) ## 之后把文档灌进 VectorStoreIndex, 检索由框架管 print("LlamaIndex 已接管 Chroma 集合:", chroma_col.name) ## 输出: LlamaIndex 已接管 Chroma 集合: llama_demo
框架带来的便利与代价
notes = { "便利": ["检索器标准化", "易接进 Agent/链", "内置文档切分器"], "代价": ["多一层抽象", "版本耦合紧", "调试要穿透框架"], } for k, v in notes.items(): print(f"{k}: {', '.join(v)}") ## 便利: 检索器标准化, 易接进 Agent/链, 内置文档切分器 ## 代价: 多一层抽象, 版本耦合紧, 调试要穿透框架
案例:框架版本错配的坑
背景:团队升级 langchain 大版本,Chroma 封装的 import 路径变了,代码整片报错。
操作:按新版本文档把 langchain.vectorstores.Chroma 改为新路径,并锁框架版本。
结果:半天内恢复,之后把框架写进 lock 文件避免再踩。
解读:框架集成的最大风险不是功能,而是"抽象层随版本漂移"。这像交通里"立交桥改道"——桥本身好用,但标线一变就容易走错。
变式:若担心框架耦合,可只用 Chroma 原生 API,自己写薄胶水层,反而更可控。
我们看框架集成的取舍
框架让你少写胶水、快搭复杂链路,代价是引入抽象层和版本脆弱性。小规模或学习期值得用;对稳定性要求极高的生产,自己包一层 Chroma 原生调用往往更稳。选型看团队对"抽象便利"和"可控性"的偏好。
深度对照:框架是"管道"不是"黑盒"
Chroma 常与多种 AI 框架配合:有的负责编排多步流程,有的负责把文档切分embed,有的负责把检索结果接进链。Chroma 在其中扮演"可检索的记忆节点",框架负责把各个节点串成流水线。这像城市供水:水库(Chroma)存水,管网(框架)把水送到各家,二者分工不重叠。
选框架时看的是"编排能力是否贴合你的流程",而不是"它宣称支持多少数据库"。只要接口能对上 Chroma 的读写,集成成本就低。
## 框架与 Chroma 的分工(非运行代码) roles = { "编排框架": "把 切分->嵌入->存入->查询->生成 串成流程", "Chroma": "只负责 存入 与 语义查询 两件事", } for k, v in roles.items(): print(f"{k}: {v}") ## 编排框架: 把 切分->嵌入->存入->查询->生成 串成流程 ## Chroma: 只负责 存入 与 语义查询 两件事
集成的"最小耦合"原则
好的集成是:框架只通过 Chroma 的客户端接口读写,不碰底层存储细节。这样 Chroma 升级、换版本,框架侧代码基本不动。这像插头标准统一:电器只认插座,不关心电厂怎么发电。
⚠️ 常见坑:在框架代码里硬编码了 Chroma 的底层文件路径或内部格式,版本一升级全断。坚持走公开接口,隔离内部变化。
💡 关键直觉:集成深度要克制。耦合越浅,两边各自演进的自由度越大,长期维护成本越低。
实践中的常见坑与关键直觉
- ⚠️ 为追新特性过度耦合某框架版本:框架一升级你的代码就废,锁定版本又错过修复,需权衡。
- ⚠️ 忽视异步与批量:高并发下同步单条读写成瓶颈,框架层应支持批量与异步。
- 💡 把 Chroma 客户端封装成独立模块,框架只调封装接口,升级或换库时改动集中在一处。
- 💡 集成后用端到端小样例验证整条流水线,别只单测 Chroma 那一段。
本节要点回顾:LangChain/LlamaIndex 把 Chroma 封装成标准 VectorStore 组件,省去胶水代码;但引入抽象层和版本脆弱性,需显式传 embedding 并锁框架版本;稳定优先时可自包原生 API。
⚠️ 框架升级后 Chroma 封装的 import 路径常变,不锁版本会让代码整片报错——框架和 chromadb 都要进 lock 文件。
💡 学习或快速原型用框架省事;生产追求可控可自包一层 Chroma 原生调用,少一层抽象少一层漂移风险。