5.3 与 Embedding 模型的集成
在体系位置里,这一节回到第二章的嵌入函数,讲它在 Chroma 里怎么落地成可替换的组件。默认模型方便,但生产几乎都要换——这一节给替换方法和注意点。
反问切入
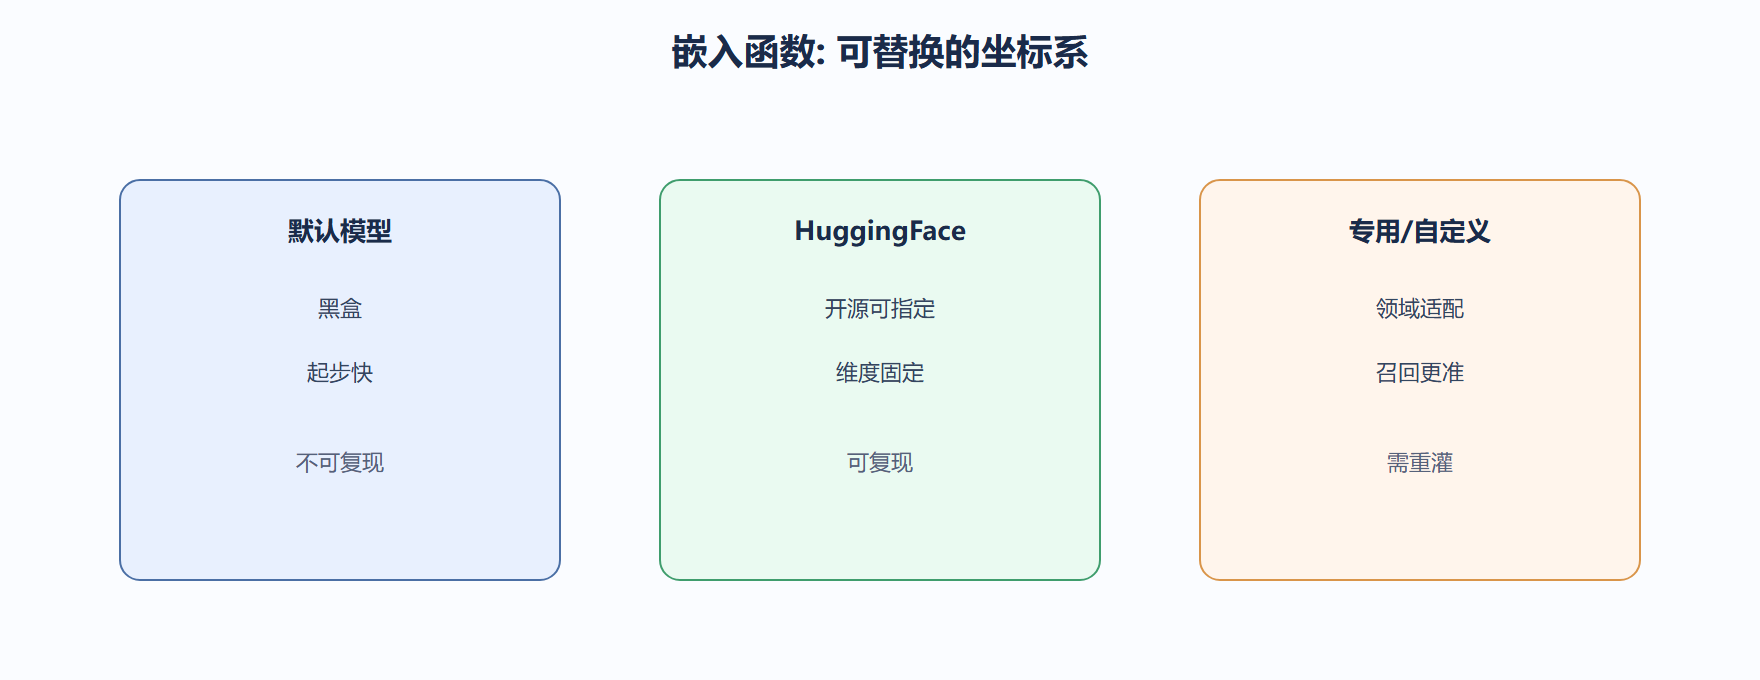
你有没有发现:Chroma 默认嵌入模型你并不知道具体是哪个、维度多少、支持哪种语言?这在原型无所谓,但生产环境"黑盒坐标"是隐患。把嵌入函数显式化,是让检索可复现的第一步。
用 HuggingFace 模型
import chromadb from chromadb.utils import embedding_functions hf_ef = embedding_functions.HuggingFaceEmbeddingFunction( model_name="sentence-transformers/all-MiniLM-L6-v2" ) col = chromadb.Client().create_collection("hf_demo", embedding_function=hf_ef) col.add(ids=["e1"], documents=["用 HNSW 做近似最近邻"]) print("该模型维度:", len(hf_ef(["测试"])[0])) ## 输出: 该模型维度: 384
指定后,所有 add/query 都走这个模型,向量空间固定,可复现。
用 OpenAI 嵌入
## 需设环境变量 OPENAI_API_KEY openai_ef = embedding_functions.OpenAIEmbeddingFunction( model_name="text-embedding-3-small" ) col2 = chromadb.Client().create_collection("oa_demo", embedding_function=openai_ef) col2.add(ids=["o1"], documents=["语义检索依赖嵌入质量"]) print("OpenAI 模型维度:", len(openai_ef(["测试"])[0])) ## 输出: OpenAI 模型维度: 1536
自定义嵌入函数
当模型不在内置列表时,实现 embed_documents 和 embed_query 两个方法即可:
from chromadb.api.types import EmbeddingFunction, Documents, Embeddings import numpy as np class MyEF(EmbeddingFunction): def __call__(self, texts: Documents) -> Embeddings: # 简化示例: 用词频向量, 实际应换真模型 return [np.random.rand(8).tolist() for _ in texts] col3 = chromadb.Client().create_collection("custom", embedding_function=MyEF()) col3.add(ids=["c1"], documents=["自定义函数示例"]) print("自定义维度:", len(col3.get(ids=["c1"])["embeddings"][0])) ## 输出: 自定义维度: 8
案例:模型切换导致旧数据失效
背景:团队先默认模型写入 10 万条,后换成业务更合的模型,新写入用新空间。
操作:老集合查询时混用两种向量,结果距离无意义,召回崩了。
结果:新建集合用新模型重灌全部数据,旧集合归档。
解读:嵌入函数是"坐标系",中途换坐标系等于把地图重画,旧坐标全错位。这像物理里"换了参考系",原来标的位置都对不上了。
变式:若必须并存,用两个集合分别存不同模型向量,查询时明确指定用哪个,绝不混。
我们怎么看嵌入集成
嵌入函数应是 Chroma 配置里最被重视的一项:它决定检索上限。内置默认适合起步,生产务必显式指定并锁定版本。多语言、领域专有(如法律、医学)场景,换专用模型往往带来肉眼可见的召回提升。
深度对照:嵌入模型是"翻译官"可替换
Chroma 自己不生产嵌入,它调用外部嵌入模型把文本变成向量。这意味着嵌入模型是可替换的部件——今天用 A,明天换 B,只要新模型产出维度匹配、语义可用,Chroma 的检索逻辑不变。这像港口的吊机:换一台不同品牌的,只要接口标准一致,装卸货物照常。
但替换不是无成本:旧 Collection 里的向量是旧模型算的,换模型后必须重新嵌入整个 Collection,否则新旧向量不可比。
## 嵌入模型切换的影响(示意) switch = { "只换模型不重嵌": "旧向量与新查询向量坐标系不同, 距离失真", "换模型并全量重嵌": "Collection 内向量统一, 检索恢复准确", } for k, v in switch.items(): print(f"{k}: {v}") ## 只换模型不重嵌: 旧向量与新查询向量坐标系不同, 距离失真 ## 换模型并全量重嵌: Collection 内向量统一, 检索恢复准确
维度匹配是硬约束
新模型的输出维度必须和 Collection 创建时定的维度一致,否则写入会报错。选模型时先确认维度,必要时为此新建 Collection。
⚠️ 常见坑:以为"换个更强的模型直接生效",却忘了旧数据还躺在旧坐标系,召回质量反而下降。换模型必走"全量重嵌"流程。
💡 关键直觉:嵌入模型是 Chroma 之外最该被认真对待的选型。它的质量直接决定"意思近"在向量里是否真的近,是检索效果的隐形天花板。
实践中的常见坑与关键直觉
- ⚠️ 不同 Collection 用不同模型却混查:跨 Collection 语义不可比,结果无意义。
- ⚠️ 不记录模型版本:半年后没人说得清某 Collection 是哪个模型嵌的,重嵌无从下手。
- 💡 把模型名与版本写进 Collection 元数据或项目配置,作为重嵌与排查的依据。
- 💡 评估新模型时,用同一批人工标注做召回对比,确认真有提升再全量切换。
本节要点回顾:Chroma 嵌入函数可替换为 HuggingFace、OpenAI 或自定义实现;生产应显式指定并锁定版本以保证向量空间可复现;中途换模型等于换坐标系,旧数据须重灌。
⚠️ 同一集合混用两种嵌入模型的向量,距离计算无意义、召回静默崩坏——换模型必须新建集合重灌。
💡 领域场景(法律、医学、多语)换专用嵌入模型常带来明显召回提升,值得作为上线前的一项必做验证。