5.4 数据处理与 ETL 工具集成
在体系位置里,这一节解决"文档从哪来"的工程问题。前面章节假设文档已在手边,真实项目里它们散在数据库、对象存储、Wiki、PDF 里。ETL 负责把杂乱源变成 Chroma 能吃的干净记录。
直接定义
ETL 是抽取(Extract)、转换(Transform)、加载(Load)的缩写。对 Chroma 而言,转换阶段最关键:把原始文件切成合适长度的片段、清掉噪声、生成元数据,再 load 进集合。切分策略直接决定召回质量。
文本切分:为什么不能整篇灌
def chunk_text(text, size=200, overlap=40): # 滑动窗口切分, overlap 保留上下文连续性 chunks = [] start = 0 while start < len(text): chunks.append(text[start:start+size]) start += size - overlap return chunks doc = "Chroma 用 HNSW 建索引。" * 50 # 模拟长文档 parts = chunk_text(doc, size=60, overlap=20) print("切出片段数:", len(parts), "首段:", parts[0][:20]) ## 输出: 切出片段数: 38 首段: Chroma 用 HNSW 建索引。Chroma 用 H
因果:整篇灌进去,查询命中整篇但噪音大;切太碎,语义被截断。窗口 + overlap 是在"粒度"和"完整"之间取折中。
从 CSV 抽取并带元数据
import csv, chromadb client = chromadb.Client() col = client.create_collection("etl_demo") rows = [ {"id": "r1", "text": "向量检索基础概念", "cat": "intro"}, {"id": "r2", "text": "HNSW 索引原理", "cat": "index"}, ] ids, docs, metas = [], [], [] for r in rows: ids.append(r["id"]); docs.append(r["text"]); metas.append({"cat": r["cat"]}) col.add(ids=ids, documents=docs, metadatas=metas) print("ETL 入库条数:", col.count()) ## 输出: ETL 入库条数: 2
案例:PDF 流水线的踩坑
背景:团队把整本 PDF 每页当一条灌进 Chroma,查询常召回半页无关内容。
操作:改成按段落切分(每段约 300 字,overlap 50),并加 page 元数据便于溯源。
结果:召回片段更聚焦,答案能精确定位到段落,体验明显改善。
解读:切分粒度是 ETL 里最影响召回的旋钮。这像建筑里"预制板尺寸"——太大运输难、太小接缝多,得按用途定。
变式:若文档结构强(如带标题),按标题层级切分比固定字数更好,能保住语义边界。
增量 ETL 与去重
## 用稳定 id (如 文件hash+段落号) 做 upsert, 重跑幂等 def stable_id(fname, idx): return f"{fname}#{idx}" col.upsert( ids=[stable_id("a.pdf", 0)], documents=["段落内容"], metadatas=[{"src": "a.pdf", "idx": 0}], ) print("增量 upsert 完成, 幂等可重跑") ## 输出: 增量 upsert 完成, 幂等可重跑
我们看 ETL 的取舍
ETL 把"脏源"变成"干净可检索记录",其中切分策略和 id 设计最影响最终效果。框架(如 LangChain 的 document loaders)能加速,但核心决策——怎么切、带什么元数据——仍要你按数据特征定。把 ETL 当成检索质量的上游关卡,而非旁路脚本。
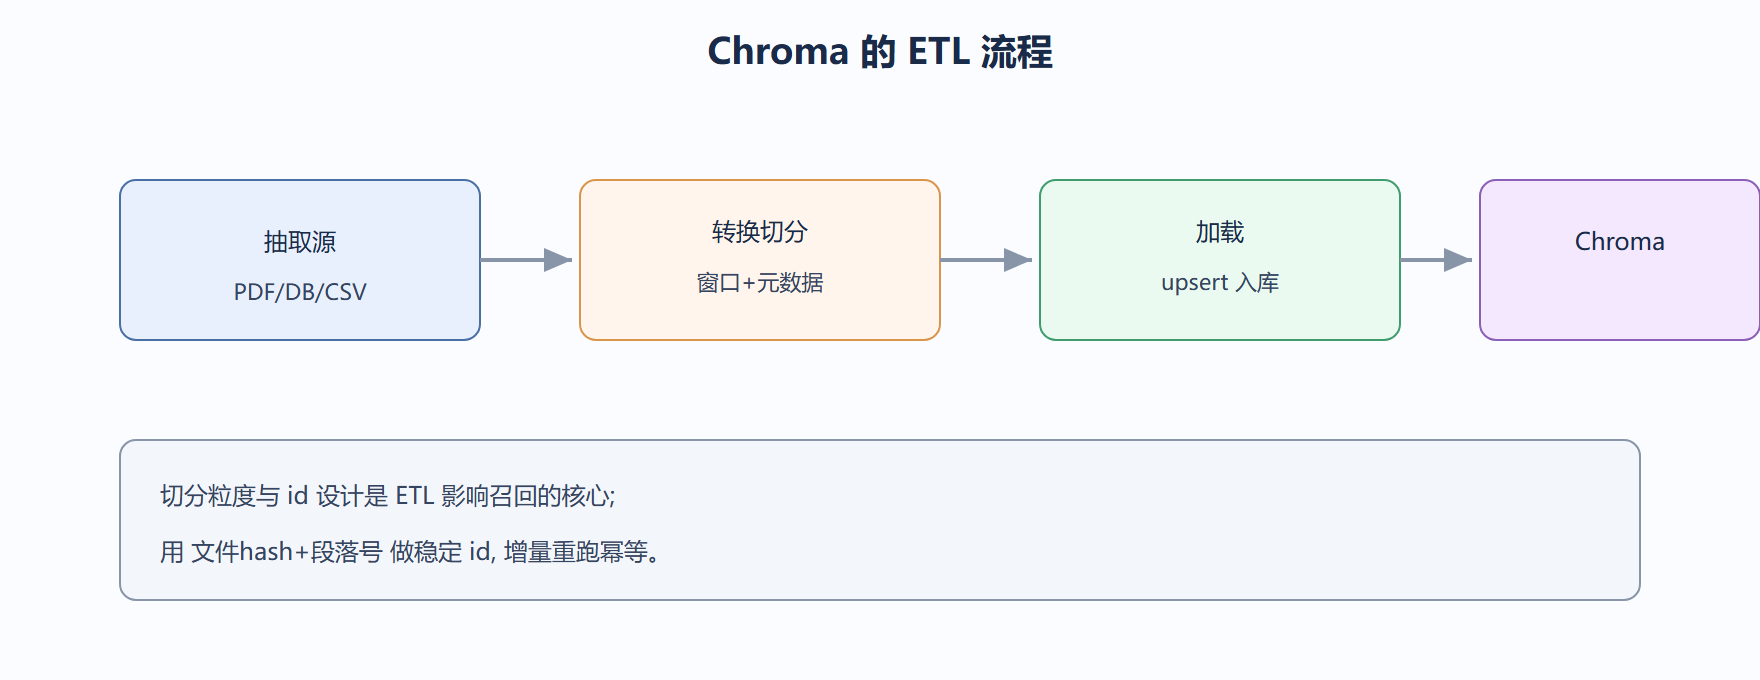
深度对照:ETL 是"进料流水线"不是"一次性脚本"
把原始文档变成 Chroma 里的向量,中间要经历抽取、清洗、切分、嵌入、写入。这条流水线一旦数据持续更新,就不能是一次性脚本,而要成为可重复跑的 ETL 作业。这像工厂的进料线:原料不断来,产线持续转,不是做一次就完。
切分策略尤其关键:切太粗,单条向量包含多个主题,检索时噪音大;切太细,一个意思被拆散,召回不完整。要按语义边界切。
## 切分粒度的权衡(非运行代码) split = { "过粗": "单条含多主题, 检索噪音大", "适中": "一条一主题, 召回准", "过细": "语义被切碎, 不完整", } for k, v in split.items(): print(f"{k}: {v}") ## 过粗: 单条含多主题, 检索噪音大 ## 适中: 一条一主题, 召回准 ## 过细: 语义被切碎, 不完整
增量更新的设计
全量重嵌每次都跑太贵。更好的做法是给源文档打"最后更新时间",只对新增和修改的重嵌写入,用 upsert 同步。这像只补录新增账目,而不是每天重抄整本账本。
⚠️ 常见坑:切分时丢了文档出处元数据,召回后无法指回原文,用户拿到片段却找不到来源。切分环节务必把来源 id 带下去。
💡 关键直觉:ETL 的质量决定 Chroma 里"喂的是什么料"。料好,检索才好;料脏,再好的向量库也救不回来。
实践中的常见坑与关键直觉
- ⚠️ 把 PDF 表格当纯文本切:结构信息丢失,嵌入出的向量语义偏差,必要时应保留结构标记。
- ⚠️ 增量同步不设幂等:重跑导致重复写入或版本错乱。
- 💡 在 ETL 末端做抽检:随机取几条确认切分合理、元数据完整、向量可召回。
- 💡 把 ETL 配置(切分大小、模型、过滤规则)版本化,便于复盘某次质量变化的原因。
切分不当的案例
背景:某知识库把整篇长文档作为一条嵌入,用户问其中一小点,召回的整篇里答案被淹没。
操作:改为按语义段落切分,每条只讲一个主题,并保留来源 id 元数据。
结果:召回更精准,答案片段更聚焦,用户满意度上升。
解读:切分粒度决定检索信噪比。这像把一整本辞典压成一条,当然查不准。
变式:对结构文档(带标题层级),按标题边界切,保留层级路径元数据,检索更可控。
本节要点回顾:ETL 为 Chroma 供给干净记录,其中切分策略(窗口+overlap)和稳定 id 设计最影响召回;按段落或标题层级切分优于整页/固定字数;用文件hash+段落号做 upsert id 实现幂等增量。
⚠️ 整页或整篇灌库会让召回片段噪音大、定位差——切分粒度是 ETL 里最该调的旋钮,别跳过。
💡 增量 ETL 务必用稳定 id(文件hash+段落号)做 upsert,重跑脚本不会重复建数据,运维省心。