6.1 部署模式选择
在体系位置里,这一节是第六章的入口:从"能跑"到"跑在哪"。Chroma 有嵌入式和服务端两种形态,选错会让后续运维处处别扭。我们从故障域的角度来想这件事。
反问切入
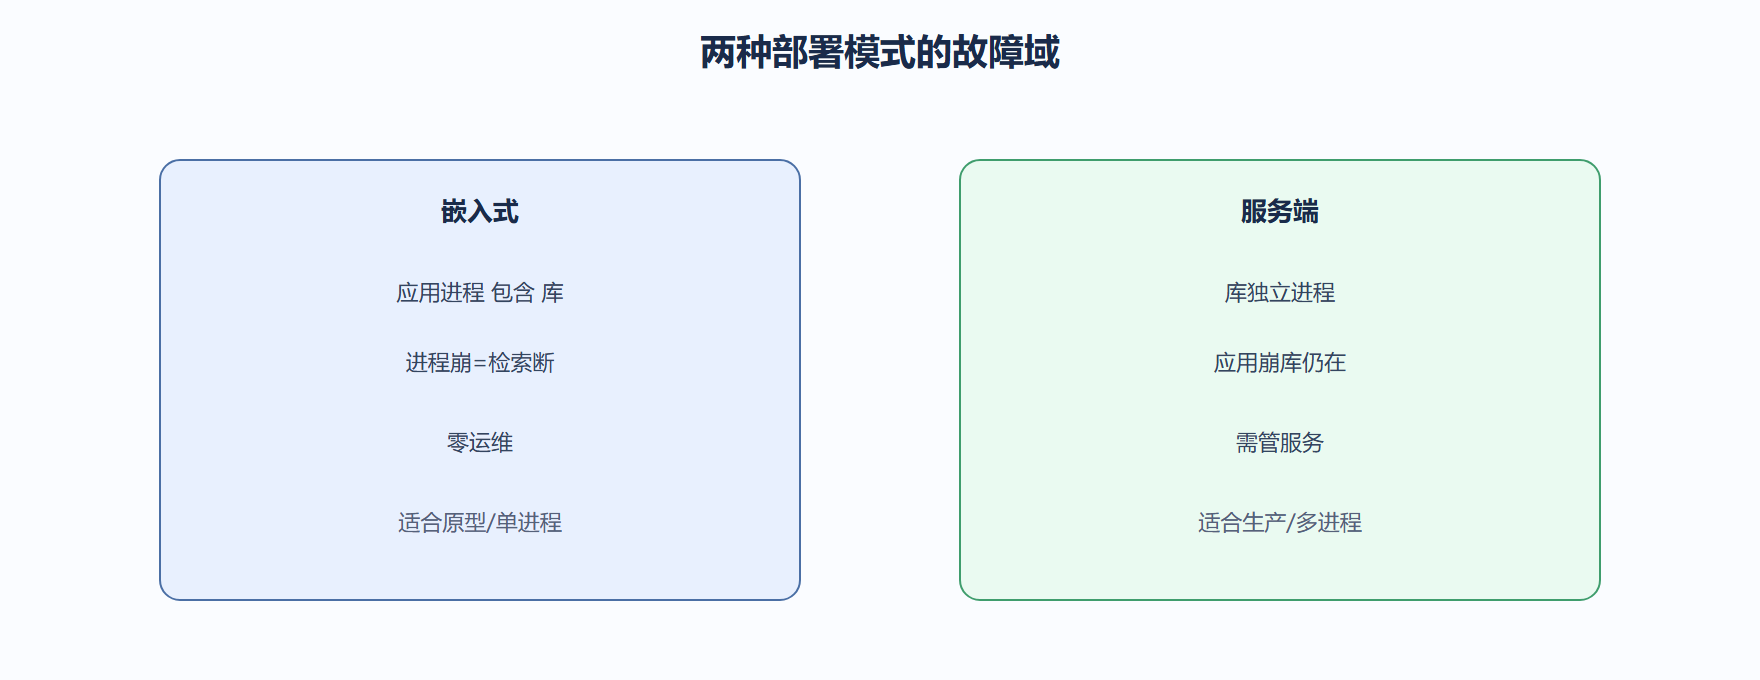
如果你的 Chroma 跟着某个 Python 进程一起死,那这个进程的崩溃会不会带走整个检索服务?嵌入式模式下答案是"会"。服务端模式把库独立成进程,应用崩了库还在。这个区别,决定了你该选哪种。
嵌入式:库在应用进程内
## 应用进程内直接起库, 无独立服务 import chromadb client = chromadb.PersistentClient(path="./app_chroma") col = client.create_collection("embedded") col.add(ids=["x"], documents=["嵌入式模式"]) ## 进程退出, 库随进程消失(但磁盘文件保留, 重连可恢复) print("嵌入式: 库与应用同生共死(进程级)") ## 输出: 嵌入式: 库与应用同生共死(进程级)
适用:单机原型、CLI 工具、函数计算里的一次性检索。故障域 = 整个应用进程。
服务端:库是独立进程
## 先另起: chroma run --path ./server_chroma --port 8000 import chromadb client = chromadb.HttpClient(host="localhost", port=8000) col = client.get_or_create_collection("server_mode") col.add(ids=["y"], documents=["服务端模式"]) ## 应用进程崩了, chroma server 仍活着, 其他客户端可继续用 print("服务端: 库独立, 应用崩不影响检索") ## 输出: 服务端: 库独立, 应用崩不影响检索
适用:多进程/多实例共享同一库、需要并发、要独立扩缩容。故障域被切开。
决策对照
decision = { "嵌入式": ["规模小", "单进程", "原型/CLI", "零运维"], "服务端": ["多进程共享", "并发读写", "生产常驻", "需管服务"], } for k, v in decision.items(): print(f"{k}: {', '.join(v)}") ## 嵌入式: 规模小, 单进程, 原型/CLI, 零运维 ## 服务端: 多进程共享, 并发读写, 生产常驻, 需管服务
案例:从嵌入式翻车到服务端
背景:某团队把 Chroma 嵌在 Web 服务里,流量上来后多个 worker 各自开库,磁盘文件互相锁。
操作:改为独立 chroma server,所有 worker 通过 HttpClient 连同一个库。
结果:文件锁冲突消失,查询稳定,扩 worker 不再影响库。
解读:嵌入式在"多进程抢同一目录"时会撞锁——这是它的天然边界。这像建筑里"一户一表"和"楼栋总表":总表被多户同时拉闸就会乱。
变式:若坚持嵌入式又要多进程,可让唯一一个专进程持库,其余通过内部 RPC 问它,但那基本已在造简易服务端。
我们看部署的取舍
嵌入式把"数据库"降为"库调用",认知和运维成本最低,代价是故障域与应用绑死、并发受限。服务端把管理外包出去,换来隔离与扩展,代价是多一处要监控的进程。选型看"是否多进程共享"和"能否接受多运维一个服务"。
深度对照:部署模式是"户型"不是"版本号"
Chroma 的部署可分为嵌入式(进程内)、独立服务、以及托管几种形态。选哪种取决于你的"户型"需求:一个人住(单机原型)选嵌入式最省心,一大家子(多服务共享)得上独立服务。这像买房:单身公寓和别墅都满足"住",但水电、物业、维护完全不同。
嵌入式零运维但受单机限制;独立服务能多进程共享、便于集中运维,但要管进程与资源;托管则把运维彻底外包,代价是数据与配置出了你的直接控制。
## 三种部署形态对照(非运行代码) deploy = { "嵌入式": {"运维": "零", "共享": "否", "适合": "原型/单机Agent"}, "独立服务": {"运维": "中", "共享": "是", "适合": "多服务共用"}, "托管": {"运维": "低", "共享": "是", "适合": "不想管基础设施"}, } for k, v in deploy.items(): print(f"{k}: 运维={v['运维']} 适合={v['适合']}") ## 嵌入式: 运维=零 适合=原型/单机Agent ## 独立服务: 运维=中 适合=多服务共用 ## 托管: 运维=低 适合=不想管基础设施
怎么判断该升级形态
当你出现"多个进程要读同一份向量""单机内存扛不住""需要统一备份策略"中任一信号,就该从嵌入式走向独立服务。这像家里人多了,从一口锅做饭变成开放式厨房加专人——不是更贵,是规模逼的。
⚠️ 常见坑:原型期用嵌入式跑通,上线直接照搬却不改部署,结果多实例各写各的目录,数据分裂成几份。上线前重新评估部署形态。
💡 关键直觉:部署形态要随规模演进,不要一次定死,也不要永远不变。每个阶段选"刚好够"的形态,性价比最高。
实践中的常见坑与关键直觉
- ⚠️ 把嵌入式当生产共享后端:多进程并发写同一目录有损坏风险,独立服务才是正解。
- ⚠️ 托管后忽视数据主权:敏感资料上托管前确认合规与导出路径,别被锁定。
- 💡 用"信号清单"决定升级时机,出现信号再动,避免过早复杂化。
- 💡 任何形态都把"备份与恢复"先演练通,再谈性能,数据丢了性能毫无意义。
一个形态选错的案例
背景:团队原型用嵌入式,上线直接照搬,三个服务各自写本地目录。
操作:没意识到多实例需要共享存储,数据裂成三份。
结果:改成独立服务形态,统一读写一份数据,一致性恢复。
解读:形态要随规模演进,原型省心不等于生产够用。这像单人帐篷带去露营团,挤不下。
变式:若未来要跨机房,再评估托管或分布式,每一步按信号升级即可。
一个边界提醒
选形态别追"最高级"。托管看似省心,却把数据主权交出去;嵌入式看似简陋,却给你完全控制。按"你对数据控制的诉求强度"倒推形态,而非按别人用啥你用啥。这像出行:不是豪车就好,近处骑车比开车还顺。
本节要点回顾:Chroma 有嵌入式(库在应用进程内,故障域绑定,零运维)和服务端(库独立进程,故障隔离,需管服务)两种;多进程抢同一目录会撞文件锁,是嵌入式的天然边界;选型看是否多进程共享与能否接受额外运维。
⚠️ 多个 worker 各自用嵌入式连同一目录会撞文件锁——这是常见生产翻车,出现即说明该切服务端。
💡 原型期用嵌入式求快,一旦有多个进程要共享同一库,尽早切服务端,别用"内部 RPC 绕行"造半成品服务端。