6.2 生产环境部署策略
在体系位置里,这一节承接 6.1 选定服务端模式后,具体怎么把它跑稳:进程管理、资源预估、备份。我们给的是"避坑清单"而非标准答案,因为每家的规模不同。
直接定义
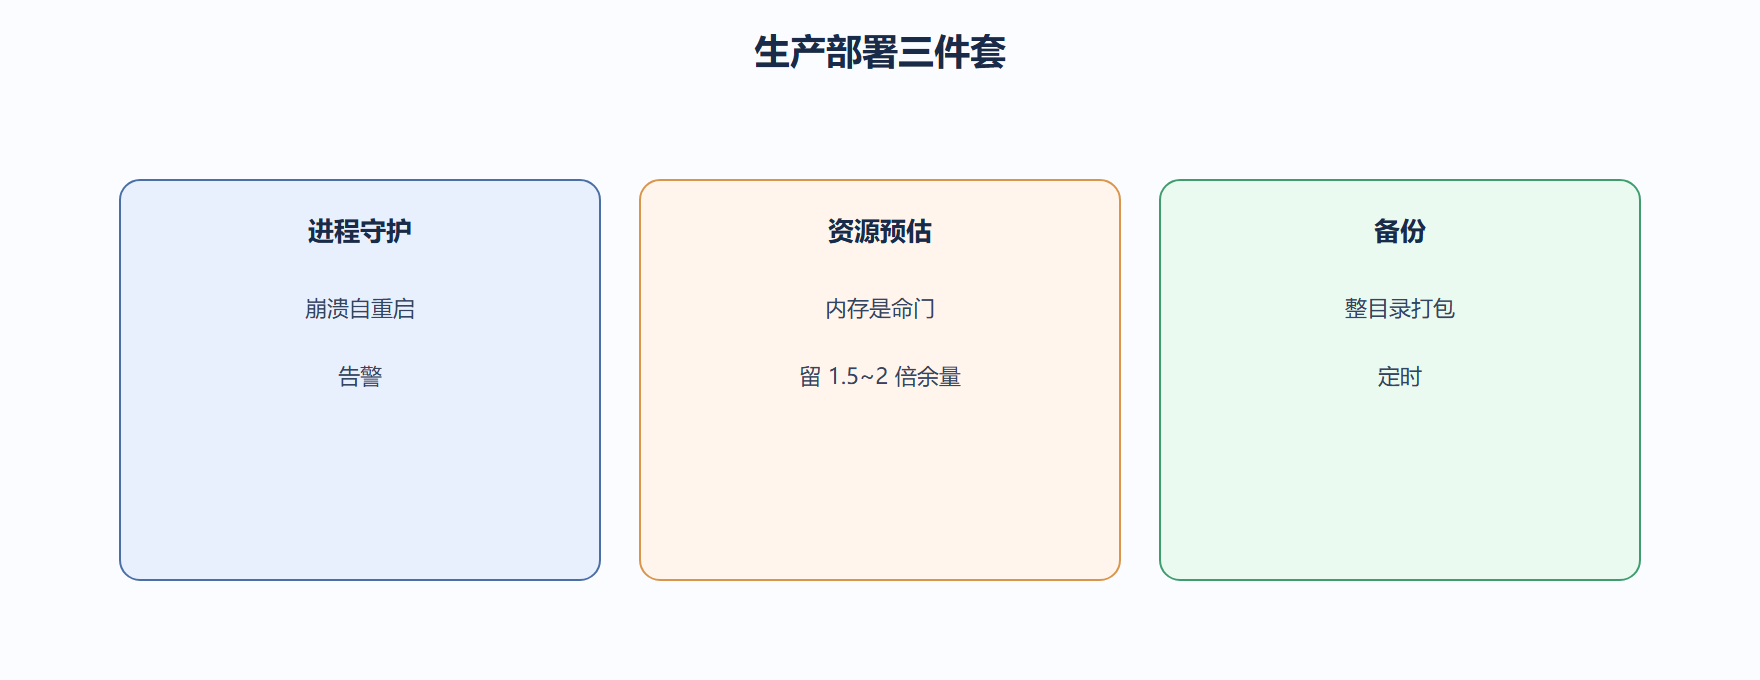
生产部署 = 让 chroma server 作为常驻服务稳定运行,能被监控、能重启恢复、数据不丢。它由三部分组成:进程守护(别让它悄无声息挂掉)、资源上限(内存是 HNSW 的生命线)、备份(目录即库,整目录备)。
进程守护示例
## 用进程管理器拉起, 崩溃自动重启 (示意, 非运行代码) ## chroma run --path /data/chroma --port 8000 ## 配合 supervisor/systemd 设 Restart=always echo "守护要点: 退出码非0即重启, 并上报告警" ## 输出: 守护要点: 退出码非0即重启, 并上报告警
注意:chroma server 是常驻进程,必须有守护。裸跑在终端,终端一关服务就没。
资源预估:内存是命门
HNSW 图常驻内存,内存不足会频繁换页、查询骤慢。一个粗略估算:
## 估算常驻内存: 向量数 × 维度 × 4字节 × (1 + M/2 的图开销系数) def est_mem(n, dim, M=16): vec_bytes = n * dim * 4 graph_factor = 1 + M / 2 return vec_bytes * graph_factor print("100万条×384维 估算内存(GB):", round(est_mem(1_000_000, 384) / 1e9, 2)) ## 输出: 100万条×384维 估算内存(GB): 约 2.3 GB (含图开销)
这个数字是"至少",实际还要加元数据与并发缓冲。给机器留 1.5~2 倍余量,别卡着边上跑。
备份策略
## 目录即库, 整目录定时打包 import shutil, os, time src = "/data/chroma" dst = f"/backup/chroma_{int(time.time())}.zip" if os.path.exists(src): shutil.make_archive(dst.replace(".zip", ""), "zip", src) print("备份完成:", dst) ## 输出: 备份完成: /backup/chroma_xxxx.zip
案例:内存打满导致查询雪崩
背景:某服务集合涨到 500 万条,机器 8G 内存,图占满后开始换页。
操作:监控发现查询 P99 从 30ms 飙到 2s,加内存到 16G 并限制集合规模。
结果:P99 回到 40ms,加了内存告警阈值防再犯。
解读:HNSW 是"内存换速度",内存不够就反向惩罚。这像交通里"快速路车流超容量就变停车场"。
变式:若无法加内存,按业务分多个集合或降维度,把单库向量量压进内存。
我们看生产部署的取舍
服务端模式把"库"变成"服务",你就要承担服务的全部功课:守护、资源、备份、监控。这些不性感,但决定了半夜会不会被叫醒。把"目录即库"记牢,备份和迁移都简单;把"内存是命门"记牢,容量规划不翻车。
深度对照:生产部署是"守规矩"不是"能跑就行"
能跑通的脚本和能扛生产的部署之间,差的是一堆工程纪律:资源上限、健康检查、优雅重启、监控告警。这像马路能走和高速公路能通车:后者要标线、护栏、收费站、救援,缺一样就隐患不断。
生产环境里,Chroma 作为独立服务运行时,要关心内存上限(向量常驻内存)、磁盘空间(持久化文件增长)、以及并发读写时的稳定性。
## 生产部署要盯的指标(非运行代码) metrics_watch = ["内存占用(向量常驻)", "磁盘剩余(持久化增长)", "查询P95延迟", "写入队列长度"] print("上线前需有监控:", metrics_watch) ## 上线前需有监控: ['内存占用(向量常驻)', '磁盘剩余(持久化增长)', '查询P95延迟', '写入队列长度']
资源规划的本质
向量库的内存账单 = 向量条数 × 维度 × 单值字节数。上线前先按业务峰值估算这个账,留一倍余量。这像剧院按高峰观众数排座位,按平日排会爆满,按极端排又浪费,取峰值加冗余最稳。
⚠️ 常见坑:按测试期数据量规划资源,上线后业务增长,内存触顶被 OOM 杀掉,服务间歇性挂。用峰值而非均值做规划。
💡 关键直觉:生产部署的第一目标是"稳",第二才是"快"。先把不挂、可恢复、可观测做到位,再谈调优。
实践中的常见坑与关键直觉
- ⚠️ 无健康检查就接流量:实例还没就绪就被打挂,应配就绪探针再放流量。
- ⚠️ 不限制写入速率:突发大批量导入挤垮查询,读写应做限速与错峰。
- 💡 把"重启恢复"写成自动化,进程挂了能自愈,人不用半夜爬起来。
- 💡 变更走灰度:先一小部分流量验证新部署,确认稳再全量。
一次内存撑爆的案例
背景:按测试期数据量规划内存,上线后业务增长,向量常驻内存触顶被 OOM。
操作:没留余量,也未设监控,半夜实例反复挂。
结果:按峰值重新规划资源并加监控告警,恢复稳定。
解读:生产规划看峰值而非均值,且监控要先于故障。这像按春运排运力,平日够用会爆。
变式:若峰值波动大,用弹性资源 + 查询限速,平滑突发,避免硬扛。
一个灰度发布的小案例
背景:某次部署直接全量切换,新版本有个慢查询没暴露,全量后整体变慢。
操作:没有灰度,流量一步切过去,问题瞬间放大。
结果:改为先放一成流量观察指标,发现 P95 异常立即回滚,影响面极小。
解读:生产部署的核心是"可控",灰度让错误代价封顶。这像新药先小范围临床试验再推广。
变式:配合自动回滚——指标超阈值自动切回旧版,人不必守着,事故自愈。
监控要先于故障
很多团队等用户投诉才发现挂了,被动且丢脸。正确做法是上线前就把关键指标(内存、磁盘、延迟、队列)接好告警。告警是"故障的探照灯",不是装饰。这像飞机仪表盘:飞着飞着油压掉,灯先亮你才来得及处置。
⚠️ 常见坑:告警配了却没人看、或阈值设太松永远不响,等于没配。告警要可行动、有人响应。
💡 关键直觉:生产环境的第一指标是"可恢复"而非"高性能"。先保证挂了能起来、数据不丢、问题看得见,再在稳定基线上追求速度,顺序不能反。
本节要点回顾:生产部署三件套——进程守护(崩溃自重启+告警)、资源预估(HNSW 常驻内存,留 1.5~2 倍余量)、整目录定时备份;内存不足会让查询雪崩,容量规划是重点。
⚠️ 裸跑 chroma server 在终端,终端关闭服务即停——必须有守护进程,否则生产环境随时无声中断。
💡 容量规划先按"向量数×维度×4字节×(1+M/2)"估内存,再乘余量;内存不够别硬扛,分集合或降维比换页强。