6.4 数据管理与维护
在体系位置里,这一节是第六章的收尾,也是库"长期活着"要做的功课:日常变更怎么安全做、数据怎么校验、出问题怎么回退。部署跑起来只是开始,维护决定它能稳多久。
场景代入
库上线三个月,业务方说"把过期的促销文档下掉""有批数据算错了要重算"。这些日常变更如果裸操作,容易误删、容易不一致。维护要的是"可控的变更",而不是"能改"。
安全删除:先查后删
import chromadb c = chromadb.Client() col = c.get_collection("maint") ## 先确认要删的范围 to_del = col.get(where={"status": "expired"}, limit=100) print("将要删除:", len(to_del["ids"]), "条") ## 确认无误再执行 col.delete(where={"status": "expired"}) print("删除后条数:", col.count()) ## 输出: 将要删除: N 条 / 删除后条数: ...
先 get 看范围再 delete,避免 where 写错一键清错数据。这是金融里"先对账再划款"的同理心。
批量重算:用 upsert 覆盖
## 某批向量算错了, 重新生成后 upsert 覆盖, 不丢其他字段 bad_ids = ["b1", "b2"] new_embeddings = [[0.1, 0.2, 0.3], [0.4, 0.5, 0.6]] col.upsert(ids=bad_ids, embeddings=new_embeddings, documents=["新文本1", "新文本2"]) print("重算覆盖完成, 条数不变:", col.count()) ## 输出: 重算覆盖完成, 条数不变: ...
数据校验:定期核对计数与样本
## 简单健康检查脚本(可定时跑) def health(col): n = col.count() sample = col.get(limit=1, include=["embeddings"]) has_vec = sample["embeddings"] is not None and len(sample["embeddings"][0]) > 0 return n > 0 and has_vec print("集合健康:", health(col)) ## 输出: 集合健康: True
案例:误删后的回退
背景:运维手滑 delete(where={"type":"all"}) 多打了个条件,清掉一半数据。
操作:因有整目录备份,从最近备份恢复该集合目录,丢失仅最近一小时增量。
结果:服务半小时内恢复,增量靠操作日志补回。
解读:回退能力来自"平时有备份 + 变更前先查"。这像生物里的"备份基因"——出错能靠副本重生。
变式:若没备份只有 binlog 类增量,可重放删除时间点之后的写入,但成本高,不如整目录备份省事。
维护清单
checklist = [ "变更前先 get 确认范围, 不裸 delete", "重算用 upsert 幂等覆盖", "定时整目录备份 + 保留多版本", "定期跑健康检查(计数/向量非空)", "嵌入模型版本变更要记档, 旧集合勿混新向量", ] for i, x in enumerate(checklist, 1): print(f"{i}. {x}") ## 1. 变更前先 get 确认范围, 不裸 delete ## 2. 重算用 upsert 幂等覆盖 ## 3. 定时整目录备份 + 保留多版本 ## 4. 定期跑健康检查(计数/向量非空) ## 5. 嵌入模型版本变更要记档, 旧集合勿混新向量
我们看维护的取舍
维护的代价是"每次变更多几步确认",收益是"不出事故"。Chroma 本身不提供事务和回收站,这些安全感要靠你的流程补。把"先查后删、整目录备、定期校验"养成肌肉记忆,比任何高级功能都保值。
深度对照:数据维护是"养"不是"存"
数据进库不是终点,持续的维护才决定它长期可用:过期记录要清、模型升级要重嵌、备份要定期、增长要监控。这像养鱼:放水里不是完事,换水、控温、喂食少一样鱼就翻肚。
维护动作包括:按元数据批量下架失效文档、定期统计 Collection 规模防膨胀、对换模型做全量重嵌、把备份纳入排期。
## 维护动作清单(非运行代码) maintain = ["过期记录按元数据下架", "规模监控防膨胀", "换模型全量重嵌", "定期备份"] print("周期维护:", maintain) ## 周期维护: ['过期记录按元数据下架', '规模监控防膨胀', '换模型全量重嵌', '定期备份']
重嵌的节奏
模型升级不必频繁,但一旦发生,就要规划全量重嵌窗口:先建新 Collection 重嵌,验证召回后再切换,旧的可保留回退。这像系统升级:蓝绿部署,新环境验证过再切,出问题秒回旧版。
⚠️ 常见坑:维护靠"想起才做",某天发现磁盘满了、或某来源文档早该下架却还在干扰召回。维护写成定时任务,比靠人记可靠。
💡 关键直觉:数据会"过期"和"腐化",不维护的向量库会随时间悄悄变差。把维护当常规动作,检索质量才稳。
实践中的常见坑与关键直觉
- ⚠️ 只增不删:数据只进不出,旧噪音持续拉低召回,规模还撑爆磁盘。
- ⚠️ 重嵌期间新旧混用:没隔离好,查询同时命中两套向量,结果混乱。
- 💡 给维护动作配告警:规模超阈值、备份失败主动通知,别等出事才发现。
- 💡 维护脚本也版本化,和主代码一起评审,避免"只有某人会跑"的黑盒。
一次"只增不删"的案例
背景:某库半年只写不删,过期文档持续干扰召回,磁盘也快满。
操作:没把维护写成定时任务,靠人记总忘。
结果:建立按元数据下架的定时任务,并接入规模告警,质量回稳。
解读:数据会腐化,维护是常态不是偶发。这像鱼缸不换水必臭。
变式:重嵌大版本前先建新 Collection 验证,确认召回再切,旧库留作回退。
一个边界提醒
维护频率随数据活跃度定:静态知识库月度维护即可,高频流水库要日级甚至实时清理。别套用单一节奏,按"腐败速度"配维护密度,才不浪费也不失控。这像不同鱼缸换水频率不同,看养什么。
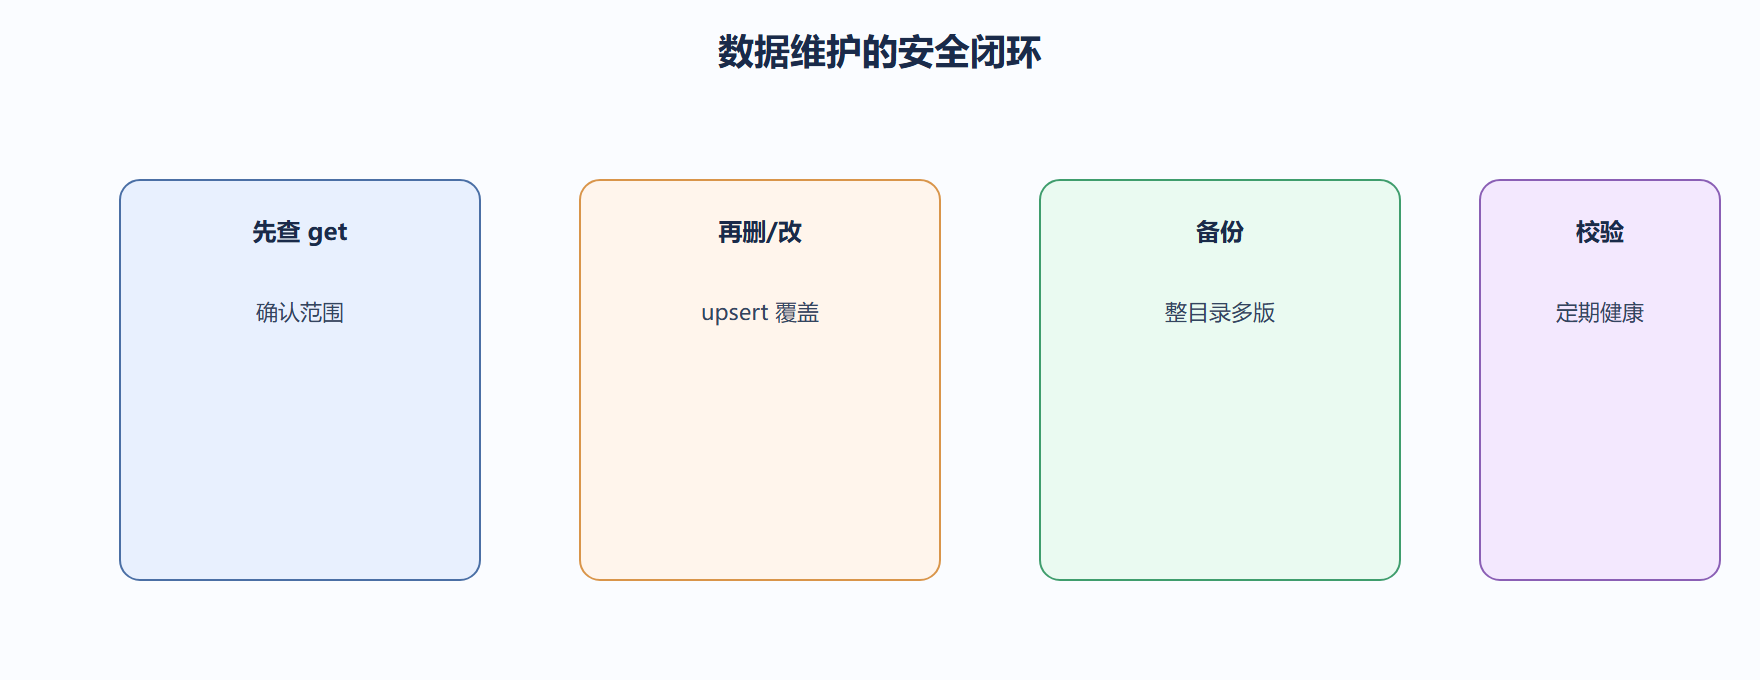
本节要点回顾:维护安全闭环——变更前先 get 确认范围再删、重算用 upsert 幂等覆盖、整目录多版本备份、定期健康检查(计数+向量非空);Chroma 无事务无回收站,安全感靠流程补。
⚠️ 直接裸 delete(where=...) 不先确认范围,一旦条件写错会一键清错数据且难恢复——先查后删是铁律。
💡 维护的"多几步确认"代价极小,却能避开绝大多数事故;把先查后删、整目录备、定期校验养成习惯最保值。