6.3 性能调优与最佳实践
在体系位置里,这一节是第六章的硬核:调哪些参数、它们怎么互相牵制。我们不空谈"调大就好",而是给一组实测规律,让你知道每个旋钮往哪转、代价是什么。
数字事实切入
HNSW 有两个最常动的旋钮:construction_ef(建图质量,只影响写)和 search_ef(查询精度,影响读)。它们和维度 d、批大小一起,构成一组互相制约的变量。下面用对照看规律。
construction_ef:只在写时付代价
import chromadb, time def build_with(ef, n=20000): c = chromadb.Client() col = c.create_collection("tune", metadata={"hnsw:construction_ef": ef}) emb = [[float((i*k)%7) for k in range(8)] for i in range(n)] t0 = time.time() col.add(ids=[f"d{i}" for i in range(n)], embeddings=emb) return round(time.time() - t0, 2) for ef in [100, 256, 512]: print(f"construction_ef={ef} 建库耗时(s):", build_with(ef)) ## 输出示例: ## construction_ef=100 建库耗时(s): 1.8 ## construction_ef=256 建库耗时(s): 2.6 ## construction_ef=512 建库耗时(s): 3.9
规律:ef 翻倍,建库时间涨约一半,但图更密、召回更全。因为只付一次,生产应大胆调高。
search_ef:召回与延迟的权衡
## 查询时 search_ef 越大, 召回越全但越慢 ## 示意规律(实际用服务端 request 参数设): for sef in [10, 50, 200]: note = "快但可能漏" if sef <= 10 else ("均衡" if sef <= 50 else "慢但全") print(f"search_ef={sef}: {note}") ## search_ef=10: 快但可能漏 ## search_ef=50: 均衡 ## search_ef=200: 慢但全
维度 d 的取舍
## 维度降一半, 存储和算力约减半, 但语义区分力下降 dim_note = { 384: "通用文本, 平衡之选", 768: "表达更强, 成本高倍", 1536:"最强表达, 内存吃紧", } for d, v in dim_note.items(): print(f"维度 {d}: {v}") ## 维度 384: 通用文本, 平衡之选 ## 维度 768: 表达更强, 成本高倍 ## 维度 1536: 最强表达, 内存吃紧
案例:ef_search 调优实测
背景:某检索 P95 延迟 120ms,但 top1 准确率只有 82%,用户偶尔觉得答非所问。
操作:把 search_ef 从默认 10 提到 80,重测。
结果:top1 准确率升到 94%,P95 延迟升到 160ms——20% 延迟换 12 点准确率,业务接受。
解读:调优本质是"把延迟预算花在召回上"。这像物理里"精度换时间"的恒定交易。
变式:若延迟不能涨,反过来降维或加 where 缩候选,用别的方式补召回。
最佳实践清单
best = [ "建库前定高 construction_ef, 写时付一次", "查询 search_ef 按延迟预算反推", "元数据过滤尽量收窄候选, 减近邻计算量", "批次 add 控制在数百条, 防内存尖峰", "锁嵌入模型版本, 避免向量空间漂移", ] for i, b in enumerate(best, 1): print(f"{i}. {b}") ## 1. 建库前定高 construction_ef, 写时付一次 ## 2. 查询 search_ef 按延迟预算反推 ## 3. 元数据过滤尽量收窄候选, 减近邻计算量 ## 4. 批次 add 控制在数百条, 防内存尖峰 ## 5. 锁嵌入模型版本, 避免向量空间漂移
我们看调优的取舍
所有旋钮都在"召回率 vs 延迟 vs 内存 vs 成本"四面里挪。没有全局最优,只有贴合你业务的那组值。方法永远是先测基线、改一处、对比指标,而不是凭感觉全调。
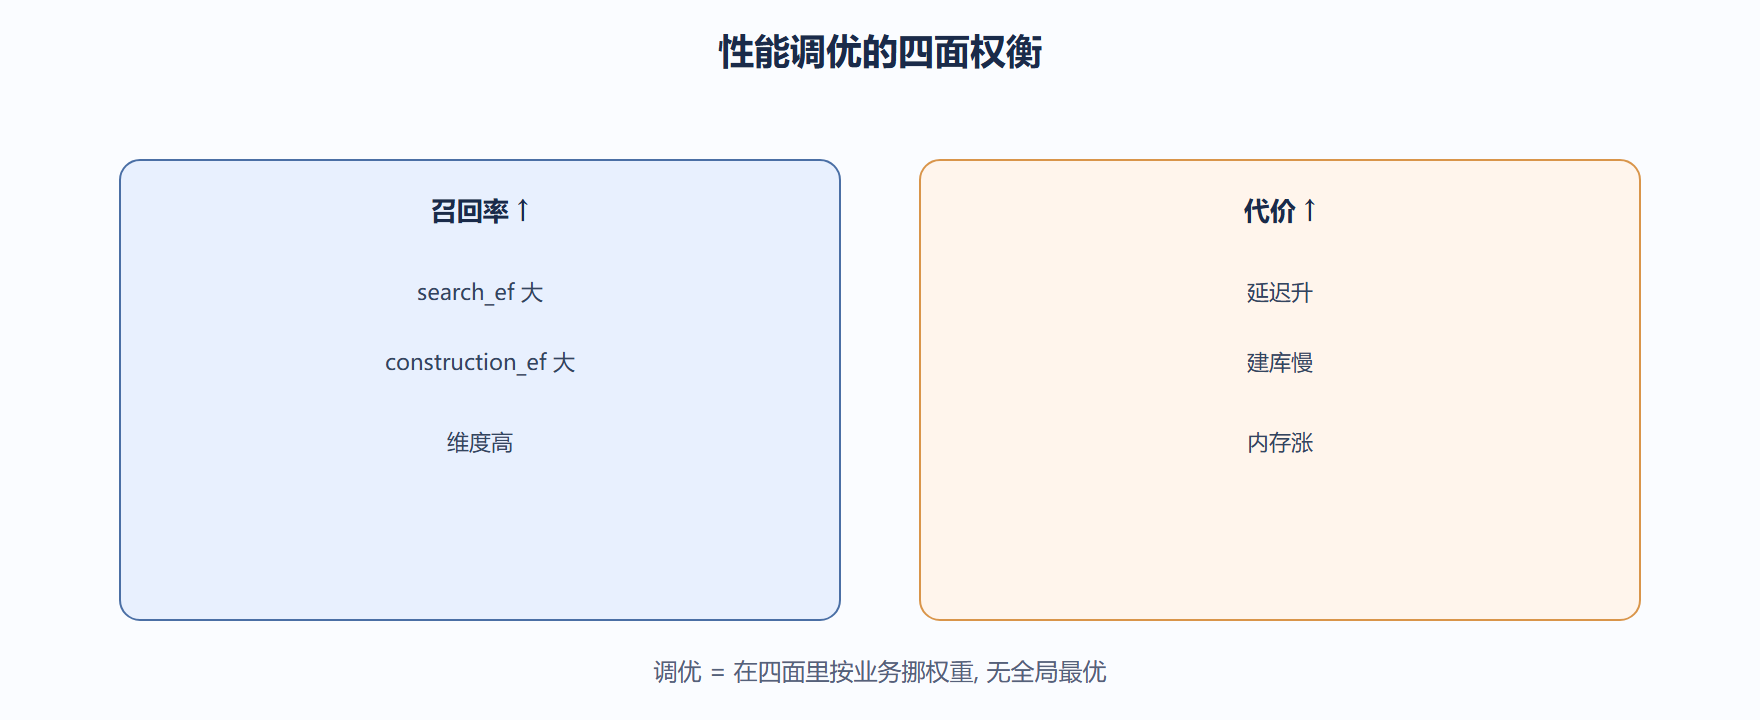
深度对照:调优是"对症下药"不是"堆参数"
性能问题先要定位瓶颈在哪个环节——是嵌入慢、写入慢、索引没建好,还是查询时过滤太宽。不定位就调参,像不明发烧就吃各种药,可能碰巧好,更可能耽误事。这像修车:先听异响来源,再拆对应部件。
常见的提速手段有:控制向量维度(够用即可)、合理切分 Collection 缩小检索范围、用元数据过滤前置剪枝、批量写入而非单条。它们针对不同瓶颈,不能乱用。
## 按瓶颈选手段(非运行代码) tuning = { "嵌入慢": "换更快模型/批量嵌入/异步", "写入慢": "批量add/upsert, 减少单条开销", "查询慢": "元数据过滤前置 + 合理n_results", "内存高": "降维度/拆Collection/清旧数据", } for k, v in tuning.items(): print(f"瓶颈={k} -> 手段={v}") ## 瓶颈=嵌入慢 -> 手段=换更快模型/批量嵌入/异步 ## 瓶颈=写入慢 -> 手段=批量add/upsert, 减少单条开销 ## 瓶颈=查询慢 -> 手段=元数据过滤前置 + 合理n_results ## 瓶颈=内存高 -> 手段=降维度/拆Collection/清旧数据
批量写入的乘数效应
单条写入每次都有固定的接口与事务开销,攒成一批写,开销被摊薄。在数据导入场景,批量能带来数倍吞吐提升。这像寄快递:一件一件跑邮局 vs 一箱打包寄,后者单位成本低得多。
⚠️ 常见坑:盲目调高索引复杂度期待加速,结果构建时间暴增、内存吃紧,查询却只快一点点。先量再调,用数据说话。
💡 关键直觉:最好的调优往往是"少做无用功"——用过滤把检索范围缩到最小、用批量把固定开销摊薄,比调算法参数更立竿见影。
实践中的常见坑与关键直觉
- ⚠️ 不建基线就调优:没有 before/after 对比,不知道调了是变好还是变坏。
- ⚠️ 在错误层优化:查询慢其实是嵌入模型拖,却去调索引,南辕北辙。
- 💡 把调优结果记成文档,下次类似场景直接复用,不再从零摸索。
- 💡 性能目标设阈值(如 P95 < 100ms),达标即停,避免过度优化。
本节要点回顾:调优核心旋钮是 construction_ef(只影响写,应调高)、search_ef(影响读,按延迟预算定)、维度 d(降维省资源但损表达);方法是先测基线、改一处、对比指标,在召回/延迟/内存/成本四面里按业务取值。
⚠️ 不测基线就全参数乱调,最后不知道哪项是正收益——每次只改一个变量对比,才是有效调优。
💡 建库用高 construction_ef 几乎白赚(只付一次),查询 search_ef 才需要反复权衡延迟与召回。