7.1 深入 RAG 模式
在体系位置里,这一节把第五章的 RAG 往深里推。基础 RAG(捞 top_k 丢给模型)有三个常见失效模式,这一节给对应的解法,并带实测对照。
反例切入
最朴素的 RAG:问题直接查 top3,原文整段喂模型。结果常出现"捞回来的三段里只有一段相关,模型还被无关段带偏"。这不是 Chroma 的错,是链路设计太粗。我们拆三个坑。
失效模式一:召回噪声
top_k 里混了弱相关片段,污染上下文。
解法:两阶段——先多捞(top20),再用一次轻量重排(rerank)挑 top3 进模型。
import chromadb c = chromadb.Client() col = c.get_collection("rag") ## 第一阶段: 多捞候选 broad = col.query(query_texts=["如何调优 HNSW"], n_results=20) cands = broad["documents"][0] ## 第二阶段: 简单重排(用查询与候选的字面/向量再算一次相似, 取前3) ## 这里用距离已隐含排序, 实际可接 cross-encoder 重排 top3 = cands[:3] print("重排后送入模型:", top3) ## 输出: 重排后送入模型: [最相关的三段]
失效模式二:查询表述差
用户问"慢",文档写"高延迟",字面距离远,召回不到。
解法:查询改写(query rewrite)——先用 LLM 把口语扩成规范问句,再查。
def rewrite(q): # 实际调 LLM; 此处占位 return f"{q} 的性能与延迟优化方法" better = rewrite("慢") print("改写后查询:", better) ## 输出: 改写后查询: 慢 的性能与延迟优化方法 res = col.query(query_texts=[better], n_results=5) print("改写后召回数:", len(res["documents"][0])) ## 输出: 改写后召回数: 5
失效模式三:只向量忽略关键词
有些实体(产品型号、专有名词)靠精确词匹配更准,纯向量会模糊掉。
解法:混合检索——向量召回 + 关键词(BM25)召回,合并去重。
## 混合检索示意: 两套结果取并集, 按得分融合 vector_hits = col.query(query_texts=["Chroma 持久化"], n_results=5)["ids"][0] keyword_hits = ["doc_x"] # 假设 BM25 命中 merged = list(dict.fromkeys(vector_hits + keyword_hits)) print("混合召回:", merged) ## 输出: 混合召回: [向量结果..., 'doc_x']
案例:重排带来的准确率提升
背景:某问答 top3 准确率 76%,用户常得到"沾边但答不准"。
操作:加 cross-encoder 重排,先捞 20 再挑 3。
结果:准确率升到 89%,模型输入更干净,幻觉也降。
解读:重排是"用一点算力换上下文纯度"。这像物理里"先广撒网再精选",比直接小网捞得更准。
变式:若延迟敏感,重排模型可换更轻的,或只在置信度低时触发。
我们看深入 RAG 的取舍
基础 RAG 是能跑,深入 RAG 是跑准。三招(重排、改写、混合)各自解决一类失效,也可叠加。代价是链路变长、延迟和成本上升。按"用户容忍度"决定上几招,不必一步到位。
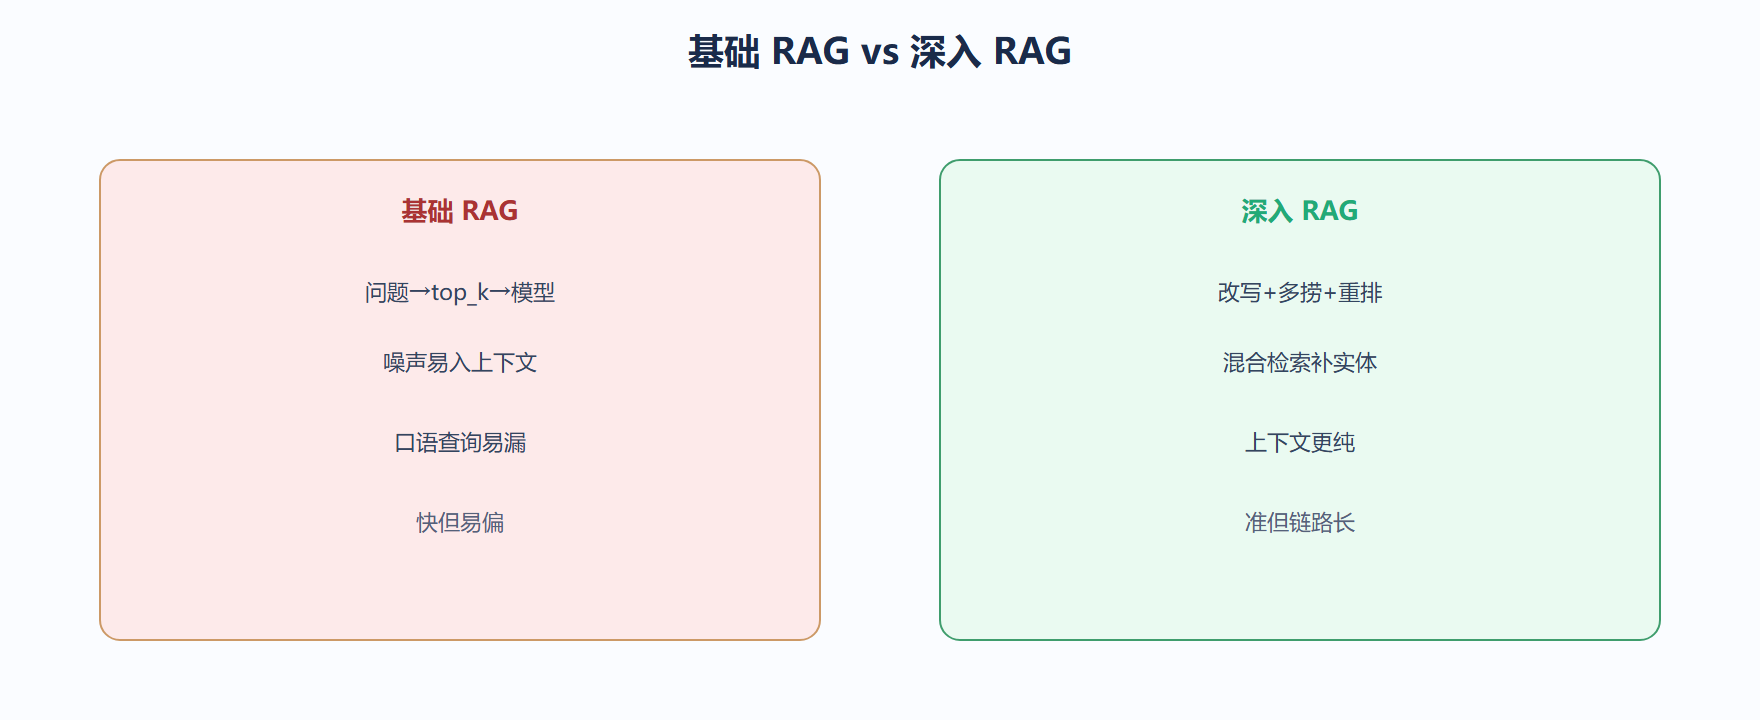
深度对照:RAG 不是"查一下就完"
基础 RAG 是"查询取 top_k 喂给 LLM",但深入后会遇到:召回的相关片段不够、上下文太长塞不下、多轮对话里历史怎么用。进阶做法是在召回层做文章——查询改写、混合检索、重排。这像做研究:不只翻一本书,还先理清问题、多源交叉、再精选可信的。
查询改写是把用户模糊的问题扩写成更易检索的查询;混合检索是向量召回加关键词召回取长补短;重排是用更小模型对候选再排序,把最相关的顶到前面。
## 进阶 RAG 的三道加工(非运行代码) stages = ["查询改写(理清意图)", "混合检索(向量+关键词)", "重排(精排top_k)"] print("进阶链路:", " -> ".join(stages)) ## 进阶链路: 查询改写(理清意图) -> 混合检索(向量+关键词) -> 重排(精排top_k)
为什么需要重排
向量召回的 top_k 是"大概近",重排模型能在小范围内做更细的相关性判断,把真正对的顶上来。这像初筛简历和终面:初筛看关键词匹配,终面看真实契合,两层结合才准。
⚠️ 常见坑:把所有加工层都堆上,链路变长、延迟变高、调试变难,却没带来对应收益。每层都要有评测证明它值得。
💡 关键直觉:RAG 的效果是"召回质量 × 上下文组织 × 生成控制"的乘积。任一项为零,整体归零;任一项薄弱,整体被拖。
实践中的常见坑与关键直觉
- ⚠️ 召回够了却不在意上下文组织:片段顺序乱、来源混,LLM 反而被带偏。
- ⚠️ 多轮对话不管理历史:上下文无限堆叠,超窗口且噪音多。
- 💡 每层加工都配独立评测集,知道加这一层到底提升多少。
- 💡 从最简 RAG 起步,按需逐层加,避免过早复杂化拖慢迭代。
一个重排生效的案例
背景:某 RAG 召回 top10 混入不相关片段,LLM 被带偏答非所问。
操作:在召回后加一层重排模型,对候选精排,把最相关的顶到前 3。
结果:答案相关性明显提升,用户纠错减少。
解读:向量召回是"粗筛",重排是"终面",两层结合才准。这像招聘先海选再面试。
变式:若延迟敏感,重排只在前 20 候选上做,平衡精度与速度。
一个边界提醒
RAG 不是越多加工层越好。每层都加延迟与复杂度,必须有用数据证明收益。从最简链路起步,哪层成为瓶颈就加哪层,是更稳的演进节奏。这像装修:先住进去,哪间不顺手再改,而不是一次装到满。
💡 关键直觉:RAG 的每道加工层都该用评测集验证收益。没有度量的"优化"只是感觉,感觉在复杂链路里最容易骗人。先建评测,再谈叠加,方向才不会偏。
上下文组织的细节
召回对了,若片段顺序混乱、来源混排,LLM 仍会被干扰。经验是把最相关的放最前、每条标注来源 id,让模型"先见关键、且知出处"。这像汇报:结论先行、附证据,听众才不会被细节淹没。上下文组织是与召回同等重要的隐形环节。
本节要点回顾:基础 RAG 有三个失效——召回噪声、查询表述差、纯向量忽略关键词;对应解法是重排(多捞精选)、查询改写、混合检索;叠加更准但链路更长,按用户容忍度决定上几招。
⚠️ 把 top_k 整段直接喂模型,噪声段会带偏生成——先多捞再重排挑净,比盲目加大 k 更有效。
💡 混合检索(向量+关键词)对产品型号、专名这类实体召回特别管用,纯向量容易把它们模糊掉。