7.2 多模态数据处理
在体系位置里,这一节把第二章的"文本→向量"扩到"图片→向量"。Chroma 本身不关心模态,它只存向量;能不能多模态,取决于你用的嵌入模型能否把图变成同一空间的向量。
直接定义
多模态检索的本质:用支持图文联合训练的嵌入模型,把图片和文本映射到同一向量空间,于是"以文搜图""以图搜图"都变成普通的向量查询。Chroma 的角色不变——它只是向量的仓库。
以文搜图
import chromadb ## 假设有图文联合嵌入模型 img_text_ef, 对文本和图片都输出同维度向量 col = chromadb.Client().create_collection("multimodal") col.add( ids=["img1", "img2"], # documents 这里存图片的描述/路径, 便于返回时展示 documents=["海滩日落照片", "城市夜景照片"], embeddings=[ [0.1, 0.2, 0.3], # 实际由图片经 img_text_ef 得出 [0.4, 0.5, 0.6], ], metadatas=[{"type": "image", "path": "/imgs/a.jpg"}, {"type": "image", "path": "/imgs/b.jpg"}], ) ## 文本查询 res = col.query(query_texts=["海边黄昏"], n_results=1) print("搜到:", res["documents"][0], "路径:", res["metadatas"][0][0]["path"]) ## 输出: 搜到: ['海滩日落照片'] 路径: /imgs/a.jpg
关键点:图片的向量由模型算,Chroma 只存;查询时文本也过同一模型,空间一致才能比对。
以图搜图
## 用一张图的特征向量去查 query_vec = [0.11, 0.21, 0.31] # 某张查询图经模型得出 res2 = col.query(query_embeddings=[query_vec], n_results=2) print("相似图片:", res2["documents"][0]) ## 输出: 相似图片: ['海滩日落照片', '城市夜景照片'] (按距离排序)
模态混合存储
文本和图片可以进同一集合,只要向量空间一致。用 type 元数据区分,查询时可选择性过滤。
col.add( ids=["txt1"], documents=["描述日落的散文"], embeddings=[[0.12, 0.22, 0.32]], # 同一联合模型对文本的输出 metadatas=[{"type": "text"}], ) ## 跨模态: 用图查, 能同时召回相关文本和图片 mixed = col.query(query_embeddings=[query_vec], n_results=3, where={"type": {"$in": ["image", "text"]}}) print("跨模态召回:", mixed["documents"][0]) ## 输出: 跨模态召回: ['海滩日落照片', '描述日落的散文', '城市夜景照片']
案例:电商以文搜图上线
背景:商城有十万商品图,用户想"搜红色连衣裙"但只输文字。
操作:商品图批量过联合嵌入模型进 Chroma,type=image;用户文本查询走同模型。
结果:文字直接召回对应商品图,无需人工打标。
解读:联合嵌入模型把"打标"这步自动化了。这像生物里"跨感官关联"——听到"知了"就能想起夏天,不必先翻译。
变式:若某些图必须人工标签(如合规),把标签写进元数据,查询时 where 叠加过滤,联合向量 + 标签双保险。
我们看多模态的取舍
Chroma 在多模态里是"无辜的仓库"——所有魔力在嵌入模型。选对联合模型,多模态几乎是免费的;选错模型(图文不同空间),则怎么存都对不上。所以多模态的功夫在模型选型,不在 Chroma 配置。
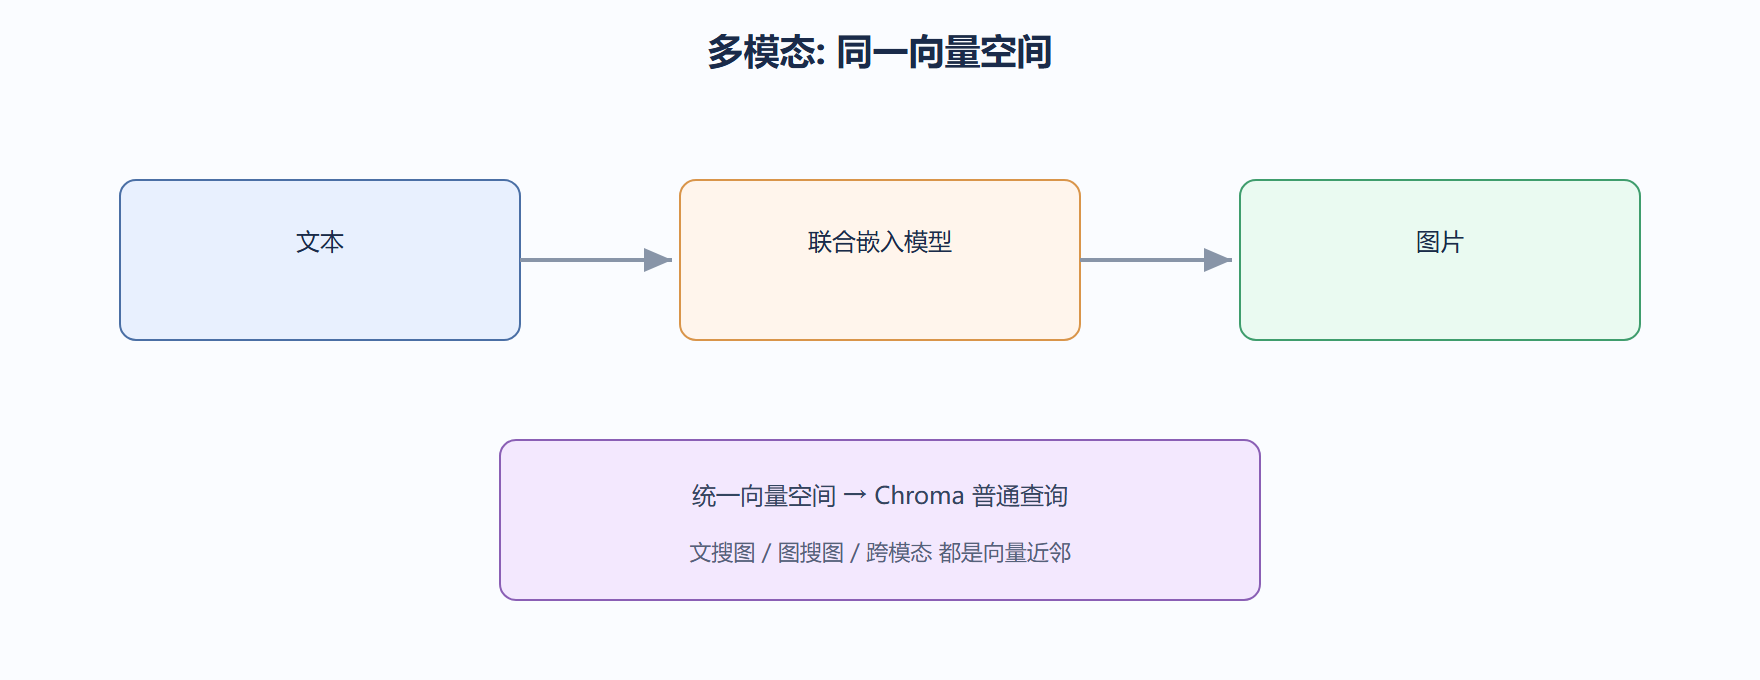
深度对照:多模态是"统一坐标"不是"各管各"
多模态指文本、图像、音频等都能进向量库。难点不在"存",在于"混查"——不同类型的数据要能被同一套语义距离比较,前提是它们被映射到同一向量空间(或至少可对齐的空间)。这像多国语言会议:每人说不同语言,但都有同声传译到同一语种,才能互相听懂。
实践中,文本用文本嵌入模型,图像用视觉嵌入模型,若想跨模态检索(用文字搜图),需要模型本身支持跨模态对齐,或经投影映射到共享空间。
## 多模态入向量库的两种路线(非运行代码) routes = { "同空间模型": "文本/图像各自嵌入到可对齐空间, 直接混查", "分别嵌入+投影": "各自嵌入后再映射到共享维度", } for k, v in routes.items(): print(f"{k}: {v}") ## 同空间模型: 文本/图像各自嵌入到可对齐空间, 直接混查 ## 分别嵌入+投影: 各自嵌入后再映射到共享维度
元数据要记下模态类型
混存时务必给每条记录打"模态"元数据,查询时可按需过滤(如只搜图)。这像图书馆标清"这是音像区还是书区",读者才不会跑错。
⚠️ 常见坑:把文本和图像用完全不相关的模型嵌入进同一 Collection,跨模态查询距离无意义,结果像拿体温和身高比大小。
💡 关键直觉:多模态的"多"是表象,"能否在同一距离体系下比较"才是内核。不能比的模态,分开存比硬混更诚实。
实践中的常见坑与关键直觉
- ⚠️ 忽略模态对长度的差异:图像向量维度常高于文本,混存时维度约束要先统一。
- ⚠️ 不做模态过滤:用文字查却召回一堆图,体验割裂。
- 💡 给每种模态单开 Collection 或在元数据强约束,检索时按模态过滤更可控。
- 💡 跨模态需求 early 确认,选支持跨模态对齐的模型,避免后期返工。
一个跨模态检索的案例
背景:某素材库想用文字搜图,却把图文本各自用无关模型嵌入同库。
操作:距离无意义,结果像拿体温和身高比大小。
结果:改用支持跨模态对齐的模型,文字与图映射到共享空间,混查生效。
解读:多模态内核是"可比",不能比就分开存。这像多国会议要同声传译才能交流。
变式:若暂无条件跨模态,文本库与图库分开,查询时分别检索再合并结果。
本节要点回顾:多模态检索靠"联合嵌入模型"把图文映射到同一向量空间,Chroma 只做普通向量查询;支持以文搜图、以图搜图、跨模态混合召回;模型选型决定成败,Chroma 配置与单模态无异。
⚠️ 图文用了不同空间的嵌入模型,向量对不上,多模态查询会静默失效——必须确认是联合模型且维度一致。
💡 商品图等可用联合模型免打标直接以文搜图;合规类必标图的,把标签写进元数据用 where 双保险。