7.4 领域特定应用与定制化
在体系位置里,这一节是第七章收尾,也是全册"会用"到"用好"的最后一跃:把 Chroma 落到具体领域(法律、医疗、金融)时,schema、切分、嵌入怎么定制。通用做法在这里要打补丁。
历史角度切入
早期向量库多用于通用文档检索,领域知识一来就露怯:法律条文讲究条款层级、医疗术语错一字意思全反、金融研报数字敏感。直接用通用嵌入 + 固定切分,召回常常"看起来相关其实答非所问"。领域定制就是补这些缝隙。
领域元数据 schema 设计
import chromadb col = chromadb.Client().create_collection("law") ## 法律领域: 平铺可过滤字段, 便于按效力层级/领域缩查 col.add( ids=["law_1"], documents=["合同法第52条: 恶意串通损害国家利益的合同无效"], metadatas=[{ "domain": "law", "category": "contract", # 合同/侵权/婚姻... "level": "law", # 法律/条例/司法解释 "effective": True, }], ) ## 查询时按领域+类别双重护栏 res = col.query(query_texts=["哪种合同无效"], n_results=3, where={"domain": "law", "category": "contract"}) print("法律领域命中:", len(res["documents"][0])) ## 输出: 法律领域命中: 1
领域切分策略
## 法律按条款切, 而非固定字数, 保住语义边界 def chunk_by_clause(text): # 简化: 按"第x条"切分 import re parts = re.split(r"(?=第\d+条)", text) return [p for p in parts if p.strip()] doc = "第52条 恶意串通无效。第53条 免除人身伤害责任的条款无效。" print("按条款切:", chunk_by_clause(doc)) ## 输出: 按条款切: ['第52条 恶意串通无效。', '第53条 免除人身伤害责任的条款无效。']
领域嵌入模型
## 医疗/法律常用领域微调模型, 替换默认嵌入 from chromadb.utils import embedding_functions law_ef = embedding_functions.HuggingFaceEmbeddingFunction( model_name="maidalun/bce-embedding-base_v1" # 示意: 领域向模型 ) col_law = chromadb.Client().create_collection("law2", embedding_function=law_ef) col_law.add(ids=["l1"], documents=["善意取得制度适用于动产"]) print("领域模型维度:", len(law_ef(["测试"])[0])) ## 输出: 领域模型维度: (按模型)
案例:医疗术语召回纠错
背景:通用模型把"心梗"和"心衰"当成相近,临床检索误召回。
操作:换医疗微调嵌入模型,并加 icd_code 元数据做精确过滤。
结果:术语级区分明显提升,"心梗"不再误召回"心衰"文档。
解读:领域错的代价比通用高得多——医疗答错可能误导诊断。这像物理里"量纲":错一个单位,结果差出量级。
变式:若领域模型贵,可对头部高频术语建关键词白名单,混合检索兜底。
我们看定制的取舍
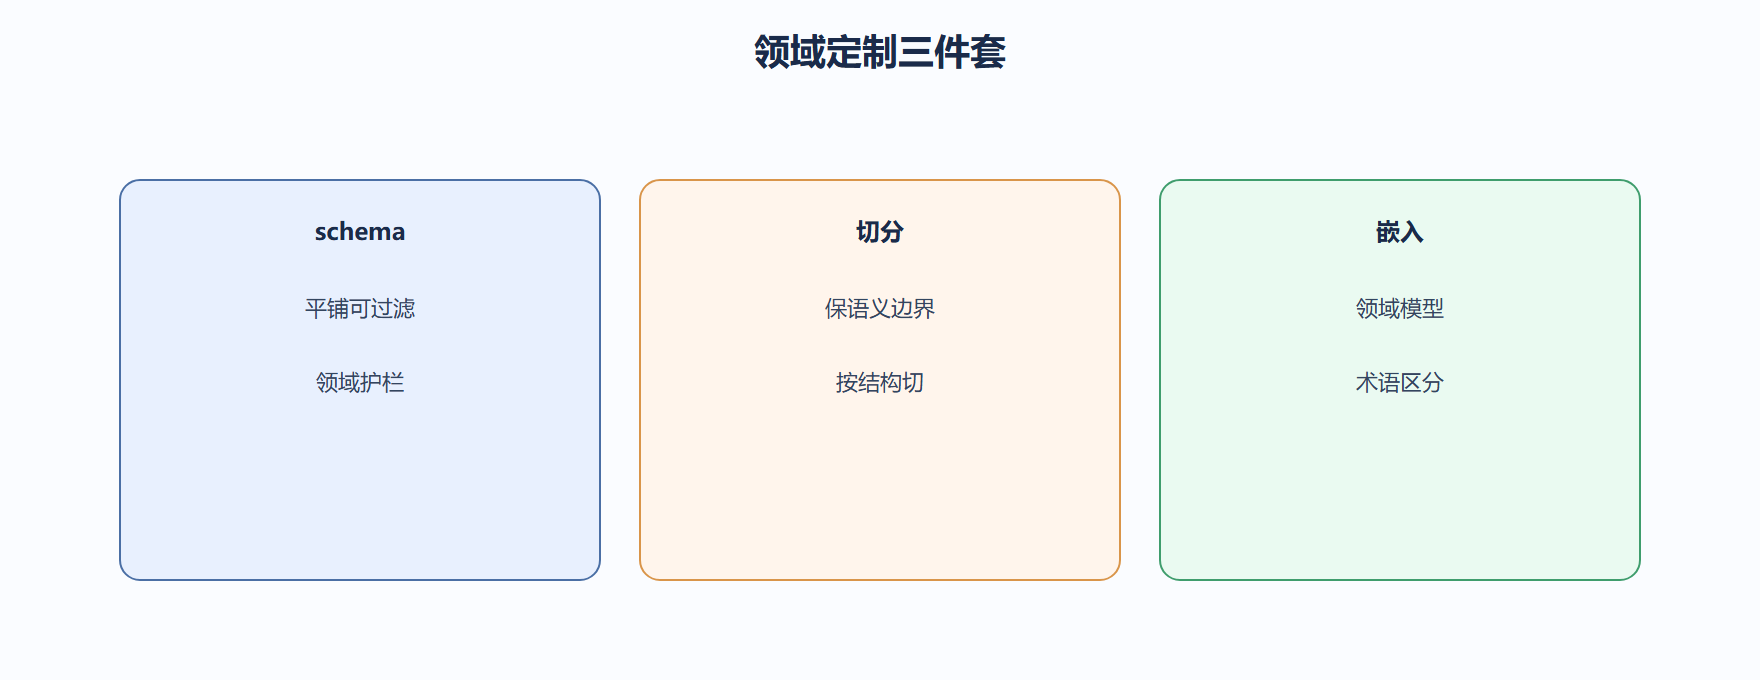
领域定制三件套——schema(平铺可过滤)、切分(保语义边界)、嵌入(领域模型)——每一项都针对"通用做法在该领域的失效点"。代价是你要懂领域结构才能设计对。先小集合验证召回,再全量灌,是最稳的路径。
深度对照:领域定制是"调口味"不是"换厨房"
通用嵌入模型覆盖广但未必贴合你的专业领域(如法律、医学、金融术语)。领域定制是在不推翻整个 Chroma 架构的前提下,换上更懂你行话的嵌入模型,或做领域切分。这像同一套厨房设备,换本地方言的菜单,出品的菜更对本地胃口。
定制手段包括:选用领域微调的嵌入模型、为领域文档单独开 Collection、在元数据里强化领域标签便于过滤。架构不变,只是"料"更专。
## 领域定制的几种杠杆(非运行代码) levers = { "领域嵌入模型": "更懂行话, 近义关系更准", "领域专属Collection": "语义域隔离, 不干扰通用库", "领域元数据标签": "查询时强过滤到领域", } for k, v in levers.items(): print(f"{k}: {v}") ## 领域嵌入模型: 更懂行话, 近义关系更准 ## 领域专属Collection: 语义域隔离, 不干扰通用库 ## 领域元数据标签: 查询时强过滤到领域
评估定制是否值得
定制有成本(找/训模型、重嵌数据)。判断标准是:通用模型在你的领域召回是否真的不够。先用通用模型建评测集,发现明显短板再投入定制。这像先试吃再决定改菜单,不凭感觉。
⚠️ 常见坑:一上来就训领域模型,投入大,结果通用模型加几个领域同义词表就能解决,白费力气。
💡 关键直觉:定制是"边际改进"手段,不是"必做动作"。先量化通用方案的不足,再决定定制力度,避免过度工程。
实践中的常见坑与关键直觉
- ⚠️ 领域模型训完不重嵌旧数据:新查询用新坐标系,旧向量还是旧的,距离失准。
- ⚠️ 领域 Collection 无限细分:每个子领域一库,管理爆炸,应按语义接近度合并。
- 💡 把领域词典作为元数据增强,低成本提升过滤精度,先于重训模型尝试。
- 💡 领域定制效果用领域评测集量化,证明 ROI 再扩大投入。
一个过度定制的案例
背景:某团队一上来就训领域嵌入模型,投入大周期长。
操作:事后发现通用模型加领域同义词表就能解决大半问题。
结果:退回轻量方案,用元数据标签增强过滤,召回已够用。
解读:定制是边际手段,先量化通用方案不足再投入。这像先试吃再改菜单。
变式:若确需定制,先用领域评测集证明 ROI,再扩大模型微调与重嵌投入。
本节要点回顾:领域定制三件套——schema(平铺可过滤字段做领域护栏)、切分(按条款/结构保语义边界)、嵌入(领域微调模型提升术语区分);通用模型在法律/医疗易错,应先小集合验证召回再全量。
⚠️ 医疗等法律高危领域用通用嵌入,术语级误召回可能误导决策——领域模型或关键词白名单不是可选项。
💡 领域定制先在小集合上验证召回对不对,再全量灌库;直接全量往往要返工重灌,成本高。