7.3 实时数据流与更新
在体系位置里,这一节解决"库不是一次建好就完事"的问题。新闻、日志、对话这些场景,数据源源不断来,怎么增量进 Chroma 而不每次重建?这一节给增量更新策略。
场景代入
你做了一个资讯 bot,每小时新增几百条新闻。如果每次都全量重建集合,既慢又让服务在重建期不可用。正确做法是把新数据"流"进去,旧数据不动。Chroma 的 upsert 和 add 就是为流式设计的。
增量写入:来一条加一条
import chromadb, time col = chromadb.Client().create_collection("stream") def on_new_doc(doc_id, text, meta): # 新文档到达即写入, 不影响已有数据 col.upsert(ids=[doc_id], documents=[text], metadatas=[meta]) print(f"[{time.strftime('%H:%M')}] 入库 {doc_id}, 当前 {col.count()}") on_new_doc("n1", "某地发布高温预警", {"ts": int(time.time()), "cat": "news"}) on_new_doc("n2", "新能源车企公布季报", {"ts": int(time.time()), "cat": "news"}) ## 输出: ## [xx:xx] 入库 n1, 当前 1 ## [xx:xx] 入库 n2, 当前 2
每次只动新增部分,HNSW 图增量生长,旧数据查询不受影响。
用时间戳过滤做"近期窗口"
## 只查最近一小时的资讯 now = int(time.time()) recent = col.query( query_texts=["高温相关"], n_results=5, where={"ts": {"$gte": now - 3600}}, ) print("近一小时命中:", len(recent["documents"][0])) ## 输出: 近一小时命中: (按实际)
过期数据清理
## 流式写入也需定期清过期, 否则无限膨胀 old = int(time.time()) - 86400 * 7 # 7天前 col.delete(where={"ts": {"$lt": old}}) print("清理后条数:", col.count()) ## 输出: 清理后条数: ...
案例:对话记忆的实时追加
背景:多轮对话,每轮用户/助手的话都要进记忆,下一轮能捞回。
操作:每轮结束即 upsert 该轮(id 用 会话id#轮次),查询时按会话 id 前缀过滤。
结果:对话越长记忆越全,且不影响其他会话。
解读:流式 upsert 让"记忆"真正随对话生长。这像生物里的"长期记忆巩固"——每次经历都增量写进,不重来。
变式:若单会话过长撑爆上下文,可定期对旧轮做摘要再存摘要向量,控长度保相关。
我们看实时更新的取舍
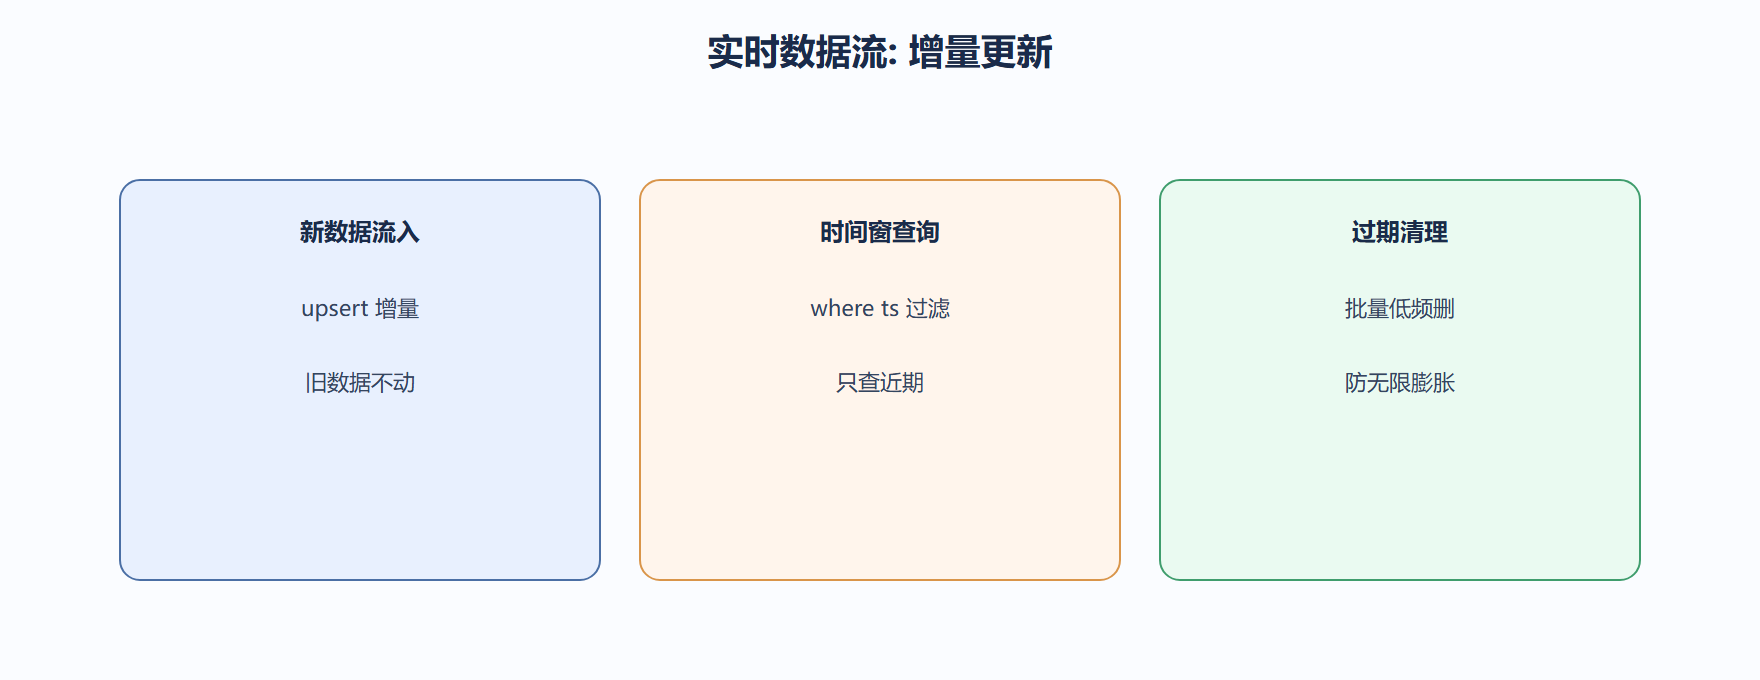
增量更新让 Chroma 从"静态库"变成"活库",代价是要自己管生命周期:新数据怎么进、旧数据怎么清、id 怎么设计避免冲突。HNSW 支持增量加,但不擅长"大量删除"——频繁大批量删会拖图质量,所以过期清理建议批量、低频。
深度对照:实时更新是"活水"不是"死库"
很多场景数据是流动的:新闻在涨、工单在变、对话在续。向量库若只批量灌一次就不动,很快过时。实时更新要求写入链路能持续接收新数据并让检索及时可见。这像养鱼塘要活水循环,死水一潭很快臭。
实时更新要处理两件事:新数据的嵌入与写入(upsert),以及索引的刷新节奏(新向量何时参与高效检索)。两者节奏不匹配就会"写进去了但查不到"。
## 实时更新的两个节奏(非运行代码) stream = { "写入节奏": "新数据来了即 upsert, 保证不丢", "索引节奏": "按策略刷新, 决定新向量何时可高效查", } for k, v in stream.items(): print(f"{k}: {v}") ## 写入节奏: 新数据来了即 upsert, 保证不丢 ## 索引节奏: 按策略刷新, 决定新向量何时可高效查
一致性的取舍
实时场景常要在"查到最新"和"查询性能"间取舍:刷新越频繁越新但开销大,刷新越疏越省但略有延迟。这像新闻推送:实时推送最新鲜但耗流量,定时汇总省流量但慢半拍,按业务容忍度选。
⚠️ 常见坑:假设 upsert 后立刻能被高效检索,结果新数据走了兜底全扫,延迟忽高忽低,被误判为库慢。先搞清楚索引刷新策略。
💡 关键直觉:实时不是"越快越好",而是"在业务能接受的延迟内,数据不丢、可查、不卡"。把延迟预算算清楚再定节奏。
实践中的常见坑与关键直觉
- ⚠️ 写入和刷新节奏脱节:狂写但不刷新,检索长期看不到新数据。
- ⚠️ 不监控更新 lag:等用户说"刚发的查不到"才发现管道堵了。
- 💡 把"写入成功"和"可被检索"分成两个可观测指标,分别报警。
- 💡 流量高峰时写缓冲队列,削峰填谷,保护检索稳定性。
一个"查不到新数据"的案例
背景:某新闻库实时 upsert,用户刚发的新闻搜不到,被疑库慢。
操作:未理解索引刷新节奏,新向量走了兜底全扫,延迟忽高忽低。
结果:摸清刷新策略并监控更新 lag,把"写入成功"与"可检索"分开报警。
解读:实时要分清两个节奏,脱节就会看似写入却查不到。这像鱼塘活水循环断了,水还是死。
变式:高峰流量走缓冲队列削峰,保护检索稳定,避免管道堵塞。
一个边界提醒
并非所有数据都需实时。配置类、慢变资料用定时批量更新即可,只有真正"现在发生"的数据才值得实时管道。盲目实时化会增加复杂度和故障面。这像日报和快讯:多数内容次日看也行,只有突发才要推送。
💡 关键直觉:实时的代价是复杂度,值不值要看业务对"新鲜度"的容忍度。容忍度高就批量,容忍度低才上实时管道,别为少数场景拖累整体架构。
写入幂等的重要性
实时管道会有重试,upsert 天然幂等,重发同一条不会重复或错乱。若用 add 则需自己去重,否则网络抖动重发会报错或产生重复。实时场景默认走 upsert,是把"可重试"写进设计。这像收银小票:重复打印同一笔不应变成两笔账。
本节要点回顾:实时更新用 upsert 增量写入,旧数据不受影响;用时间戳元数据做近期窗口查询;过期数据批量低频清理防膨胀;HNSW 善加不善大量删,清理要低频。
⚠️ 频繁大批量 delete 会拖 HNSW 图质量——过期清理应批量、低频,而非每条实时删。
💡 流式场景用"会话id#轮次"做稳定 id,既增量追加又不跨会话污染,多轮记忆天然隔离。