1.2 核心概念与关键特性
1.2 核心概念与关键特性
三个词先认全,后面才不晕
读 Cognee 的代码,你会反复撞见实体、关系、属性这三个词。它们不是营销话术,而是图谱里真实的三种对象。这一节站在第一章概念层,替你把这些词钉死,等你进到第四章写 cognify 时就能对号入座。
- 实体(Entity):世界里一个可被指称的东西,比如"张三""量子计算""北京"。在图里它是一个节点。
- 关系(Relation):连接两个实体的语义箭头,比如"张三—任职于—某公司"。在图里它是一条有方向的边。
- 属性(Property):挂在实体或关系上的附加信息,比如"某公司—成立年份—2015"。它让节点不只是个名字,而是带元数据的对象。
三元组是图的原子
图谱里最小的信息单元是三元组(主语,谓语,宾语)。上面那句"张三任职于某公司"拆开就是:(张三, 任职于, 某公司)。Cognee 让 LLM 把文本压成一组三元组,再批量写图。下面这段代码用 Cognee 的思路演示一次抽取结果的结构。
# 假设模型从一段简历里抽出了如下三元组 triples = [ ("张三", "任职于", "云图科技"), ("云图科技", "位于", "北京"), ("张三", "擅长", "知识图谱"), ("知识图谱", "属于", "人工智能领域"), ] # Cognee 内部会把这些三元组映射成图节点与边 for subj, pred, obj in triples: print(f"节点[{subj}] --{pred}--> 节点[{obj}]") # 节点[知识图谱] --属于--> 节点[人工智能领域]
跑这段代码你会看到,原本一段自然语言,被拆成了四个可遍历的跳跃。这正是图谱相对扁平向量的优势:多跳问题变成了在图上走几步。
认知流水线(Pipeline)
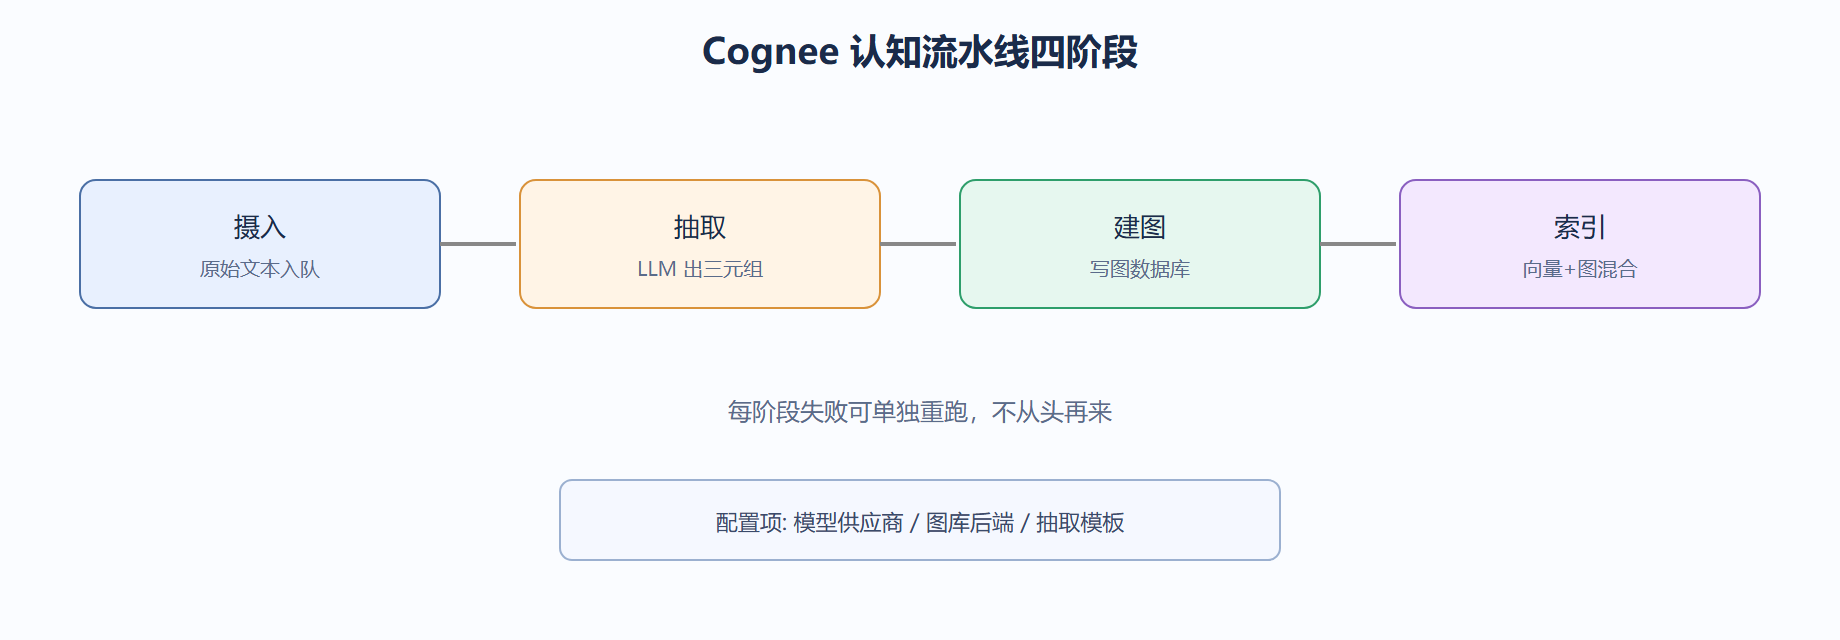
Cognee 把"摄入→抽取→建图→索引"封装成一条流水线。默认流水线够用,但你也可以像拼积木一样换掉某一环。下图展示了默认流水线的四个阶段,以及每阶段产出的中间物。
关键特性逐条说
我们挑几个真正影响你写代码的特性讲,不堆列表:
- 多源摄入:PDF、Markdown、网页、对话记录都能
add,Cognee 在摄入阶段做格式归一。 - 图库可换:底层图数据库可在 Neo4j、Memgraph 等之间切换,上层 API 不变。
- 混合检索:搜索时既向量召回又图遍历,避免"语义相近但答非所问"。
- 可追溯:每条三元组带
source字段指回原文坐标。
案例:用默认流水线建一份技术文档的图
背景:团队有一份 30 页的《知识图谱技术白皮书》,希望之后能用自然语言提问其内部概念。
操作:只调两行就启动默认流水线。
import cognee await cognee.add("知识图谱技术白皮书.pdf") await cognee.cognify() # 默认流水线:抽取+建图+索引 # [索引] 向量索引完成,图索引完成
结果:图谱里出现了"知识图谱—依赖—图数据库""实体—组成—三元组"等关系,可以沿关系查概念层次。
解读:你没写一行抽取逻辑,Cognee 用内置提示模板完成了三元组生成。这是它"认知流水线"开箱即用的体现,但模板是通用的,专有领域可能需要第四章讲的自定义。
变式:若白皮书更新到第 31 页,再次 add 同一文件,Cognee 按内容指纹判断增量,只处理变更段落,不会全量重建——这也是流水线分阶段的好处。
一个深坑:三元组不是越多越好
新手容易以为"抽得越细、三元组越多,图就越聪明"。事实相反:噪声三元组会污染检索,让正确答案被无关边稀释。类比到生物——突触不是越多越聪明,错误的连接反而导致误判。质量重于数量,这一条在建图全程都成立。
下面用一段对比说明"粗粒度干净图"和"细粒度噪声图"在检索时的差异:
# 同一段文本两种抽取策略的后果(示意) clean = [("张三", "任职于", "云图科技")] # 干净:1 条有用边 noisy = [("张三", "任职于", "云图科技"), ("张三", "出现在段落", "第3段"), # 噪声边 ("云图科技", "在文档中", "被提及")] # 噪声边 # 检索"张三在哪上班"时,noisy 图要先过滤掉两条无关节系
可以看到,噪声边不会增加信息,只增加检索时的干扰。Cognee 默认抽取已经做了基础过滤,但你在第四章做自定义抽取时务必守住"只留语义关系"的纪律。
| 抽取策略 | 三元组量 | 检索信噪比 | 建议 |
|---|---|---|---|
| 只留实体关系 | 中 | 高 | 默认首选 |
| 保留版面关系 | 高 | 低 | 仅审计需要 |
| 全量无滤 | 极高 | 极低 | 禁止 |
⚠️ 自定义抽取模板时,别把"段落位置""出现次数"这类版面信息写成关系——它们是属性或元数据,不是语义边。
💡 衡量图质量的笨办法:随机抽 20 条边,看有几条是人话里真存在的关素。低于八成,先回头治抽取。
一个对照练习:用图回答"为什么"
光理解概念不够,关键是体会到"关系"带来的新能力。试一个对照:同一份简历,向量库只能答"提到过哪些公司",图能答"张三为什么和北京产生关联"。差异就在三元组把"任职于""位于"连成了链。
| 问题 | 向量库 | Cognee 图 |
|---|---|---|
| 张三在哪上班 | 能(关键词) | 能(关系) |
| 张三和北京啥关系 | 难 | 张三→公司→北京 |
| 改公司后历史 | 丢 | 保留双关系+时间 |
⚠️ 别把"概念懂了"当成"会用"。真正掌握是能举出三个只能用图答、向量库答不了的问题。
💡 学概念时随手画一张小图(纸笔也行):实体当圈,关系当箭头,画完你对三元组的理解会扎实很多。
本节要点回顾
- 实体、关系、属性是图谱三要素,三元组是最小信息单元。
- 认知流水线把建图拆成四阶段,每阶段可独立重跑。
- 多源摄入、图库可换、混合检索、可追溯是四个落地特性。
⚠️ 三元组质量直接取决于抽取用的 LLM。用太小的模型,关系会大量丢失或错连,不要盲目追求低成本。
💡 先用默认流水线跑通,确认图谱结构符合预期,再考虑替换某一阶段的模型或模板。