1.3 Cognee的发展历程与生态位
1.3 Cognee的发展历程与生态位
从"记忆脚本"到"记忆框架"
很多团队在 2023 年前后都写过同一段脚本:调 LLM 抽三元组、用 Neo4j 存、再用 Cypher 查。脚本能跑,但换个文档类型就崩,提示词散落各处,没人敢动。Cognee 的来路,就是把这类一次性脚本沉淀成一套有接口、有默认配置、可替换组件的框架。
这一节帮你判断:当你面对一个"AI 记忆"需求时,Cognee 是不是那个站在生态正确位置上的选择。
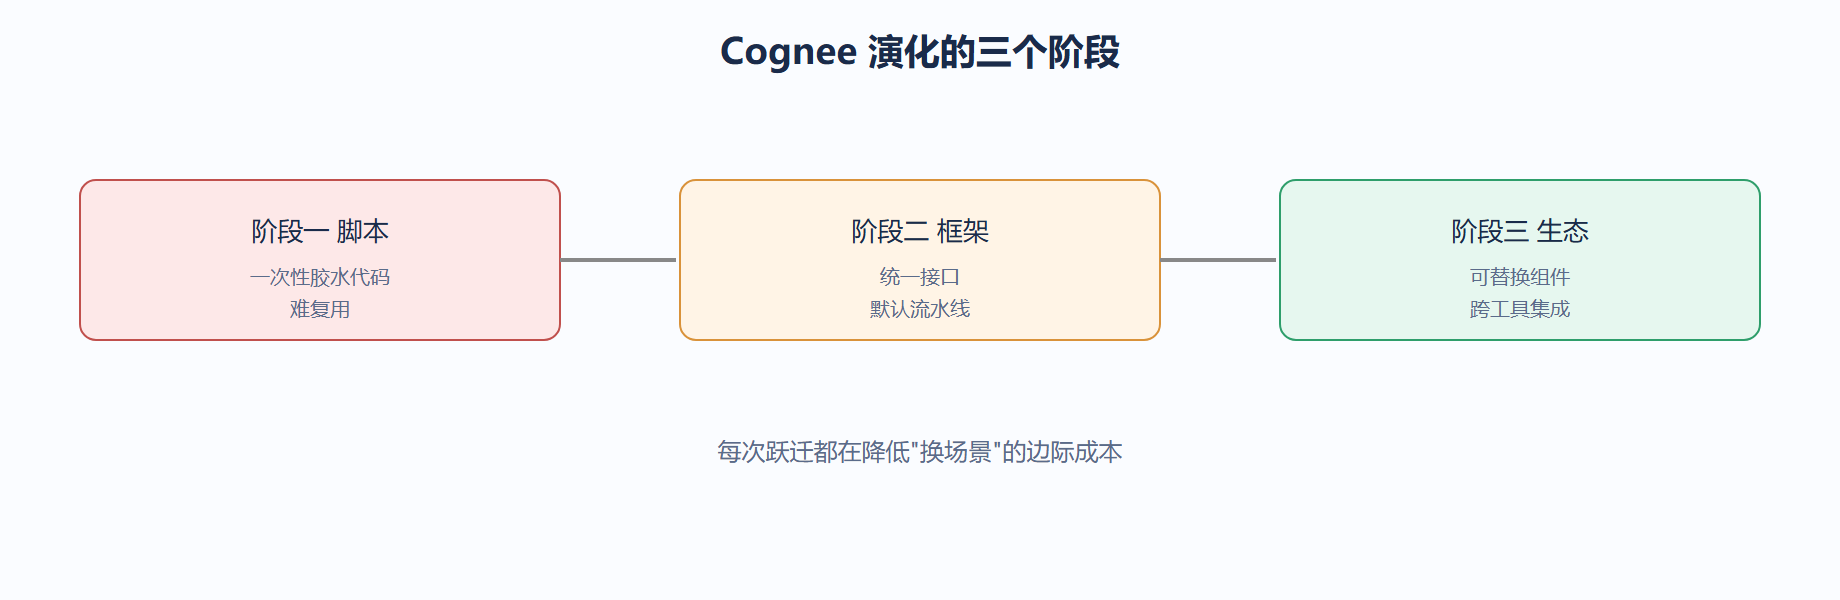
三个阶段的演变
我们可以用交通系统打比方。早期脚本像是手动开关的乡村小路——能走车,但红绿灯、匝道全得自己焊。Cognee 的第一步是把这条路修成有标准出入口的市政路:摄入、抽取、建图有了统一入口。第二步是加上"立交"——混合检索让向量和图两条路能汇流。第三步是开放"道路标准",允许你换路面材料(图库后端)、换信号灯逻辑(抽取模型)。
生态位:它卡在"记忆层"
AI 应用栈大致分三层:最底下是模型与算力,中间是编排与记忆,上面是具体产品。Cognee 明确站在中间层的"记忆"那一侧。它不和你抢编排的活——你用 LangChain 写流程,用 Cognee 当那个记得住关系的记忆模块。
# 生态位示意:Cognee 作为记忆层接入既有栈 from langchain.agents import AgentExecutor import cognee # 先建好记忆(图谱) await cognee.add("./公司知识库") await cognee.cognify() # 把图谱检索包成一个工具,交给 Agent 编排 def memory_tool(query: str): return cognee.search(query) # Cognee 负责"记忆" agent = AgentExecutor(...) # 别的框架负责"思考与行动"
这段代码里,Cognee 只干一件事:回答"记忆里有什么"。它不决定 Agent 下一步调哪个工具,也不生成最终话术。这种克制正是它的生态位——做窄、做深。
案例:研发团队的知识库老化问题
背景:一家百人研发团队的知识沉淀在 Confluence 和零散 PDF 里,新人问"我们支付模块用的什么方案",老员工得翻半天。
操作:把历史文档批量 add 进 Cognee,跑 cognify,新人通过自然语言提问。
import cognee, asyncio, glob files = glob.glob("./历史文档/**/*.pdf", recursive=True) for f in files: await cognee.add(f) await cognee.cognify() # 日志:处理 540 个文件,建成节点 4100,边 6800 ans = await cognee.search("支付模块用的什么方案") print(ans) # 'source':'架构决策记录_2023.pdf#p2'}]
结果:新人几秒内拿到答案和出处,不用再打扰老员工。
解读:价值来自"关系可查"——答案不是模糊的相似段落,而是指回一份具体决策记录。这正是 Cognee 站在记忆层、把关系结构化的结果。
变式:当团队引入新支付方案,把新决策记录 add 一次,图谱自动补一条"支付模块—改用—方案Z"的关系,并保留旧关系的生效时间,历史问答不丢。
一个实操判断:什么时候该自己造轮子
前文说 Cognee 把一次性脚本沉淀成框架。那是不是所有团队都不该自己写了?不是。判断标准看"关系结构是不是你的核心资产"。类比到金融:如果你做的是交易系统,账目一致性是命根子,你得自己掌握;如果你只是做个内部通知板,用现成框架省心。
下面这段用决策树帮你想清楚:
# 是否引入 Cognee 的决策示意 def choose(needs_graph_memory, team_size, compliance): if not needs_graph_memory: return "用向量库即可,不必上图" if team_size < 2: return "人力紧,直接用 Cognee 默认,别自研" if compliance == "strict": return "上 Cognee + 自建权限层,关系要可审计" return "引入 Cognee,按需自定义抽取" print(choose(needs_graph_memory=True, team_size=1, compliance="normal")) # 人力紧,直接用 Cognee 默认,别自研
这张判断和本册第五章合规、第六章集成是连着的:先确认痛点类型,再决定站在生态哪一层。
| 你的处境 | 建议 |
|---|---|
| 关系型记忆是核心 | 站在记忆层,用 Cognee |
| 只缺编排能力 | 用编排框架,记忆用插件 |
| 两者都要 | 编排框架 + Cognee 组合 |
⚠️ 别在"关系型记忆"痛点上自研抽取+图存储的全套——那是 Cognee 已经填好的坑,重造只会重复踩限流、去重、增量这些雷。
💡 生态位选错比工具选错更贵:用编排框架硬扛记忆,图能力长不出来;用 Cognee 硬扛编排,流程写得很别扭。
一个反例:记忆层没站住会怎样
反过来想能更清楚生态位。某团队把"记忆"硬塞进编排框架,用会话缓冲当长期记忆,结果三个月后旧会话上下文溢出,历史关系全丢,新人问"去年定的架构决策"答不出。这正是没把记忆当独立层、关系没落图的代价。
| 做法 | 三个月后 | 代价 |
|---|---|---|
| 会话缓冲当记忆 | 关系丢失 | 重问重答 |
| Cognee 独立记忆层 | 关系常在 | 一次建图长期用 |
⚠️ 别用"能跑就行"糊弄记忆层——短期看不出,关系一多就崩,到时候图重建比一开始做对贵十倍。
💡 架构选型时给"记忆"单独留一行预算和 ownership,谁负责维护图、谁有权改本体,写进文档而非口头约定。
一个提醒:框架会演进,记忆资产不动
回到本册主线——无论 Cognee 怎么升级、接口怎么变,你建的图是资产。框架是工具,关系是知识。这点和第六章 6.5 的路线判断一致:架构演进时图不废,这是图谱驱动路线最稳的地方。
⚠️ 别因框架换了版本就觉得"以前的图白建了"——图是领域知识,和工具版本解耦,升级只是换处理方式。
💡 评估框架长期价值,看它是否让你的知识资产可累积,而非功能多炫。
本节要点回顾
- Cognee 由一次性脚本演化为可替换组件的记忆框架。
- 它明确卡位在 AI 栈的"记忆层",不与编排框架抢活。
- 做窄做深,是它在生态里活下来的策略。
⚠️ 别指望 Cognee 替你做完整的 Agent 决策。把它当记忆用,决策编排交给专门框架。
💡 评估是否引入 Cognee,先看你的痛点是不是"关系型记忆缺失",而不是"推理能力不足"。