1.4 Cognee与其他AI/LLM框架的比较
1.4 Cognee与其他AI/LLM框架的比较
选型先问"缺哪块"
市面上的 LLM 框架多到让人眼花,但彼此补位而非替代。这一节我们用一张对照表把 Cognee 和几个常被拿来比的对象摆清楚,省得你重复造轮子或错配工具。
先给结论:如果你卡在"检索回来的东西答非所问、多跳问题答不出",那是记忆结构的问题,Cognee 对口;如果你卡在"怎么把多个工具串成自动流程",那是编排问题,该看 LangChain。两者常常一起用。
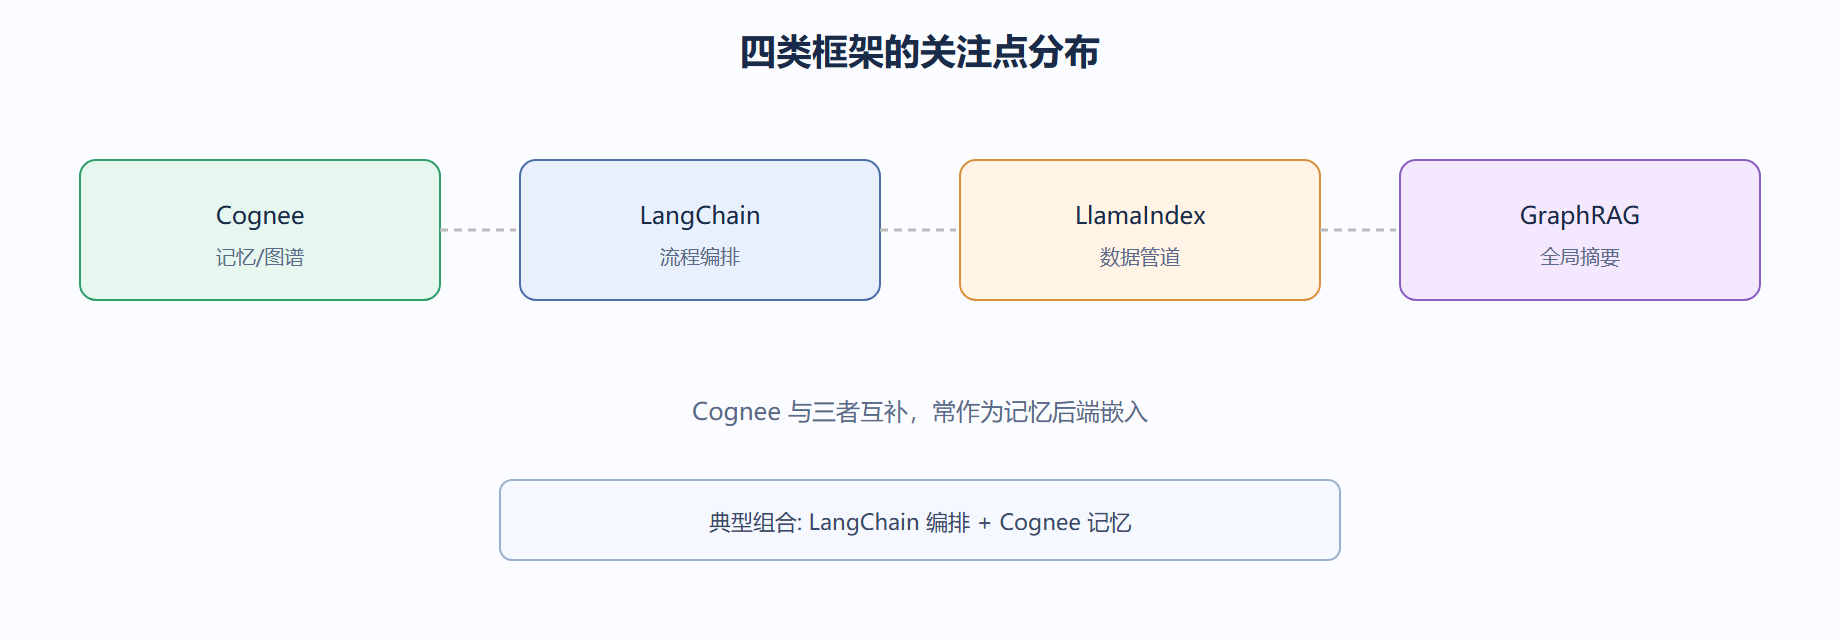
四框架对照
| 框架 | 核心定位 | 记忆形态 | 擅长 | 不擅长 |
|---|---|---|---|---|
| Cognee | 记忆层 | 知识图谱 | 关系型多跳问答 | 复杂流程编排 |
| LangChain | 编排层 | 链/记忆插件 | 把工具串成流程 | 原生图谱建图 |
| LlamaIndex | 数据连接层 | 索引+向量 | 文档到 LLM 的管道 | 关系推理弱 |
| Microsoft GraphRAG | 图谱 RAG | 图+社区摘要 | 全局性总结问答 | 轻量实时写入 |
和 LangChain 的差异
LangChain 也有 Memory 模块,但那多是会话缓冲或向量检索,本质还是扁平存储。Cognee 的区别在于把关系显式建模成图,让"张三的上级是谁的上级"这种两跳问题变成图遍历。
# LangChain 风格:会话缓冲,记的是"说过的话" from langchain.memory import ConversationBufferMemory mem = ConversationBufferMemory() mem.save_context({"input": "我叫张三"}, {"output": "你好张三"}) # Cognee 风格:关系图谱,记的是"事实之间的连接" import cognee await cognee.add("张三是云图科技的CTO") await cognee.cognify() await cognee.search("云图科技的CTO是谁") # [{'entity':'云图科技','relation':'CTO是','value':'张三', ...}]
前者回答"你刚才说你叫什么",后者回答"这家公司的 CTO 是谁"。问题性质不同,工具也不同。
和 LlamaIndex 的差异
LlamaIndex 强在把各种数据源接到 LLM,索引以向量为主。它对"文档里谁和谁有关"建模较弱。Cognee 在建图阶段就强调关系抽取,因此更适合需要顺着关系追问的场景。
案例:客服知识库的框架选型
背景:电商客服要回答"我上月买的A商品,现在降价了能补差价吗",问题跨订单、价保政策两个系统。
操作:用 Cognee 把价保规则文档和订单数据结构化建图,再用编排框架串接查询。
import cognee await cognee.add("价保政策.pdf") await cognee.add("订单数据.json") # 结构化数据也能 add await cognee.cognify() # 图谱中出现:订单A —购买— 商品A —适用— 价保规则 —允许— 补差价 ans = await cognee.search("订单A能补差价吗") print(ans) # 'source':'价保政策.pdf#p1'}]
结果:系统沿"订单→商品→规则"三跳给出肯定答案并指出来源。
解读:这种跨系统多跳,正是 Cognee 相对 LlamaIndex 单向量检索的强项——它把分散事实连成一条可验证路径。
变式:若价保政策改为"仅7天内可补",把新文档 add 后图谱更新关系,旧订单按购买时间仍可适用原规则(图带时间维度),不会一刀切错判。
一个落地组合:记忆层与编排层怎么接才不打架
前文把框架摆成对照表,但生产里它们不是二选一,而是拼起来。关键纪律是:编排框架管"先调谁",Cognee 管"记忆里有什么"。两者通过"工具调用"这一种接口通信,别互相入侵内部状态。类比到交通——红绿灯(编排)指挥车流顺序,但红绿灯不该去决定每辆车装什么货(记忆内容)。
# 编排框架只把 Cognee 当工具,不碰它内部 from langchain.agents import Tool import cognee, asyncio async def recall(q): return await cognee.search(q) memory_tool = Tool( name="graph_memory", func=lambda q: asyncio.run(recall(q)), description="查询知识图谱记忆,回答关系型问题", ) # 把 memory_tool 交给 Agent,编排框架自主决定何时调用
这样边界清晰:Agent 觉得该查记忆了就调工具,Cognee 只负责把图查准。详见第四章 4.4 的自动化延伸。
| 接口方式 | 耦合度 | 适用 |
|---|---|---|
| 工具调用 | 低 | 多框架共存首选 |
| 共享内存对象 | 高 | 单机紧耦合,慎选 |
| 事件总线 | 中 | 多服务异步场景 |
⚠️ 别让编排框架直接 import Cognee 的内部图对象去改边——这会绕过去重与版本,把图弄脏且无法追溯。
💡 选型讨论的终点是"接口契约":只要双方只通过约定好的 search/add 通信,换底层图库或换编排框架都不影响另一半。
一个误区:框架越多越牛
团队容易陷入"把所有框架都接上"的军备竞赛,结果集成成本超过收益。判断标准回到痛点:你缺的是关系记忆就上 Cognee,缺编排就上编排框架,别为"技术栈完整"而堆。类比到交通——城市不需要每种交通工具都自己造,按需采购、接口互通最经济。
| 心态 | 结果 |
|---|---|
| 痛点驱动选型 | 轻、准 |
| 军备竞赛式堆叠 | 重、乱 |
⚠️ 别在 POC 阶段就引入五个框架——集成 bug 会淹没真实价值,先单框架跑通再谈组合。
💡 选型文档写清"每个框架解决哪个具体痛点",写不出的那个就是该砍的。
本节要点回顾
- Cognee 对口"关系型记忆缺失",与编排/数据管道框架互补。
- 和 LangChain 比,它记的是关系而非会话;和 LlamaIndex 比,它强在多跳。
- 生产里常是 LangChain 编排 + Cognee 记忆的组合。
⚠️ 别为了"用图谱"而用图谱。纯单跳相似问答,向量库更轻更便宜。
💡 选型时画一张"问题需要几跳"的图:一跳用向量,两跳以上认真考虑 Cognee。