2.1 整体架构设计与模块组成
2.1 整体架构设计与模块组成
三层不是画饼,是分工
很多人一听"架构"就觉得是 PPT 上的框图。Cognee 的三层是真实分工:感知层只管把文本变成三元组,建模层只管把三元组变成图并维护一致性,服务层只管把图变成检索结果。每层出错都局限在自己边界内,这是它能工程化的原因。
这一节是第二章的总纲,后面三节分别往这三层里钻。先建立"数据从哪进、图谱从哪出"的整体感。
感知层:让模型用结构化方式看世界
感知层接收 PDF、Markdown、对话等原始数据,调用 LLM 按预设本体抽出三元组。关键不在用哪个模型,而在提示模板约束模型输出"主语-谓语-宾语"的格式。下面示意一次抽取调用(Cognee 内部逻辑,用伪代码表达)。
# 感知层思想示意:约束模型输出三元组 def perceive(text: str): prompt = ( "从下文抽取三元组,格式为(主语, 关系, 宾语)," "只输出三元组,每行一个:\n" + text ) raw = llm_complete(prompt) # 调用 LLM triples = parse_triples(raw) # 解析成结构化列表 return triples sample = "李明在2020年创立了云图科技,公司总部位于杭州。" print(perceive(sample)) # ('云图科技','总部位于','杭州')]
注意一个工程取舍:抽取质量高度依赖模型能力。小模型容易把"创立"和"就职"混淆,所以感知层通常配中等以上规模的模型,而不是一味省成本。
建模层:图的心脏
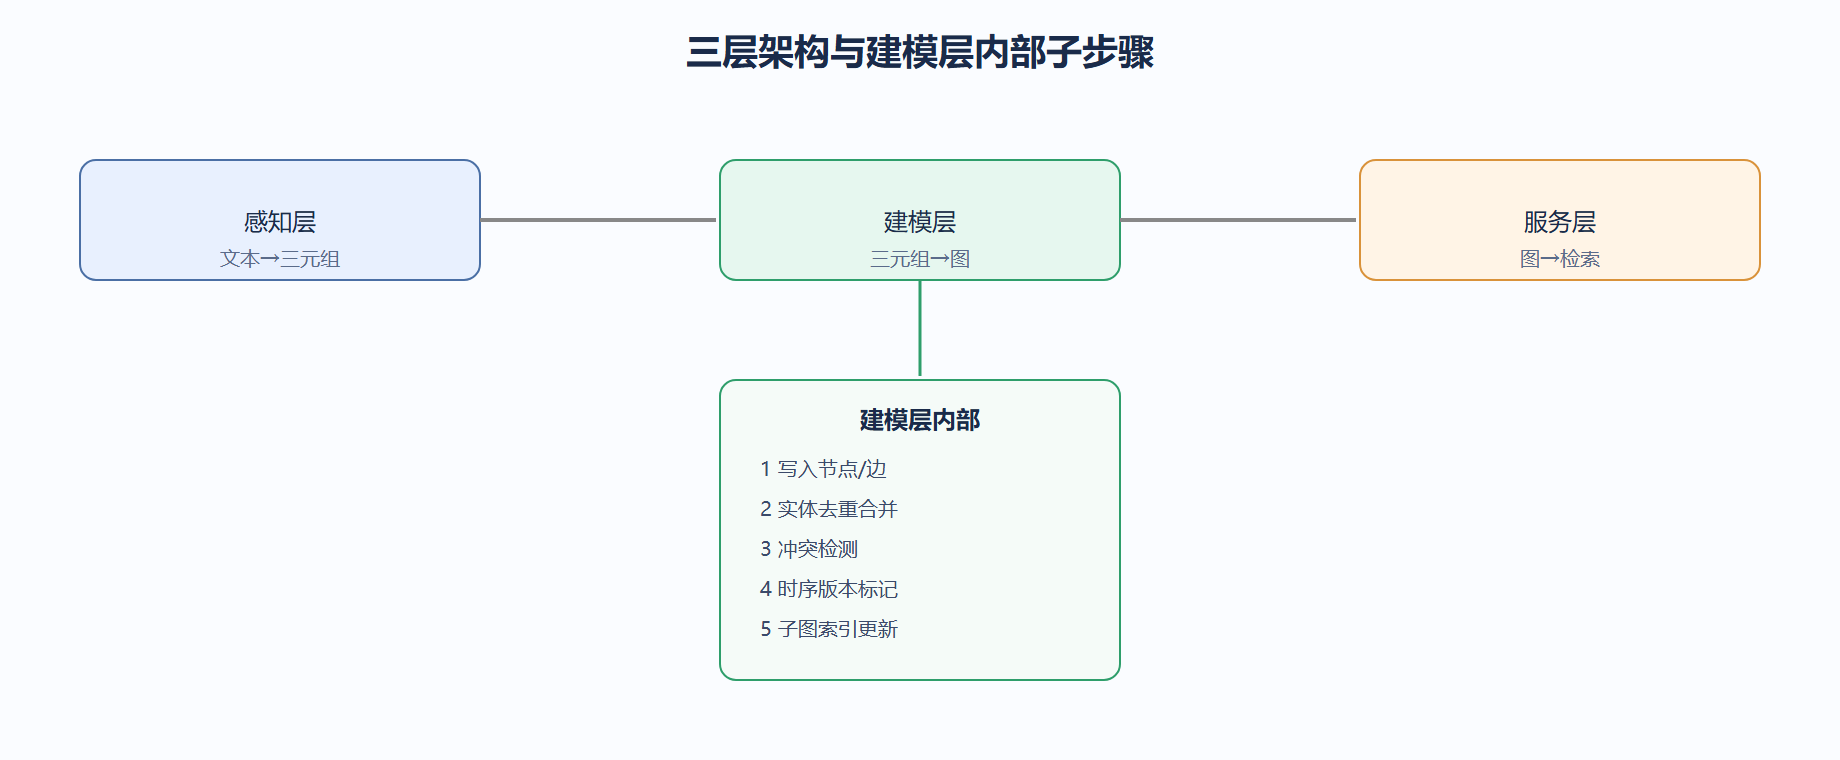
建模层把三元组写进图数据库,并做去重、冲突检测、时序标记。它不像向量库那样"写进去就完事",而是要判断"这个新关系和已有的是否冲突"。下图展示三层如何接力,以及建模层内部的子步骤。
服务层:把图变成答案
服务层提供查询接口,它做的不是单纯 Cypher 查询,而是"向量召回 + 图遍历 + 融合排序"。这点我们在 2.3 节细讲,这里先建立概念:你调用 cognee.search,服务层背后跑了两条检索路。
案例:一份财报的三层旅程
背景:一份 40 页年报,分析师想问"公司最大客户是谁,占比多少"。
操作:摄入后看三层各自产出。
import cognee await cognee.add("2023年报.pdf") await cognee.cognify() # 服务层: 建立向量索引 + 图索引 ans = await cognee.search("最大客户及占比") print(ans) # 'source':'2023年报.pdf#p18'}]
结果:答案沿"公司—最大客户—占比"关系链返回,并指回第 18 页。
解读:三层分工让问题被拆成"抽取关系→存图→沿关系查"。若用纯向量库,年报里"最大客户"和"占比32%"可能分在两页,相似度检索很难拼到一起。
变式:次年报发布,再次 add,建模层对新旧关系做时间标记,问"去年最大客户"和"今年最大客户"能分别作答——这是建模层时序能力的红利。
一个工程视角:层与层之间靠"契约"解耦
三层分工的价值,只有在"层间只通过明确接口通信"时才成立。感知层产出三元组、建模层消费三元组——它们之间不共享数据库密码、不互相读临时文件,只传递结构化三元组列表。类比到建筑:水电管道和承重墙各有规范接口,工人按接口施工,换施工队也不乱。一旦层间开始绕开契约直接耦合,三层就退化成意大利面。
# 层间契约示意:感知层只产出三元组,不碰图 def perceive(text) -> list[tuple]: # 只负责:文本 -> 三元组 return extract_triples(text) def model(triples) -> None: # 只负责:三元组 -> 图 write_to_graph(triples) # 两层通过 triples 这个契约连接,彼此不可见内部
Cognee 把这套契约固化成了流水线阶段,所以你能单独替换抽取模型(感知层)而不动图库(建模层)。
| 层 | 输入契约 | 输出契约 | 可替换点 |
|---|---|---|---|
| 感知层 | 原始文本 | 三元组列表 | 抽取模型/模板 |
| 建模层 | 三元组列表 | 图数据库状态 | 图库后端 |
| 服务层 | 查询请求 | 带出处的答案 | 检索融合策略 |
⚠️ 自定义时别图省事让感知层直接写图——这会破坏可重跑性,某一阶段失败就无法从断点续跑。
💡 判断架构健不健康,看"换掉任意一层的实现,上下层代码要不要改"。要改,就是耦合漏了。
一个排障视角:哪层出问题看哪层
三层模型不只是画图,还是排障地图。问答错了,先定位病在感知(抽错三元组)、建模(图结构乱)还是服务(检索权重偏)。定位错层,改代码就是瞎改。类比到建筑漏水——先分清水管漏还是屋顶渗,否则乱砸墙白费劲。
| 症状 | 病层 | 查法 |
|---|---|---|
| 关系本身错 | 感知 | 看抽取输出 |
| 节点重复/缺失 | 建模 | 看图结构 |
| 答对但慢 | 服务 | 看融合策略 |
⚠️ 别一错就调 LLM——若图里关系本来就对,调模型救不了检索层的权重问题。
💡 每层留一个"可观测点"(抽取日志、图统计、检索中间结果),定位能从分钟级降到秒级。
一个类比收尾:三层像城市的供水
感知层像水厂(把原水净化成可饮用标准),建模层像管网(把水送到每户并维护压力),服务层像水龙头(你拧开就拿)。任一层故障,整条链断。理解这层关系,你排障时自然知道从哪头查起。
⚠️ 别试图"优化水龙头"解决"水厂污染"——层没定位对,优化方向就反了。
💡 画一张你自己的三层图,标清每层现在的实现,架构讨论就有共同语言。
本节要点回顾
- 感知、建模、服务三层各管一段因果,出错边界清晰。
- 感知层靠提示模板约束模型输出三元组。
- 建模层负责去重与冲突检测,是图的心脏。
- 服务层融合向量与图两条检索路。
⚠️ 感知层模型别选太小,抽取错乱会在建模层放大成错误关系网。
💡 排查建图质量问题,先看感知层抽得对不对,再怀疑建模层逻辑。