2.2 知识表示与管理机制
2.2 知识表示与管理机制
图里的"人"到底长什么样
向量库里一段文本只是一串数字,丢了结构。Cognee 的图里,一个"实体"是带类型的节点,一条"关系"是带标签的有向边,还能挂属性。这一节我们钻进建模层,看知识在磁盘上、在查询时到底是什么形态。
理解表示机制,你才能回答"为什么同一个名字出现两次不会变成两个节点"——这关系到图谱干不干净。
节点、边、属性的存储形态
在图数据库里,实体通常存为带 label 的节点,关系存为带 type 的边。Cognee 给每个节点生成稳定标识(基于实体名+类型),用于去重。属性作为节点的键值对附在节点上。
# 知识表示示意:节点与边的结构 graph_node = { "id": "entity:云图科技:Company", # 稳定标识 = 类型+名称 "type": "Company", "name": "云图科技", "props": {"成立": "2020", "总部": "杭州"} } graph_edge = { "from": "entity:李明:Person", "to": "entity:云图科技:Company", "type": "创立", "props": {"时间": "2020"} }
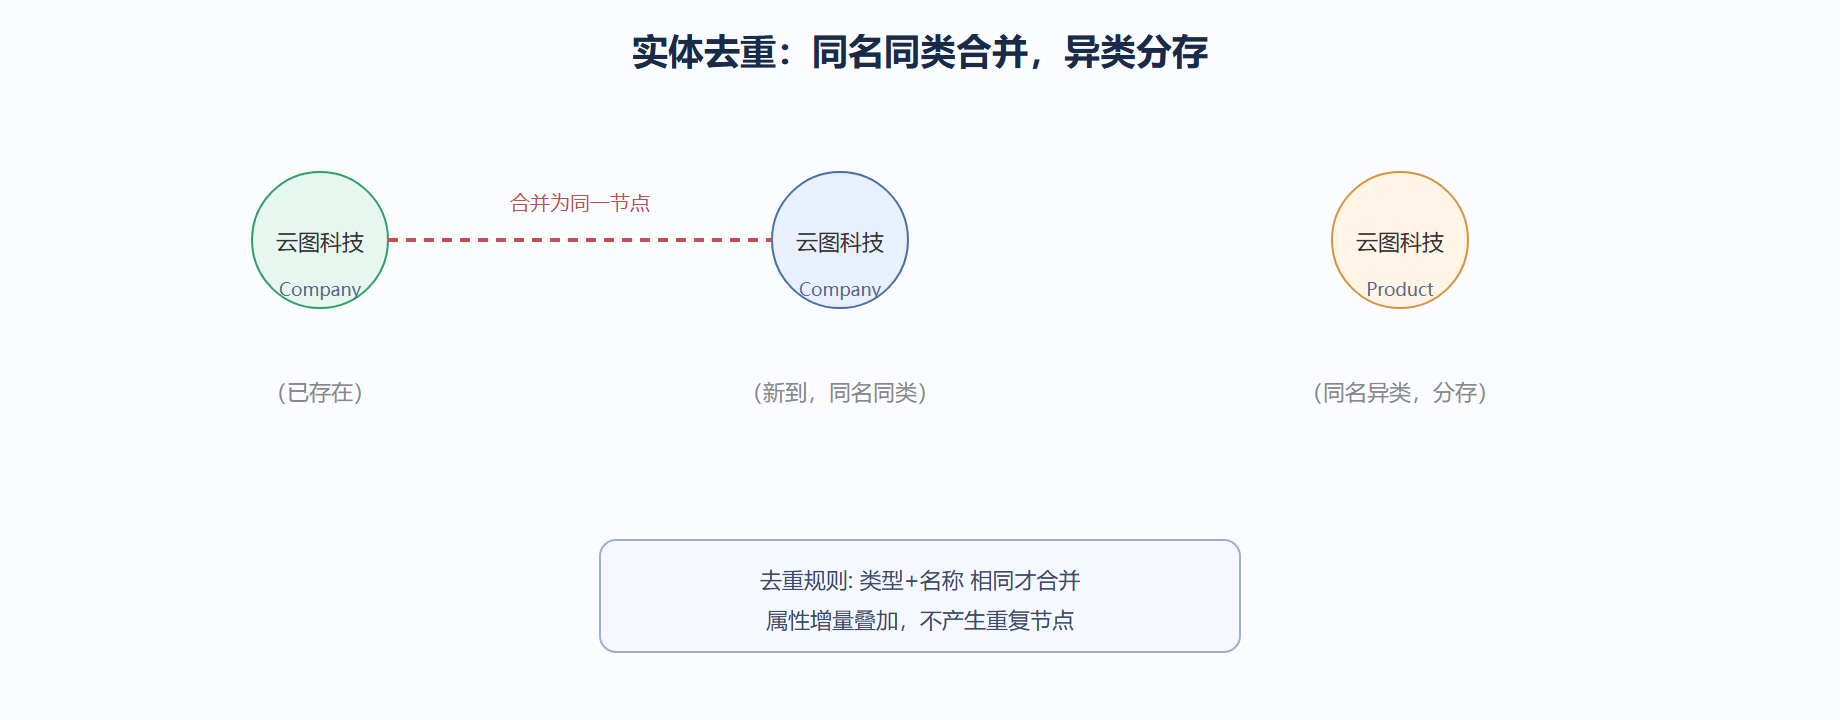
注意 id 的组成:类型+名称。这意味着"云图科技"作为 Company 和作为 Product 会被当成两个不同节点,避免歧义——一个公司和一个同名产品不该混为一谈。
实体去重:同名同类才合并
去重是建模层最容易被低估的一步。Cognee 不会见到"云图科技"就新建节点,而是先看是否已存在同类型同名的实体;若存在,就把新属性并上去,而不是复制节点。
冲突检测:新事实撞旧事实怎么办
当新文档说"云图科技总部在深圳",而旧图记的是"杭州",建模层不会默默覆盖,而是标记冲突,可选地引入时间维度。下面示意冲突裁决的两种策略。
# 冲突裁决示意 existing = {"总部": "杭州", "since": "2020"} incoming = {"总部": "深圳", "since": "2024"} # 策略A:时间版本链(保留两者) def merge_with_time(exist, new): return [exist, new] # 两版并存,查询时按时间取 # 策略B:标记矛盾,交由人工/规则 def flag_conflict(exist, new): return {"status": "conflict", "old": exist, "new": new} print(merge_with_time(existing, incoming)) # [{'总部':'杭州','since':'2020'}, {'总部':'深圳','since':'2024'}]
工程上我们更常用策略 A:给事实加生效时间,查询时按"当前时间"取最新版,历史问答仍可追溯。这正是 Cognee 相对普通知识库的"认知弹性"。
案例:并购文档的关系冲突
背景:A 公司先被记录"总部北京",半年后一份新闻稿写"总部迁至上海"。
操作:两次 add,看建模层如何处理。
import cognee await cognee.add("A公司简介.pdf") # 记录 总部=北京 await cognee.cognify() await cognee.add("A公司迁址新闻.pdf") # 记录 总部=上海 await cognee.cognify() ans = await cognee.search("A公司现在总部在哪") print(ans) # 'since':'2024', 'prev':'北京(since2020)'}]
结果:返回当前总部上海,同时保留旧值北京及时间,不丢历史。
解读:若用普通向量库,新旧两篇文档会各自被召回,模型可能混乱。图谱用时间维度把矛盾变成版本,干净。
变式:若你只想要单一真相(如合规场景),可切换策略 B,把冲突标记出来交人工裁定,避免自动采用未核实信息。
一个易错点:同名异义与同义异名
图干不干净,七成看去重。现实里"苹果"可能是公司也可能是水果,"云图科技"和"云图"可能指同一家。Cognee 靠"类型+名称"的稳定标识去重,但标识规则要你配合:类型定得准,去重才准。类比到生物分类——界门纲目科属种少定一级,两个物种就可能并错。
# 稳定标识如何避免"重名成俩节点" ids = { "entity:苹果:Company", # 公司苹果 "entity:苹果:Fruit", # 水果苹果 "entity:云图科技:Company", "entity:云图:Company", # 与上一条同名异写,需本体对齐 } # 若本体规定 Company 别名映射,云图->云图科技 合并为单节点
这就是第六章 6.3 实践一"本体先定"的底层原因:类型体系是去重的地基。
| 现象 | 后果 | 对策 |
|---|---|---|
| 同名异义未分型 | 公司/水果合并错 | 抽取时强制带类型 |
| 同义异名未对齐 | 同一实体变多节点 | 建本体别名表 |
| 属性当节点 | 图膨胀噪声 | 属性挂节点而非独立节点 |
⚠️ 别把"出现频率高"当成"是同一实体"的信号——高频词恰恰最容易是歧义词,要去重先消歧。
💡 图建完先跑一遍"同名节点检查":搜出所有 label 相同但 id 不同的候选,人工确认是不是该合并,比事后纠图便宜得多。
一个实例:属性挂错位置会误导检索
属性是键值对,但该挂节点还是挂边有讲究。把"成立年份"挂公司节点正确;但若挂成独立节点"2015"再连公司,图里就多出一个无意义的时间实体,检索时还会被当普通实体召回。保持"属性附主体"的纪律,图才干净。
| 信息 | 正确形态 | 错误形态 |
|---|---|---|
| 成立年份 | 公司节点属性 | 独立时间节点 |
| 关系置信度 | 边的属性 | 独立节点 |
⚠️ 别把一切元数据都建节点——节点越多,检索噪声越大,去重压力也越大。
💡 写抽取模板时列一张"属性白名单",明确哪些字段只能当属性,从源头阻止噪声节点。
本节要点回顾
- 实体存为带类型的节点,关系存为带标签的有向边,属性附在节点上。
- 去重依据"类型+名称",同名异类分存,同名同类合并。
- 冲突检测可走时间版本链或人工标记,视场景而定。
⚠️ 不要关掉冲突检测图省事,静默覆盖会让图谱在半年后变成不可信的状态。
💡 实体类型定义得越细(Company/Product/Person 分开),图谱歧义越少,建图前先想清楚本体。