2.4 数据流与控制流
2.4 数据流与控制流
一次 cognify 到底跑了多久
讲架构容易飘,这一节把"调用一次 cognee.cognify()"在时间轴上摊开,让你知道哪步慢、哪步能断点续跑。理解控制流,第五章做性能调优才有抓手。
数据流是"文档→片段→三元组→图→索引"的物料流向;控制流是"这些步骤按什么顺序、什么条件触发、失败了怎么回退"的指挥逻辑。
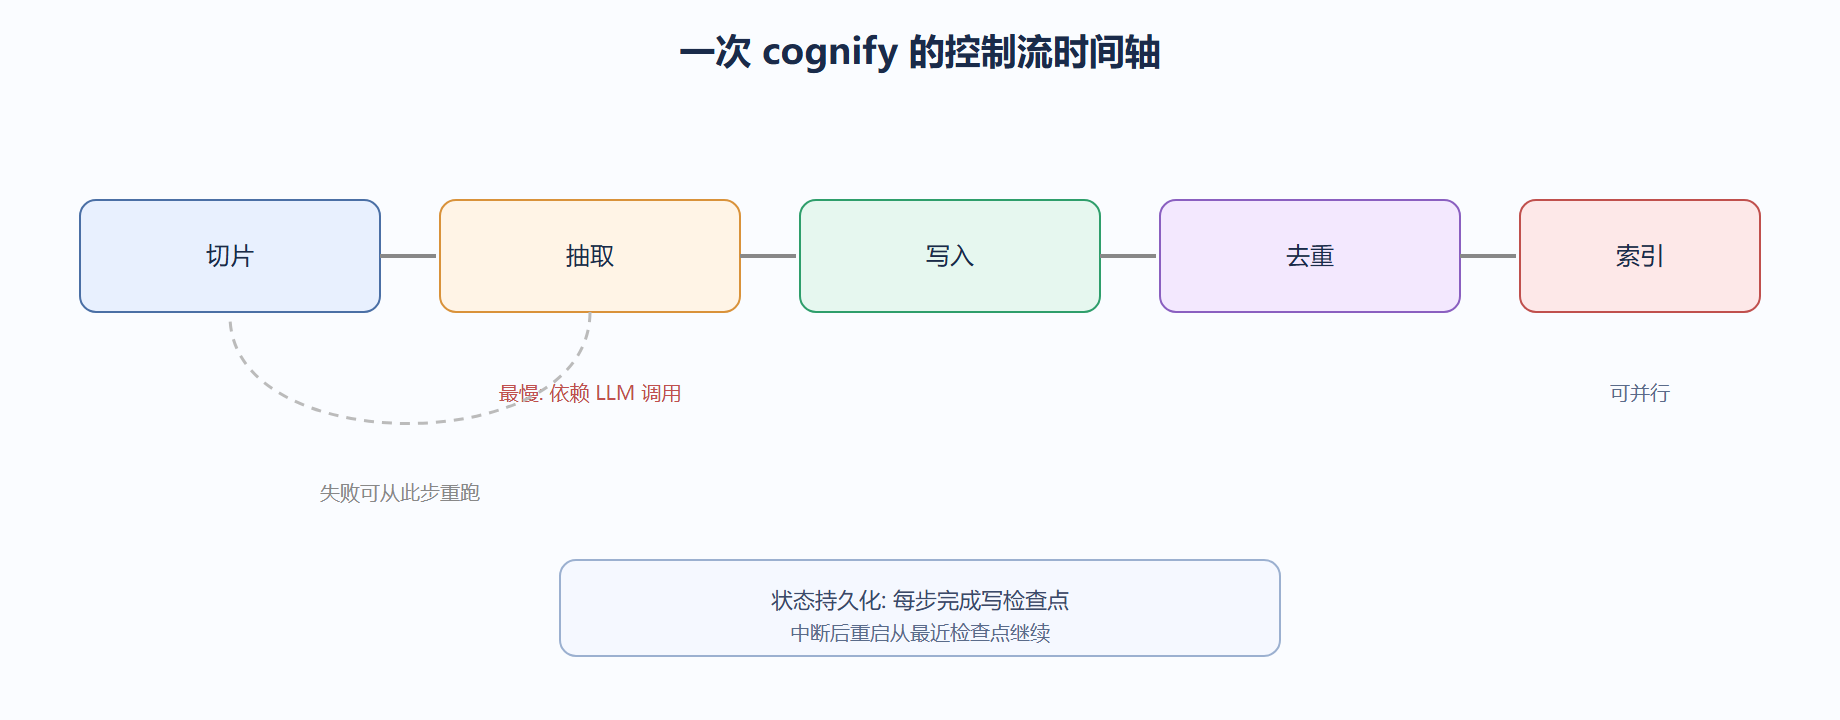
阶段顺序与可重跑点
一次完整建图大致分五步:切片、抽取、写入、去重、索引。任一步失败,控制流允许从失败点续跑,而不是从头再来——这对几百份文档的批量任务很关键。
控制流的并发与限速
抽取阶段要调 LLM,是瓶颈。Cognee 用并发+限速控制流:多个片段并行抽取,但限制每分钟调用数避免触发配额。下面示意限速逻辑(思想代码)。
# 抽取阶段的并发限速示意 import asyncio async def extract_with_limit(segments, semaphore, rpm_limit): # semaphore 控制并发,rpm_limit 控制速率 async def one(seg): async with semaphore: return await call_llm(seg) tasks = [one(s) for s in segments] return await asyncio.gather(*tasks) sem = asyncio.Semaphore(5) # 最多 5 个并发 results = await extract_with_limit(segments, sem, rpm_limit=60) print(f"抽取完成 {len(results)} 段") # 抽取完成 142 段(并发受控,未触发限流)
工程取舍在于:并发太高会被 LLM 服务商限流导致整批失败,太低则建图慢。第五章会讲怎么按你的配额调这个信号量。
数据流的两种形态:批与流
- 批处理:一次性
add一堆文档再cognify,适合初始化知识库。 - 流式:新文档到达即时
add+cognify,适合持续更新的场景。两者数据流相同,只是触发节奏不同。
案例:千份文档的断点续跑
背景:某团队首次建库要处理 1000 份 PDF,中途机器重启。
操作:依赖控制流的检查点机制,重启后无需从头。
import cognee, glob, asyncio files = glob.glob("./docs/*.pdf") for f in files: await cognee.add(f) await cognee.cognify() # 若中途崩溃,重启后再跑一次 # [索引] 重建完成
结果:第二次运行只处理失败的 280 份,总耗时从数小时降到几十分钟。
解读:控制流的检查点设计,让"大体量建图"从"赌一次成功"变成"可分段推进"。这正是数据流/控制流分离的工程价值。
变式:若想进一步提速,可把 cognify 改成流式,每 add 10 份就 cognify 一次,把长任务切成多个短任务,单点失败影响更小。
一个生产细节:断点续跑靠的是"状态标记"
前文说任一步失败可从断点续跑,背后机制是控制流给每个片段打处理状态(待处理/抽取中/已建图)。重跑时只捡"待处理"和"失败"的,已建图的跳过。类比到金融清结算——每笔交易有终态标记,对账时只重跑未终态的,已清算的不动。
# 断点续跑思想:按状态过滤待处理片段 def resume(batches): todo = [b for b in batches if b.status in ("pending", "failed")] for b in todo: try: cognify_batch(b) b.status = "done" except Exception: b.status = "failed" # 标记失败,下次仍能续跑 return todo
理解这点,第五章做性能调优时你就知道"重跑不是浪费"——它只补缺口,不重算全量。
| 状态 | 含义 | 续跑行为 |
|---|---|---|
| pending | 未处理 | 处理 |
| failed | 上次失败 | 重试 |
| done | 已建图 | 跳过 |
⚠️ 别在失败后手动删图再全量重跑——那等于放弃断点续跑的保护,几百份文档会重算很久。
💡 批量建图先小批验证,确认状态机正常再放大;一旦某批频繁 failed,先修抽取再续,而不是盲目重跑全库。
一个监控点:给每批建图记耗时分布
控制流理解后,生产要把"每批 cognify 的耗时"记下来,看是不是抽取阶段占大头、是不是某批异常慢。耗时分布能提前暴露限流或图库瓶颈,比用户投诉早。类比到金融清算——盯每笔耗时百分位,p99 飙了就有戏。
| 指标 | 用途 |
|---|---|
| 批次总耗时 | 容量规划 |
| p99 单片段 | 发现限流 |
| 失败率 | 健康度 |
⚠️ 别只盯平均耗时——平均被快批次拉平,p99 才是用户体验底线。
💡 把耗时埋点接监控,p99 连续上升就预警,比事后排查主动得多。
一个原则:控制流优先于数据流优化
性能调优常盯着数据"流得多快",但控制流的"何时触发、失败怎么回退"更决定稳定性。先保证控制流正确(可续跑、可回退),再谈数据流提速,顺序别反。
⚠️ 别在控制流还频繁失败时狂加并发——失败率一高,并发只是更快地产失败。
💡 调优前先跑一批看失败率,失败率压到接近零再加压并发。
控制流的分步调用:把 cognify 拆开
cognify 是五步的封装,但 Cognee 也允许按需分步执行:先切片、再抽取、再写入,每步之间可插入自己的质检逻辑。比如「抽取完先人工抽查 20 条,质量合格才写入图」——全量一把梭做不到的事,拆开后每条流水线都能独立验证、独立重跑。代价是失去一步到位的封装,需要自己在代码里维护各步之间的状态与产物位置,适合对抽取质量有硬要求的场景。理解这一点,你就知道控制流不只是「框架内部的事」,它同时是你在自定义流水线时可以利用的接缝。
本节要点回顾
- 数据流是物料流向,控制流是步骤顺序与失败回退逻辑。
cognify分五步,每步有检查点,可断点续跑。- 抽取是瓶颈,靠并发信号量+限速平衡速度与配额。
⚠️ 别在抽取阶段把并发开到最大。触发 LLM 限流会导致整批失败,反而更慢。
💡 大体量建库前先小批跑通,确认检查点机制生效,再放大到全量。