2.3 认知处理与推理模型
2.3 认知处理与推理模型
检索时图上发生了什么
前面说了 Cognee 产图,但图怎么帮回答?这一节讲清"图谱增强检索"在查询那一刻的运行机制:它不是把图当摆设,而是让图参与排序和补全。
核心机制是图遍历补全——向量召回一个种子实体后,沿关系走一两跳,把邻居也拉进上下文。这样答"张明的上司的上司是谁",不需要文档里明写,图上一走就有。
向量召回 + 图遍历的融合
纯向量检索给出"语义相近的片段";图遍历给出"关系相连的事实"。Cognee 把两者融合:先用问题向量召回最相关的实体作为种子,再沿边扩展邻居,最后一并送进 LLM 生成答案。
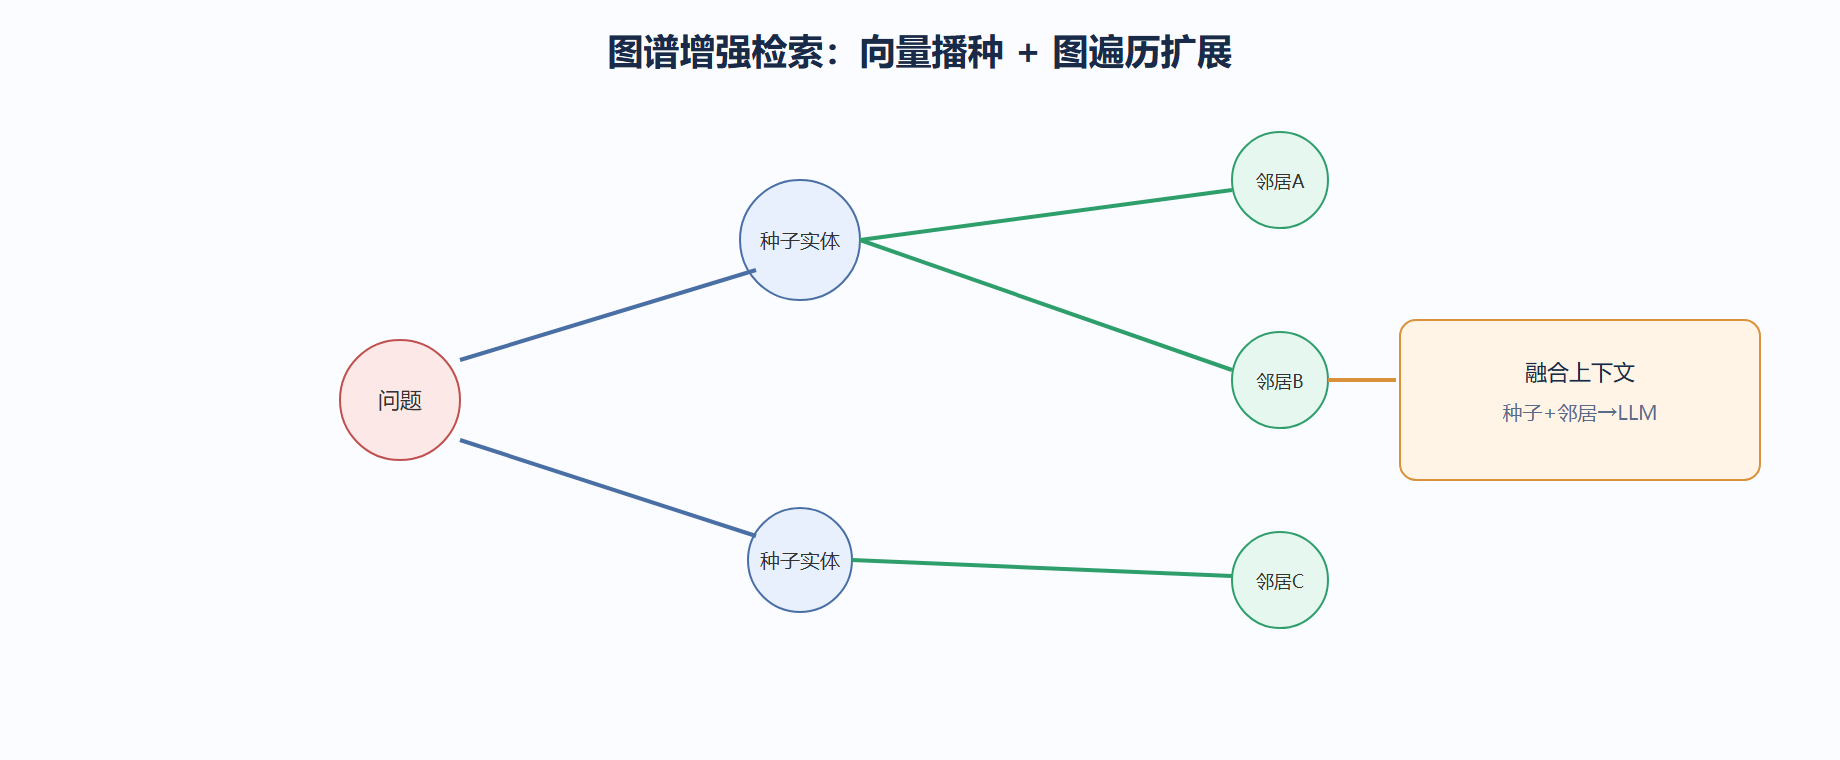
多跳推理胜过单跳相似
为什么图遍历能答多跳?看代码:给定"张明的上司",沿边再走一跳就能拿到"上司的上司"。向量库做不到这点,因为它不知道"上司"是个可继续走的边。
# 2.3 认知处理与推理模型 def multi_hop(start, relation, hops=2): results = [] cur = [start] for _ in range(hops): nxt = [] for node in cur: # 沿指定关系走一跳 nxt.extend(graph.neighbors(node, relation)) results.extend(nxt) cur = nxt return results print(multi_hop("张明", "上司", hops=2)) # ['部门经理', '总监'] # 张明的上司的上司
这不是玄学,就是图的邻接遍历。代价是图质量要好——关系抽错了,走出来的就是错的邻居。所以第四章建图时的抽取质量直接影响这里的推理上限。
认知推理的边界
我们要诚实:图遍历能处理"显式关系链",但处理不了需要世界知识的隐含推理。比如"公司营收下降可能预示裁员",这种靠常识的推断,图给不了,还得靠 LLM 自身。Cognee 的定位是把可结构化的关系显式化,不是替模型思考。
案例:组织架构的多跳问答
背景:HR 系统里存着汇报关系,员工想问"我的二级上级是谁"。
操作:把组织架构文档建图,再沿"上司"边走两跳。
import cognee await cognee.add("组织架构.md") await cognee.cognify() ans = await cognee.search("张明的二级上级是谁") print(ans) # 'answer':'韩梅','source':'组织架构.md#p1'}]
结果:答案是一条可验证路径,而不是模型猜的名字。
解读:向量库会把"张明""李雷""韩梅"三人的介绍分别召回,模型得自己拼关系,容易拼错。图谱直接给出路径,确定性高。
变式:若组织调整,李雷换汇报对象,把新架构 add 后图更新边,二级上级的答案随即变化,无需改查询代码——图结构变了,查询逻辑不变。
一个精度旋钮:图遍历走几跳
图遍历补全能答多跳,但跳数不是越多越好。走一跳覆盖直接邻居,走三跳可能把八竿子打不着的实体拉进上下文,反而稀释答案。类比到物理——测量精度有最佳量程,量程外误差反而大。实务里一跳到两跳是甜区,三跳以上要加关系类型过滤。
# 控制遍历深度的示意(思想) def traverse(seed, max_hops=2, allowed=None): frontier = {seed} for _ in range(max_hops): nxt = set() for node in frontier: for (rel, nb) in edges_of(node): if allowed is None or rel in allowed: # 只走允许的关系 nxt.add(nb) frontier |= nxt return frontier
Cognee 的 search 内部已经做了融合与截断,但你可以通过关系类型白名单进一步收敛,避免无关边污染。
| 跳数 | 覆盖 | 风险 | 适用 |
|---|---|---|---|
| 1 跳 | 直接邻居 | 低 | 单关系问答 |
| 2 跳 | 邻居的邻居 | 中 | 多数多跳 |
| 3+ 跳 | 更广 | 高(噪声) | 需关系过滤 |
⚠️ 别默认开最大跳数"让模型自己挑"——跳得越远,上下文中无关实体越多,token 和幻觉都涨。
💡 多跳问答调参先看"答案是否依赖第三跳",不需要就关掉,省下的上下文给真正相关的邻居。
一个对比:图增强 vs 纯向量,差在哪题
不是所有题图增强都赢。纯语义、单跳的"这段话讲了啥"向量库更顺;关系明确、需跨实体的"谁的上司的上司是谁"图才显优势。把两类题分开看,能避免"上了图反而更慢"的错觉——是题没选对,不是图不行。
| 题型 | 优胜 |
|---|---|
| 单跳语义摘要 | 向量 |
| 两跳以上关系 | 图增强 |
⚠️ 别用纯摘要题去测图增强的效——那种题图本就不擅长,测出劣势是预期内的。
💡 上线前把真实问题标类型,统计两类题各自的命中率,图增强的价值用多跳题说话才公平。
一个度量:多跳收益用"省下的阅读量"算
图增强值不值,可量化:原本要读五篇文档才能拼出的答案,现在一问即得,省下的就是价值。把"省阅读量"当指标,比"答得妙"实在,也方便向老板汇报投入产出。
⚠️ 别用"模型幻觉少"当唯一卖点——可追溯才是图增强区别于纯生成的核心,幻觉少是副产品。
💡 选几个真实多跳问题,记优化前需读几篇、优化后几秒,数字最有说服力。
推理质量的下游:实体消歧与关系方向
图遍历答得准不准,前提是同一个实体只有一个节点。「张明」「张先生」「Zhang Ming」若被抽成三个节点,多跳路径就断在歧义上。Cognee 在抽取后做实体消歧:按名称、别名、上下文把指向同一对象的节点合并;关系按有向边存储并标注方向语义——「上司」与「下属」方向相反,遍历时走错方向答案就反了。实践上维护一份领域别名表(如工号映射姓名),能显著提高合并准确率。这是把「关系抽取对了」推向「检索真能用」的最后一公里,第四章建图时的实体归一化配置也在这里起作用。
本节要点回顾
- 图谱增强检索 = 向量播种 + 图遍历扩展邻居 + 融合送 LLM。
- 多跳问题靠图的邻接遍历解决,向量库天然短板在此。
- Cognee 显式化可结构化关系,不替代 LLM 的常识推理。
⚠️ 图遍历的可靠性上限定于抽取质量。关系抽错,多跳走得越远错得越离谱。
💡 若发现多跳答案离谱,先回建模层查关系对不对,而不是怀疑遍历算法。