2.2 Task (任务)
2.2 Task (任务)
本节约处在第二章第二站。如果说 Agent 决定"怎么干",Task 就是"这次具体干什么、干成啥样算数"。我们反复强调:在多智能体系统里,Task 比 Agent 更该被精心对待,因为链路的错误几乎都从模糊的任务契约开始放大。
先建立 Task 的结构认知,它
先建立 Task 的结构认知,它对外有三个关键接口:
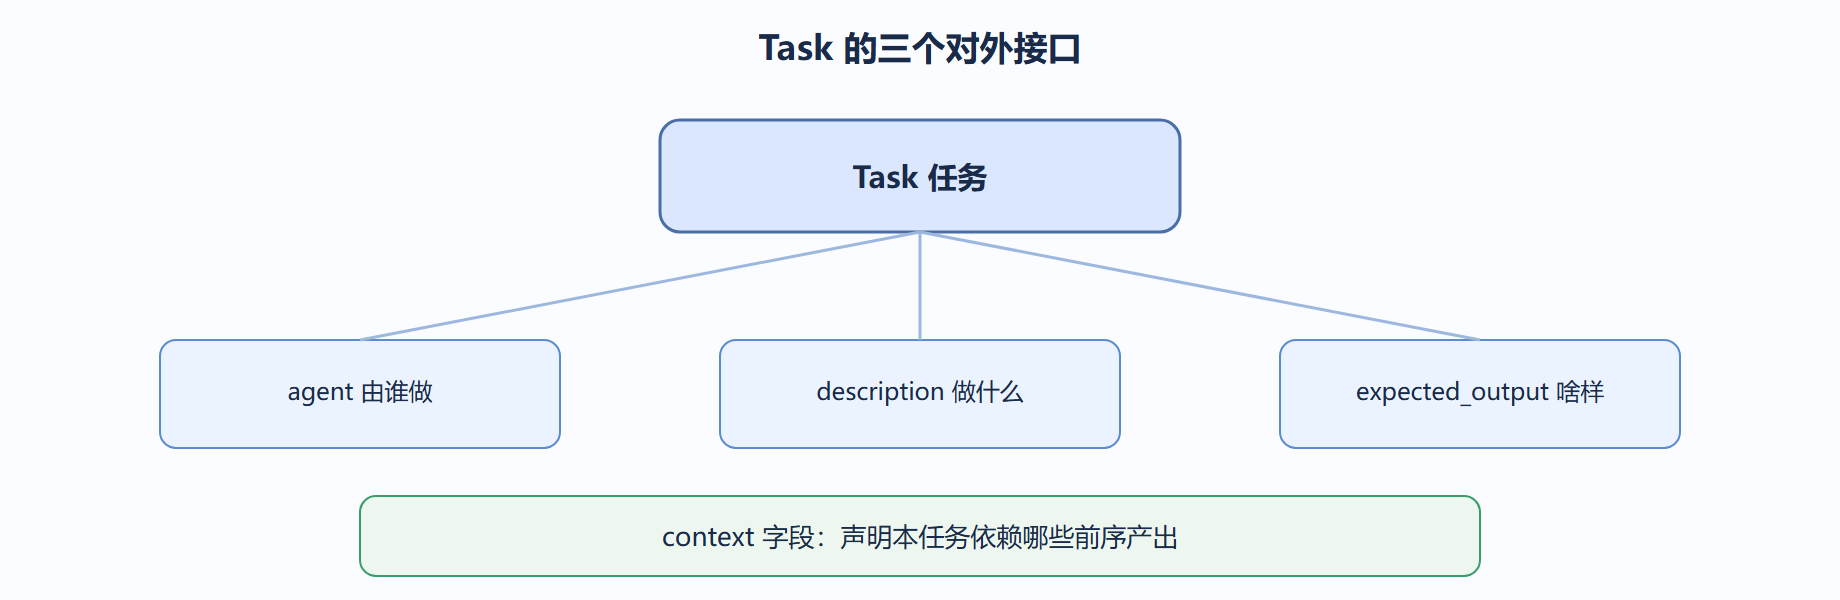
Task 的核心字段:
- description:自然
description:自然语言描述要做什么,支持{占位符}在 kickoff 时填值。expected_output:对产出的格式与内容要求,是验收标准,比 description 更该写细。agent:绑定执行者;不写则交由 Process 决定(层级模式下常见)。context:列出本任务依赖的前序 Task,框架会把那些 Task 的产出作为上下文传入。tools:可给单个任务临时附加工具,覆盖 Agent 默认工具集。async_execution:标记任务可异步,用于无依赖的并行分支。
一个常见错误是把验收标准写虚,比如 expected_output="一份报告"。下游拿到的是一份不知道结构的文本,后续解析必崩。正确写法要给定形态:
from crewai import Agent, Task analyst = Agent(role="分析师", goal="出结构化结论", backstory="严谨", verbose=True) # 差的写法:产出无结构,下游难消费 bad = Task(description="分析数据", expected_output="一份报告", agent=analyst) # 好的写法:把产出格式钉死 good = Task( description="分析 {data} 的月度趋势", expected_output="三个要点,每条含:现象、可能原因、建议动作,用换行分隔", agent=analyst, )
运行 good 时,模型知道要产出"三条带结构的要点",而不是自由发挥一段。我们建议每个 Task 的 expected_output 都能被下游用固定规则切分——这是多智能体系统能稳定串联的前提。
再演示 context 如何把两个任务连成链路。注意第二个任务不重复描述"分析什么",它直接消费第一个任务的产出:
from crewai import Agent, Task, Crew, Process researcher = Agent(role="研究员", goal="找事实", backstory="简洁", verbose=True) writer = Agent(role="写手", goal="成文", backstory="连贯", verbose=True) t_find = Task(description="搜集 {topic} 的三个事实", expected_output="三条事实,各带来源", agent=researcher) t_draft = Task( description="基于事实写一段说明", # 不重复说找什么 expected_output="两百字说明", agent=writer, context=[t_find], # 关键:消费 t_find 的产出 ) crew = Crew(agents=[researcher, writer], tasks=[t_find, t_draft], process=Process.sequential) # crew.kickoff(inputs={"topic": "固态电池"})
这里 context=[t_find] 是 CrewAI 表达依赖的核心语法。它和 Process.sequential 是配合关系:sequential 决定"先 t_find 后 t_draft"的顺序,context 决定"t_draft 的输入来自 t_find 的输出"。两者缺一,链路就断了。
还有一个细节:tools 可以在 Task 级覆盖。有些工具只该在特定任务用(比如写手不该有"删除文件"权限),就在 Task 上单独给,而不是塞进 Agent 全局:
from crewai_tools import SerperDevTool search = SerperDevTool() # 研究员需要搜索,写手不需要,因此工具分别挂 t_find = Task(description="搜 {topic} 新闻", expected_output="要点", agent=researcher, tools=[search]) t_draft = Task(description="写成段", expected_output="段落", agent=writer) # 无 tools
收尾提醒:Task 是链路的"契
收尾提醒:Task 是链路的"契约层"。我们见过太多系统把调试时间花在"为什么下游拿到的东西不对"——根因几乎都是上游 Task 的 expected_output 没写清,或者 context 漏配导致下游在凭空想象前序结果。把 Task 当接口文档来写,第二章后面的 Crew 与 Process 才能稳。
Task 的产出契约与依赖
Task 最容易被写糙的地方是 expected_output 太虚。我们把它当"接口契约"来写:产出格式、字段、长度都钉死,下游才好接。另一个关键是 context——它声明"这个任务依赖哪些任务的产出"。
| 字段 | 含义 | 写法建议 |
|---|---|---|
| description | 这次具体做什么 | 用动词开头,写清输入来自哪 |
| expected_output | 产出长什么样 | 给模板或字段清单,别写"一份报告" |
| agent | 由谁做 | 明确指派,别留空 |
| context | 依赖哪些 Task | 列表传入,形成数据链 |
| async_execution | 能否异步 | 互不依赖的任务设 True 提速 |
⚠️ 常见坑:description 里写 {topic},但 kickoff 没传 inputs,启动即 KeyError。所有占位符必须在 inputs 里给全。另一个坑是 context 传的是 Task 对象本身,不是它的字符串结果——CrewAI 会自动把上游产出喂给下游。
from crewai import Agent, Task writer = Agent(role="写手", goal="写稿", backstory="利落", verbose=True) t_draft = Task( description="围绕 {topic} 写 800 字初稿", expected_output="含标题、三段正文、一句收尾的初稿", # 钉死格式 agent=writer, ) t_proof = Task( description="核对初稿中的事实", expected_output="标注每条事实是否可核实", agent=writer, context=[t_draft], # 依赖上一步的初稿 ) inputs = {"topic": "固态电池"} # 占位符必须给全 print(t_draft.description.format(**inputs))
💡 关键直觉:Task 是 Crew 里最该被测试的对象。角色差一点,模型还能靠通用能力补;但 Task 的产出格式虚了,下游拿到的就是不可用的半成品,错误沿链路放大。所以写 Crew 时先花力气定死每个 Task 的 expected_output,再谈角色怎么配。
# 互不依赖的任务可并行,用 async_execution 提速 t_a = Task(description="任务A", expected_output="a", agent=writer, async_execution=True) t_b = Task(description="任务B", expected_output="b", agent=writer, async_execution=True)